Binlerce ayrıştırma kütüphanesi var. Web sitelerinden HTML'yi ayrıştırmak için en iyileri hangileridir?
Web sitenizde içerik görüntülemek için HTML'yi nasıl kullanacağınızı zaten biliyor olabilirsiniz, ancak herhangi bir kod yazmadan ihtiyacınız olan verileri ayıklayabileceğiniz araçlar olduğunu biliyor muydunuz? Bu kütüphaneler, sayfa başlıklarını ve meta açıklamalarını almaktan resimleri, bağlantıları ve hatta telefon numaralarını ve e-posta adreslerini tanımlamaya kadar her şeyi, sizden çok az çaba gerektirerek ya da hiç çaba gerektirmeden halleder.
Bu makale, en iyi veri ayrıştırma kütüphanelerini ele almakta ve hangi tür içerikleri ayrıştırmaya çalıştığınıza ve web sitenizin hangi programlama dilini kullandığına göre öneriler sunmaktadır.
Ayrıştırma nedir?
Ayrıştırma, sözdizimsel analiz ya da bir cümlenin parçalarını – ya da bizim durumumuzda – bir kod dizisini analiz etme sürecinin başka bir adıdır. HTML ayrıştırması yapıyorsanız, bir web sayfasındaki etiketleri ve öğeleri analiz ediyor ve bunlardan veri çıkarıyorsunuz demektir.
HTML'yi ayrıştırmak nedir?
Hipermetin İşaretleme Dili (HTML), web sitesi metinlerini biçimlendirmek için kullanılan bir bilgisayar dilidir. Geliştirici modunda olmadığınız sürece bunu göremezsiniz, ancak HTML arka planda çalışarak ziyaret eden bilgisayarlara web sayfası metninin nasıl görüntüleneceği konusunda talimatlar verir.
Ayrıştırıcılar, HTML satırlarını daha küçük parçalara ayırır ve bunlara ait oldukları kategoriye göre etiketler atar. Kullandığınız ayrıştırma kütüphanesine bağlı olarak, farklı etiketleme sistemleri kullanabilir ve farklı web sitesi programlama dillerinden HTML kodlarını ayrıştırabilirsiniz.
Web kazıma işlemlerinde oldukça kullanışlıdırlar; çünkü büyük ve okunması zor web sitelerini daha kolay sindirilebilir parçalara ayırmanıza olanak tanırlar. En sevdiğiniz mağazaların nasıl çalıştığını anlamaya çalışıyorsanız, başlangıç noktası olarak bu mağazaların HTML kodlarına bir göz atmayı deneyin.
Ayrıştırma kütüphaneleri nedir?
Ayrıştırma kütüphaneleri, web verilerini okumak, analiz etmek ve düzenlemek için kullanılan çerçevelerdir. Bunlar, kod satırlarını çeşitli değerli çıktılara dönüştüren anahtarlar gibidir. Örneğin, C# ile oluşturulmuş bir web sitesinden veri toplamak ve işlemek için bir C# ayrıştırma kütüphanesine ihtiyacınız vardır.
Aşağıda, web veri toplama sırasında karşılaşabileceğiniz en yaygın programlama dillerinden bazıları için (Java, Python, C# ve JavaScript dahil) sözdizimi çözümleme kütüphanelerini inceliyoruz.
Java'da HTML'yi ayrıştırma.
Çoğu geliştirici, Java'nın API'ler ve arka uç sistemleri oluşturmak için yaygın olarak kullanılan bir dil olduğunu bilir; ancak çok azı, bu dilin ayrıştırıcılar yazarken de oldukça kullanışlı olduğunu fark edebilir. Şu anda Jsoup, Lagarto ve HTMLCleaner gibi çeşitli Java ayrıştırma kütüphaneleri geliştirilme aşamasındadır. Artık Java sözdizimi bilgilerinizi kullanarak C# ve Node.js ile web veri toplama işlemleri gerçekleştirebilirsiniz. Her biri, büyük ölçekli uygulamalar geliştiren geliştiriciler için kendine özgü avantajlar sunar.
Jsoup
Jsoup, gerçek web sayfalarıyla çalışmaya yönelik bir Java kütüphanesidir. En iyi DOM, CSS ve jQuery benzeri yöntemleri kullanarak verileri ayıklamak ve işlemek için kullanışlı bir API sunar.
Jsoup, jsoup.dom üzerine HTMLParser’ı sıfırdan uygular. Bu ayrıştırıcıyı Xpath, JQuery vb. gibi diğer popüler çerçevelerle birlikte kullanabilirsiniz. Bir web sayfası üzerinde yazarken, sayfayı kolayca bir XML belgesine dönüştürebilir, içinden öğeleri ayıklayabilir ve birkaç satır kodla içeriğini daha fazla işleyebilirsiniz.
Lagarto
Lagarto, bir veri çıkarma aracı ve web tarayıcısıdır. Hem Java hem de JavaScript uygulamalarına sahiptir. HTML, XML, CSV, JSON ve OpenDocument Spreadsheet dosyalarından veri çıkarabilir. Lagarto, yapılandırılmamış içerikten bilgi çıkarımı üzerinde tam kontrol sahibi olmak isteyen geliştiriciler içindir. Tasarımdaki temel hedefler, performans veya doğruluktan ödün vermeden basitlik ve geliştirme hızıydı. Lagarto’nun düşük giriş eşiği, sınırlı ayrıştırma deneyimine sahip geliştiricilerin, düzenli ifadeler veya CSS seçicileri konusundaki mevcut bilgilerini kullanarak özel giriş biçimleri için kendi ayrıştırıcılarını oluşturmalarına ve hatta sıfırdan yepyeni giriş biçimleri yaratmalarına olanak tanır.
HTMLCleaner
HTMCleaner, HTML’den veri çıkarmak için CSS benzeri bir sözdizimi kullanan bir web içeriği ayrıştırıcısıdır. HTMCleaner’ı kullanarak belgeleri çeşitli yararlı şekillerde ayrıştırabilir, değiştirebilir ve yeniden ayrıştırabilirsiniz. Lagarto veya Jsoup ile karşılaştırıldığında, HTMCleaner özel ayrıştırma için bir API sunmaz; yalnızca HTML kaynak kodundan veri çıkarmaya yöneliktir (ancak yöntemleri DOM API’sine daha yakındır). Bu özellik, ayrıştırma süreci üzerinde DOM API’sini kullanmaktan daha fazla kontrol gerektiren geliştiriciler için bir avantaj olabilir. HTMLCleaner’ın temel amacı, sunum ile yapı (HTML) arasında bir ayrım sağlarken kolay içerik çıkarma imkanı sunmaktır. Bu, mevcut belge yapısına dayalı olarak sunum katmanınızı oluşturabileceğiniz anlamına gelir.
Python'da HTML'yi ayrıştırma.
Günümüzde en popüler Python ayrıştırma kütüphaneleri Scrapy, Beautiful Soup ve lxml’dir. Her birinin kendine özgü güçlü ve zayıf yönleri vardır; ihtiyaçlarınıza göre bunlardan birini seçmeniz gerekecektir. En uygun seçenek, sitenizin hangi dillerde yazıldığına, ne kadar dinamik olduğuna, kaç sayfa taramanız gerektiğine vb. faktörlere bağlı olacaktır.
Scrapy
Scrapy, güçlü ve hızlı bir araçtır; Python, Java ve Ruby gibi birçok programlama dilini destekler, ancak web veri toplama konusunda yeniyseniz, Scrapy için bir örümcek yazmak biraz zor olabilir.
Güzel Çorba
Beautiful Soup, düzenli ifadeler kullanarak bir HTML sayfasından veri çıkarmak için basit bir yol sunduğu için yeni başlayanlar için mükemmeldir. Üstelik, Beautiful Soup’un arkasında destek almayı kolaylaştıran aktif bir topluluk bulunmaktadır.
LXML
Daha esnek bir çözüm arıyorsanız, lxml mükemmel bir seçenektir. Bu, hızlı ayrıştırma için XPath ve CSS seçicileri kullanan, C diline dayalı bir web kazıyıcı ayrıştırıcısıdır. Siteniz PHP veya ASP gibi dillerde oluşturulmuşsa, lxml iyi bir seçim olabilir. Beautiful Soup kadar kolay olmasa da, standart yeteneklerinin ötesinde bir şey elde etmeniz gerekiyorsa lxml için özel kurallar yazabilirsiniz. Üstelik Nokogiri ile sorunsuz bir şekilde entegre olur, bu da onu Beautiful Soup'tan daha güçlü ve çok yönlü hale getirir. Ancak bunun bir bedeli vardır: BS veya Scrapy'ye kıyasla önemli ölçüde daha yavaştır ve öğrenmesi daha zordur.
Web veri kazıma konusunda yeniyseniz, önce Beautiful Soup’u denemenizi öneririz. Daha sonra, daha hızlı ve gelişmiş bir çözüme hazır olduğunuzda Scrapy’yi deneyin. (Belirli bir iş gereksinimi nedeniyle) bir XML belgesiyle çalışmaktan başka seçeneğiniz yoksa, bir XML ayrıştırıcısı kullanmak işleri kolaylaştıracaktır.
C#'da HTML'yi ayrıştırma.
C# için bir HTML ayrıştırıcısına ihtiyaç duyduğunuzda, elinizde sadece birkaç seçenek olduğunu ve bunların hepsinin birbirinin yerine kullanılabileceğini belirtmek önemlidir. Modern web sayfalarıyla çalışıyorsanız, bu kütüphanelerden birinin herhangi bir sorun ya da zorluk yaşamadan işinize yarama ihtimali yüksektir. İşiniz, ASP Classic veya hatta JSP kullanılarak oluşturulmuş olanlar gibi eski web sitelerinden veri madenciliği yapmaksa, işler biraz daha karmaşık ve ne yazık ki zahmetli hale gelir.
AngleSharp
AngleSharp, 1.4.4 sürümünde olan nispeten yeni bir açık kaynak projesidir ve hem web istemcileri hem de Windows masaüstü uygulamaları için platformlar arası destek sunar. Aktif olarak güncellenmekte olup, sağlam bir işlev setine sahiptir ve kullanımı kolay bir API ile birlikte gelir.
Bununla birlikte, AngleSharp hâlâ Silverlight veya JSP gibi eski platformlar için destek sunmamaktadır ve diğer kütüphanelerin sunduğu bazı ek özelliklere sahip değildir. Örneğin, çerçeve içinde XML için herhangi bir yerleşik işleme özelliği sunmamaktadır; bu da, uygulamanız için bu özellik hayati önem taşıyorsa, bu konuyu halletmek için başka bir ayrıştırıcıya ihtiyacınız olacağı anlamına gelir.
HtmlAgilityPack
HtmlAgilityPack, birçok açıdan AngleSharp’a benzemektedir. Platformlar arasıdır, aktif olarak güncellenmekte ve geliştirilmektedir. Ayrıca, kullanımı kolay bir API aracılığıyla erişebileceğiniz birçok işlev ve hizmet sunmaktadır. Tek gerçek sorunu, belgelerinin AngleSharp’ınkinden daha yetersiz olmasıdır; bu da, ayrıştırma kütüphaneleri konusunda deneyimi olmayan yeni kullanıcıların her şeyin nasıl işlediğini anlamasını zorlaştırmaktadır. Bunun yanı sıra, XML işleme gibi ekstra özellikler de sunmaz. Bu, aynı anda birden fazla kaynaktan gelen verilerle çalışmak istiyorsanız XML için başka bir ayrıştırıcıya ihtiyacınız olacağı anlamına gelir. Bunun dışında HtmlAgilityPack, diğer hemen hemen her şeyi AngleSharp kadar iyi ya da daha iyi yapar ve sağlam bir C# HTML ayrıştırıcısı arıyorsanız kesinlikle göz atmaya değer bir seçenektir.
JavaScript'te HTML'yi ayrıştırma.
jQuery
jQuery, HTML öğelerini son derece anlaşılır bir şekilde seçmenize, bulmanıza ve değiştirmenize yardımcı olur. jQuery’yi oldukça hızlı bir şekilde kullanmaya başlayabilirsiniz; jQuery deneyiminiz varsa, sahip olduğunuz bilgileri C#’a aktarmak kolaydır. Bazı işlevler, jQuery’nin yerleşik yöntemlerine kıyasla biraz daha fazla çaba gerektirir, ancak işte bu noktada ayrıştırma kütüphaneleri devreye girer!
Node.js
Node.js, Chrome üzerine kurulu bir platformdur ve JavaScript kodlarını tarayıcı ortamı dışında çalıştırmanıza olanak tanır; bu da komut satırı araçları oluşturmanıza veya web sitelerinden veri ayıklamanıza yardımcı olabilir. Bilgisayarınızda bir web sitesi çalıştırmak için harikadır, ancak Facebook veya Amazon gibi harici sunucularda çalışan kodları ayıklamak için pek uygun değildir.
Bu durumlarda, Java ile sunucu tarafında web veri kazıma işlemi yapabilen bir API’ye ihtiyacınız olacak. Hem web veri kazıma hem de işletim sistemi bilgilerinin toplanması ve filtrelenmesi (örneğin, verilerin kaynağına göre filtrelenmesi) gerekiyorsa, Htmlparser2 ideal bir seçimdir. Esneklik ve yüksek performans sunar. İşlevlerinden biri de çeşitli üçüncü taraf kütüphanelere erişim imkanı sunarak, bir sorunun birden fazla çözüm yolu olabileceği durumlarda veri işleme için kullanışlı hale getirir.
Cheerio
jQuery’den farklı olarak Cheerio, çok daha yalın bir çerçeve olup, istediğiniz görevlerin çoğunu yerine getirmek için daha az kod yazmanızı gerektirir. Çok fazla özellik içermese de, önbellekleme desteğine sahip asenkron bir Ajax motoru (çok kullanışlı), geri çağırma işlevlerinin ve olay işleyicilerinin kolayca eklenmesi gibi özellikler sunar. Hızlı ama güçlü bir çözüm arıyorsanız, bu hafif çerçeve iyi bir seçim olabilir.
Tüm bunların yanı sıra, kullanıcıların verilere gerçek zamanlı olarak filtre uygulayabilmelerini sağlayan istemci tarafında şablonlama desteği de sunmaktadır. Şablonlarda CSS seçicilerini işlemek için eklentiler mevcuttur; böylece kullanıcılar çıktılarını ilgili şekillerde kolayca biçimlendirebilir ve çoğu ayrıştırma kütüphanesi ile uyumlu hale getirebilirler.
Veri toplama işlemini kolaylaştırmak için proxy rotasyonu.
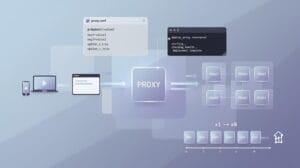
Tek bir ev tipi proxy ile bazı web veri toplama işlerini gerçekleştirebilmenize rağmen, birden fazla proxy gerektiren pek çok durum vardır. Çok sayıda URL’ye erişmeniz veya farklı dahili arama motorlarında sorgu yapmanız gerekiyorsa, birden fazla proxy kullanmak, veri toplama işleminizin site genelinde bir engellemeye yol açmamasını sağlar. Bir başka senaryo ise, aynı hedeften sürekli olarak veri toplamanız gerektiği durumdur. Proxy rotasyonu, her seferinde yeni bir IP adresinden istek göndererek engellemelerin tetiklenmesini önlemeye yardımcı olur.
En hızlı ve en güvenilir ev tipi proxy’lerin yüksek kaliteli IP rotasyonu için IPBurger ekibiyle iletişime geçin.
Engellenmekten ve yasaklanmaktan bıktınız mı?
İşletmenizde engellemelerden, yasaklamalardan ve captcha'lardan kaçınmak için proxy'leri nasıl kullanacağınızı ayrıntılı olarak anlatan ücretsiz kılavuzu edinin.
Ücretsiz Kılavuzu Hemen Gönderin!