Les blocages liés au web scraping sont vraiment pénibles. On est en train de collecter toutes les données dont on a besoin, et l'instant d'après, on se retrouve face à un message d'erreur.
C'est frustrant, n'est-ce pas ?
Les sites web parviennent de mieux en mieux à détecter les activités de scraping et à y mettre fin rapidement. Ce n’est pas seulement un désagrément mineur : cela peut compromettre l’ensemble de votre projet. Études de marché, analyse de la concurrence, agrégation de données… tout s’arrête.
Mais ne t'inquiète pas.
Il existe des moyens de contourner ces blocages et d'assurer le bon déroulement de vos sessions de scraping.
Tout d'abord, les proxys rotatifs. Ceux-ci peuvent vous aider à échapper au bannissement en changeant constamment votre adresse IP, ce qui complique la tâche des sites web pour détecter vos activités de scraping. C'est un peu comme si vous changiez de déguisement toutes les quelques minutes : vous êtes bien plus difficile à repérer !
Ensuite, imitez le comportement humain. Les bots ont tendance à envoyer des requêtes rapides et répétitives, ce qui les trahit immédiatement. Ralentissez votre processus de scraping. Ajoutez des délais aléatoires entre chaque action. Simulez les mouvements et les clics de souris. Ainsi, votre processus de scraping ressemblera davantage à celui d'une personne réelle.
L'utilisation de proxys résidentiels peut également changer la donne. Contrairement aux proxys de centres de données, les proxys résidentiels utilisent des adresses IP provenant d'appareils réels, ce qui leur confère une apparence plus légitime et réduit le risque d'être signalés.
Il y a ensuite la rotation de l'User-Agent. Les sites web bloquent souvent les bots en détectant la chaîne User-Agent dans les en-têtes HTTP. En faisant tourner ces en-têtes, vous pouvez faire croire que votre bot provient de plusieurs navigateurs et appareils différents.
Enfin, gérez la fréquence de vos requêtes. Envoyer trop de requêtes trop rapidement est le meilleur moyen de se faire bloquer. Mettez en place une limitation de fréquence pour passer inaperçu.
Prêts ?
Examinons ces stratégies plus en détail afin de garantir la continuité de votre collecte de données.
Comprendre les blocages liés au web scraping
Le « web scraping » désigne le processus consistant à extraire automatiquement des données de sites web à l'aide de scripts logiciels. C'est un outil puissant pour collecter des informations, mais de nombreux sites web s'efforcent activement de bloquer les robots de scraping. Pourquoi ?
Pourquoi les sites web bloquent-ils les robots de collecte de données ?
Les sites web bloquent les robots de collecte de données pour plusieurs raisons :
Charge du serveur: le scraping automatisé peut submerger un serveur de requêtes, ce qui ralentit le site pour les utilisateurs lambda. Imaginez des dizaines de robots qui bombardent un site en même temps ; cela peut mettre le serveur à genoux.
Protection des données: les sites web souhaitent protéger leur contenu et leurs données contre toute copie non autorisée. Les données exclusives constituent une véritable mine d'or, et personne ne souhaite qu'elles soient récupérées gratuitement.
Confidentialité des utilisateurs: les robots de collecte de données peuvent parfois recueillir des informations personnelles, ce qui soulève des questions en matière de confidentialité. Personne ne souhaite que ses données soient collectées sans son consentement, n'est-ce pas ?
Application des règles: les sites web disposent de conditions d'utilisation qui interdisent souvent le « scraping » automatisé afin de garder le contrôle sur l'utilisation de leurs données. Il s'agit de garantir l'équité et la sécurité de l'environnement en ligne.
Comment les sites web détectent-ils et bloquent-ils les « scrapers » ?
Blocage d'adresses IP
De quoi s'agit-il ?: Les sites web surveillent les adresses IP à l'origine des requêtes. Si une adresse IP envoie trop de requêtes en peu de temps, elle est signalée et bloquée.
Pourquoi ça marche: cette méthode est efficace car la plupart des robots de collecte de données opèrent à partir d'une seule adresse IP ou d'une petite plage d'adresses. C'est un peu comme repérer un spammeur en remarquant qu'il envoie 50 e-mails en une minute.
Détection de l'agent utilisateur
De quoi s'agit-il? Chaque requête envoyée à un site web comprend une chaîne « User-Agent » qui identifie le navigateur et le système d'exploitation. Les robots d'extraction utilisent souvent des chaînes « User-Agent » par défaut, voire n'en utilisent pas du tout, ce qui les rend faciles à détecter.
Pourquoi cela fonctionne: la détection et le blocage des chaînes « User-Agent » inhabituelles aident les sites à faire la distinction entre les utilisateurs humains et les robots. Les robots ont des indices qui les trahissent, tout comme au poker.
Limitation du nombre de requêtes
De quoi s'agit-il? : Les sites web limitent le nombre de requêtes qu'une même adresse IP ou un même User-Agent peut effectuer au cours d'un laps de temps donné.
Pourquoi ça marche: en limitant le nombre de requêtes, les sites peuvent ralentir ou bloquer les robots de collecte de données sans perturber les utilisateurs lambda. C'est un peu comme un videur qui veille à ce que le bar ne soit pas trop bondé.
Comprenez ces méthodes.
Sachez ce qui provoque les blocages.
Vous pourrez ainsi mieux planifier vos activités de scraping.
Nous allons maintenant nous pencher sur des techniques spécifiques permettant de contourner ces obstacles.
Restez à l'écoute.
Techniques efficaces pour éviter les blocages liés au web scraping
Utiliser des proxys rotatifs
L'un des moyens les plus efficaces d'éviter les blocages liés au web scraping consiste à utiliser des proxys rotatifs. Voici comment ils fonctionnent et pourquoi ils sont utiles.
Que sont les proxys rotatifs?
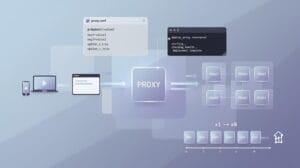
Les proxys rotatifs mettent à disposition un ensemble d'adresses IP qui changent à intervalles réguliers ou après chaque requête. Au lieu d'envoyer toutes vos requêtes depuis une seule adresse IP, qui peut facilement être signalée et bloquée, les proxys rotatifs répartissent vos requêtes sur plusieurs adresses IP.
Plus difficile à détecter.
Comment la rotation des proxys permet d'éviter les blocages d'adresses IP
Répartition des adresses IP: en alternant les adresses IP, vous simulez le comportement de plusieurs utilisateurs accédant au site depuis différents endroits. Cette dispersion complique la tâche des sites web pour identifier des schémas récurrents et imposer des interdictions.
Risque de détection réduit: grâce aux proxys rotatifs, chaque requête semble provenir d'un utilisateur différent. Cela permet d'éviter de déclencher les limitations de débit et les blocages d'adresses IP généralement mis en place pour empêcher les requêtes excessives provenant d'une seule adresse IP.
Gestion des CAPTCHA: Certains services de proxys rotatifs avancés peuvent aider à contourner les CAPTCHA en répartissant les requêtes de manière à réduire le risque de déclencher des CAPTCHA.
Avantages de l'utilisation de proxys rotatifs pour le web scraping
Taux de réussite accrus: l'utilisation de proxys en rotation augmente considérablement vos chances de réussir l'extraction de données, en évitant la détection et en réduisant le risque de blocage des adresses IP.
Accès aux contenus soumis à des restrictions géographiques: grâce à un large éventail d'adresses IP provenant de différentes zones géographiques, vous pouvez contourner les restrictions géographiques et accéder à des contenus qui pourraient être bloqués dans certaines régions.
Scraping continu: en répartissant les requêtes sur plusieurs adresses IP, les proxys rotatifs permettent un scraping continu sans interruption, ce qui est essentiel pour la collecte de données à grande échelle.
Anonymat renforcé: les proxys rotatifs renforcent votre anonymat en masquant votre véritable adresse IP et en compliquant la tâche des sites web qui tenteraient de remonter jusqu'à vous à partir de votre activité.
IPBurger propose des proxys rotatifs de haute qualité qui garantissent un web scraping sans faille. Conçus pour offrir un large éventail d'adresses IP, un débit élevé et une grande fiabilité, ces proxys sont parfaits pour contourner les blocages liés au web scraping.
Utiliser des proxys résidentiels
Pour éviter d'être détecté lors du web scraping, les proxys résidentiels changent véritablement la donne. Voyons pourquoi ils sont si efficaces et en quoi ils diffèrent des proxys de centre de données.
Adresses IP authentiques: les proxys résidentiels utilisent des adresses IP attribuées par les fournisseurs d'accès à Internet (FAI) aux particuliers. Ils apparaissent ainsi comme des utilisateurs légitimes aux yeux des sites web, ce qui réduit le risque d'être signalé.
Taux de détection plus faibles: comme les proxys résidentiels se présentent comme des utilisateurs lambda, ils ont moins de chances d'être détectés et bannis que les proxys de centres de données, qui sont souvent identifiés et bloqués par les sites web.
Moins susceptibles d'être mises sur liste noire: les adresses IP résidentielles sont moins susceptibles de figurer sur les listes noires utilisées par les sites web pour bloquer les robots de scraping présumés. Cela garantit un accès plus fluide et plus stable aux sites web.
Ciblage géographique: les proxys résidentiels vous permettent d'accéder à des contenus spécifiques à certaines régions géographiques. Cela s'avère particulièrement utile pour extraire des données localisées ou contourner les restrictions géographiques applicables à certains contenus.
Comment les proxys résidentiels contribuent à maintenir de faibles taux de détection
Comportements de navigation naturels: les proxys résidentiels permettent d'imiter le comportement des utilisateurs réels, ce qui complique la tâche des sites web pour distinguer le trafic légitime des robots de scraping.
Diversité des adresses IP: en utilisant un large éventail d'adresses IP, les proxys résidentiels répartissent vos requêtes, ce qui complique la tâche des sites web pour détecter des schémas récurrents et bloquer vos activités.
Performances constantes: les proxys résidentiels offrent des connexions stables et fiables, indispensables pour les projets de scraping à long terme. Cela réduit le risque d'interruptions et de blocages.
Options de rotation: De nombreux fournisseurs de proxys résidentiels, comme IPBurger, proposent des proxys résidentiels à rotation qui modifient automatiquement votre adresse IP, réduisant ainsi encore davantage les risques de détection.
Imiter le comportement humain
L'un des moyens les plus efficaces d'éviter d'être détecté lors du web scraping consiste à imiter le comportement humain. Les sites web utilisent diverses méthodes pour détecter et bloquer les robots, mais en donnant à vos activités de scraping un aspect plus « humain », vous pouvez réduire considérablement le risque d'être bloqué. Voici comment procéder.
En quoi le fait d'imiter le comportement humain permet d'éviter d'être repéré
Les sites web sont dotés d'algorithmes sophistiqués conçus pour détecter et bloquer les robots automatisés. Ces algorithmes recherchent des schémas et des comportements typiques des robots, tels que des requêtes rapides, l'absence de mouvement de la souris et des actions répétitives. En imitant le comportement humain, vous rendez vos activités de scraping moins prévisibles et plus difficiles à détecter.
Comment imiter le comportement humain dans le web scraping
Intervalles aléatoires entre les requêtes
- Pourquoi cela fonctionne: les utilisateurs ne cliquent pas sur les liens et ne naviguent pas sur les sites web à des intervalles parfaitement réguliers. Introduire un caractère aléatoire dans le délai entre les requêtes permet de reproduire plus fidèlement le comportement naturel de navigation.
Comment procéder: utilisez du code pour générer des intervalles de pause aléatoires entre les requêtes. Par exemple :
import time

import random

urls = ['https://www.example.com/page1', 'https://www.example.com/page2']

for url in urls:

    response = requests.get(url)

    # Process response

    sleep_time = random.uniform(1, 5)  # Sleep for a random time between 1 and 5 seconds

    time.sleep(sleep_time)
Simuler les mouvements et les clics de la souris
- Pourquoi cela fonctionne: les robots naviguent généralement sans aucun mouvement ni clic de souris, alors que les humains déplacent naturellement la souris et cliquent sur des éléments.
Comment procéder: utilisez des bibliothèques telles que Selenium pour simuler les mouvements et les clics de souris.
from selenium import webdriver

from selenium.webdriver.common.action_chains import ActionChains

driver = webdriver.Chrome()

driver.get('https://www.example.com')

element = driver.find_element_by_id('element_id')

ActionChains(driver).move_to_element(element).click().perform()
Utilisez des agents utilisateur réalistes
- Pourquoi cela fonctionne: les chaînes « User-Agent » fournissent des informations sur le navigateur et le système d'exploitation. L'utilisation d'une variété de chaînes « User-Agent » réalistes peut contribuer à donner à vos requêtes un aspect plus légitime.
Comment procéder: alterner les chaînes « User-Agent » à chaque requête.
import requests

url = 'https://www.example.com'

headers = {

    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/112.0.0.0 Safari/537.36'

}

response = requests.get(url, headers=headers)
Limiter le nombre de requêtes par session
- Pourquoi cela fonctionne: effectuer un trop grand nombre de requêtes au cours d'une même session peut éveiller les soupçons. Limiter le nombre de requêtes par session permet de reproduire les habitudes de navigation d'un utilisateur humain.
- Comment procéder: divisez vos tâches de scraping en petits lots et répartissez-les sur plusieurs sessions.
Utiliser la navigation en plusieurs étapes
- Pourquoi cela fonctionne: les utilisateurs naviguent souvent sur les sites web en plusieurs étapes plutôt que d'accéder directement à une seule page. Imiter ce comportement peut réduire le risque de détection.
- Comment procéder: utilisez des scripts pour parcourir plusieurs pages avant d'accéder aux données cibles.
Alterner les adresses IP et utiliser des serveurs proxy
- Pourquoi cela fonctionne: les utilisateurs accèdent aux sites web à partir de différentes adresses IP. Alterner les adresses IP et utiliser des proxys permet de simuler ce comportement naturel.
- Comment procéder: intégrez des proxys rotatifs à votre configuration de scraping.
Cliquer au hasard sur des liens et interagir avec le contenu
- Pourquoi cela fonctionne: les utilisateurs ne se contentent pas de collecter des données ; ils interagissent avec le contenu, par exemple en cliquant sur des liens et des boutons.
- Mise en œuvre: utilisez des scripts automatisés pour cliquer de manière aléatoire sur des liens et interagir avec les éléments de la page.
Alternance des en-têtes User-Agent
Une stratégie efficace pour éviter d'être bloqué lors du web scraping consiste à faire tourner vos en-têtes User-Agent. Voici un aperçu détaillé de son fonctionnement et des avantages qu'elle présente.
Que sont les en-têtes « User-Agent » ?
Un en-tête « User-Agent » est une chaîne de caractères envoyée avec les requêtes HTTP afin d’identifier le navigateur, le système d’exploitation et l’appareil à l’origine de la requête. Il fournit aux sites web des informations sur les logiciels et le matériel utilisés pour y accéder. Les sites web utilisent ces informations pour optimiser la diffusion de leur contenu, mais aussi pour détecter les activités non humaines.
Comment la rotation des en-têtes « User-Agent » peut empêcher la détection
Éviter la reconnaissance de formes
- Pourquoi cela fonctionne: l'utilisation systématique de la même chaîne « User-Agent » pour plusieurs requêtes peut rapidement faire passer votre activité pour celle d'un bot. En faisant varier les en-têtes « User-Agent », vous donnez l'impression que les requêtes proviennent de différents navigateurs et appareils, imitant ainsi le comportement humain.
- Avantages: en variant les chaînes « User-Agent », vous réduisez le risque d'être détecté, car il devient plus difficile pour les sites web d'identifier des schémas récurrents dans vos requêtes.
Contourner le blocage par User-Agent
- Pourquoi cela fonctionne: certains sites Web bloquent les requêtes provenant d'agents utilisateur (User-Agents) connus pour être des robots. En alternant entre une liste de chaînes d'agents utilisateur courantes et légitimes, vous pouvez contourner ces blocages et poursuivre le scraping sans interruption.
- Avantages: l'utilisation d'une variété de chaînes « User-Agent » provenant de navigateurs et d'appareils courants permet d'éviter les blocages et garantit un accès ininterrompu.
Outils permettant d'automatiser la rotation des user-agents
Il existe plusieurs outils et méthodes que vous pouvez utiliser pour automatiser la rotation des en-têtes User-Agent dans vos scripts de web scraping :
Bibliothèque Requests de Python avec rotation de l'agent utilisateur
Mise en œuvre: utilisez la bibliothèque « Requests » de Python pour faire varier l'en-tête « User-Agent » à chaque requête.
import requests

import random

url = 'https://www.example.com'

user_agents = [

    'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/112.0.0.0 Safari/537.36',

    'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/90.0.4430.93 Safari/537.36',

    'Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/88.0.4324.150 Safari/537.36',

    # Add more User-Agent strings

]

headers = {

    'User-Agent': random.choice(user_agents)

}

response = requests.get(url, headers=headers)

print(response.content)
Le framework Scrapy avec un middleware User-Agent
Mise en œuvre: Scrapy, un framework de web scraping très répandu, permet d'utiliser des middlewares pour faire tourner les chaînes User-Agent.
from scrapy import signals

import random

class RotateUserAgentMiddleware(object):

    user_agents = [

        'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/112.0.0.0 Safari/537.36',

        'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/90.0.4430.93 Safari/537.36',

        'Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/88.0.4324.150 Safari/537.36',

        # Add more User-Agent strings

    ]

    def process_request(self, request, spider):

        request.headers['User-Agent'] = random.choice(self.user_agents)
Outils d'automatisation des navigateurs
Selenium WebDriver: utilisez Selenium pour alterner les chaînes User-Agent lors de l'automatisation des interactions avec le navigateur.
from selenium import webdriver

from selenium.webdriver.chrome.options import Options

import random

user_agents = [

    'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/112.0.0.0 Safari/537.36',

    'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/90.0.4430.93 Safari/537.36',

    'Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/88.0.4324.150 Safari/537.36',

    # Add more User-Agent strings

]

chrome_options = Options()

chrome_options.add_argument(f"user-agent={random.choice(user_agents)}")

driver = webdriver.Chrome(options=chrome_options)

driver.get('https://www.example.com')
La rotation des en-têtes User-Agent est un moyen simple mais efficace de réduire les risques de blocage liés au web scraping. En utilisant des outils tels que Python Requests, Scrapy et Selenium, vous pouvez automatiser ce processus et vous assurer que vos activités de scraping passent inaperçues.
Gérer les taux de demande
Une stratégie essentielle pour réussir le web scraping consiste à gérer efficacement vos fréquences de requêtes. Cela permet d'éviter d'être détecté et de garantir que vos activités de scraping puissent se poursuivre sans interruption. Voici pourquoi la gestion des fréquences de requêtes est importante et comment vous pouvez mettre en place une limitation de fréquence dans vos projets de web scraping.
Importance de la gestion des fréquences de requêtes pour éviter d'être détecté
Prévenir la surcharge des serveurs
- Pourquoi est-ce important? Envoyer trop de requêtes en peu de temps peut surcharger le serveur d'un site web. Cela ralentit non seulement le site pour les utilisateurs habituels, mais déclenche également des alertes qui pourraient entraîner le blocage de votre adresse IP.
- Avantage: en espaçant vos requêtes, vous réduisez la charge sur le serveur, ce qui permet de maintenir les performances normales du site web et diminue le risque d'être signalé comme un bot.
Éviter d'éveiller les soupçons
- Pourquoi est-ce important? Les utilisateurs humains n'effectuent généralement pas des centaines de requêtes par seconde. Un nombre excessif de requêtes est un indicateur clair d'activité de bot. En imitant le comportement de navigation d'un utilisateur humain, vous pouvez éviter d'éveiller les soupçons.
- Avantage: la gestion des fréquences de requêtes afin de reproduire le comportement humain permet à vos activités de scraping de passer inaperçues, réduisant ainsi le risque de détection et de blocage.
Techniques de mise en œuvre de la limitation de débit dans le web scraping
Délais aléatoires entre les requêtes
Fonctionnement: introduisez des délais aléatoires entre chaque requête afin de reproduire un comportement de navigation naturel. Pour ce faire, il suffit d'utiliser un simple script dans votre code de web scraping.
import time

import random

urls = ['https://www.example.com/page1', 'https://www.example.com/page2']

for url in urls:

    response = requests.get(url)

    # Process response

    sleep_time = random.uniform(1, 5)  # Sleep for a random time between 1 and 5 seconds

    time.sleep(sleep_time)
Limitation du débit fixe
Fonctionnement: définissez un délai fixe entre les requêtes afin de ne pas dépasser un certain nombre de requêtes par minute.
import time

urls = ['https://www.example.com/page1', 'https://www.example.com/page2']

for url in urls:

    response = requests.get(url)

    # Process response

    time.sleep(2)  # Sleep for 2 seconds between each request
Limitation adaptative du débit
Fonctionnement: adaptez le rythme des requêtes en fonction de la réponse du serveur. Par exemple, si le temps de réponse du serveur augmente, réduisez le rythme de vos requêtes afin d'éviter de le surcharger.
Import time
import requests

urls = ['https://www.example.com/page1', 'https://www.example.com/page2']

for url in urls:

    start_time = time.time()

    response = requests.get(url)

    # Process response

    end_time = time.time()

    response_time = end_time - start_time

    if response_time < 2:

        time.sleep(2 - response_time)  # Ensure a minimum of 2 seconds between requests
Utilisation des bibliothèques et des frameworks
Scrapy: Scrapy, un framework populaire dédié au web scraping, intègre une fonctionnalité de limitation de débit. Vous pouvez configurer les paramètres pour contrôler le délai de téléchargement.
# settings.py in Scrapy project

DOWNLOAD_DELAY = 2 # Delay in seconds between requests- API et limitation du débit: certaines API proposent des mécanismes de limitation du débit permettant de gérer le nombre de requêtes. Utilisez ces fonctionnalités intégrées pour vous assurer de ne pas dépasser les limites autorisées en matière de requêtes.
Utiliser des outils de résolution de CAPTCHA
Les CAPTCHA sont conçus pour distinguer les utilisateurs humains des robots automatisés. Ils proposent des défis faciles à résoudre pour les humains, mais difficiles pour les robots. Cependant, dans le cadre du web scraping, tomber sur un CAPTCHA peut interrompre vos opérations. Voici comment les outils de résolution de CAPTCHA entrent en jeu et comment ils peuvent vous aider à contourner ces obstacles.
Que sont les « CAPTCHA Solvers » ?
Les outils de résolution de CAPTCHA sont des outils ou des services qui automatisent le processus de résolution des défis CAPTCHA. Ils utilisent diverses techniques, telles que la reconnaissance optique de caractères (OCR) et l'apprentissage automatique, pour décoder et résoudre le CAPTCHA, ce qui permet à votre outil de scraping de poursuivre ses tâches sans intervention manuelle.
Comment les outils de contournement des CAPTCHA peuvent aider à contourner les défis posés par les CAPTCHA
Solutions automatisées
- Pourquoi est-ce important? La résolution manuelle des CAPTCHA peut s'avérer chronophage et peu pratique pour les opérations de scraping à grande échelle. Les outils automatisés de résolution de CAPTCHA s'acquittent efficacement de cette tâche, garantissant ainsi un scraping continu sans interruption.
- Fonctionnement: les outils de résolution de CAPTCHA s'intègrent à votre script de web scraping, détectant et résolvant automatiquement les CAPTCHA dès leur apparition. Ils peuvent traiter différents types de CAPTCHA, notamment les CAPTCHA textuels, ceux basés sur des images et les CAPTCHA audio.
Amélioration des taux de réussite
- Pourquoi est-ce important? Contourner efficacement les CAPTCHA permet d'augmenter le taux de réussite de vos opérations de scraping. Les outils de contournement des CAPTCHA réduisent le risque que votre robot de scraping soit bloqué ou empêché de fonctionner par les CAPTCHA.
- Fonctionnement: les outils avancés de résolution de CAPTCHA utilisent des modèles d'apprentissage automatique entraînés sur de vastes ensembles de données de CAPTCHA afin d'améliorer leur précision et leur rapidité. Cela permet de garantir que même les CAPTCHA les plus complexes soient résolus rapidement et correctement.
Intégration avec des outils de scraping
- Pourquoi est-ce important? Une intégration transparente avec les outils et frameworks de scraping les plus courants améliore l'efficacité de vos opérations de scraping.
- Fonctionnement: De nombreux services de résolution de CAPTCHA proposent des API qui s'intègrent facilement à votre infrastructure de scraping existante. Cela permet un fonctionnement fluide sans avoir à apporter de modifications importantes à votre base de code.
Exemples de programmes permettant de résoudre les CAPTCHA
2Captcha: un service très répandu qui fait appel à des opérateurs humains pour résoudre des CAPTCHA en temps réel. Il prend en charge divers types de CAPTCHA et propose une API pour l'intégration.
Exemple d'intégration:
import requests

api_key = 'YOUR_2CAPTCHA_API_KEY'

site_key = 'SITE_KEY_FROM_CAPTCHA'

url = 'https://www.example.com'

captcha_id = requests.post(f'http://2captcha.com/in.php?key={api_key}&method=userrecaptcha&googlekey={site_key}&pageurl={url}').text.split('|')[1]

response = None

while not response:

    response = requests.get(f'http://2captcha.com/res.php?key={api_key}&action=get&id={captcha_id}').text

    if 'CAPCHA_NOT_READY' in response:

        time.sleep(5)

    else:

        response = response.split('|')[1]

# Use the response in your form submissionAnti-Captcha: un autre service bien connu qui utilise à la fois des solutions automatisées et humaines pour résoudre les CAPTCHA. Il propose une API robuste facilitant l'intégration.
Exemple d'intégration:
import anticaptchaofficial.recaptchav2proxyless

solver = anticaptchaofficial.recaptchav2proxyless.recaptchav2Proxyless()

solver.set_verbose(1)

solver.set_key("YOUR_ANTI_CAPTCHA_API_KEY")

solver.set_website_url("https://www.example.com")

solver.set_website_key("SITE_KEY_FROM_CAPTCHA")

response = solver.solve_and_return_solution()

if response != 0:

    print(f"Captcha solved: {response}")

else:

    print(f"Error: {solver.error_code}")
Death by CAPTCHA: propose à la fois des solutions automatisées et humaines pour résoudre les CAPTCHA. Réputé pour sa fiabilité et sa rapidité, ce service prend en charge un large éventail de types de CAPTCHA.
Exemple d'intégration:
import deathbycaptcha

client = deathbycaptcha.SocketClient('username', 'password')

balance = client.get_balance()

print(f'Balance: {balance}')

captcha = client.decode(url='https://www.example.com')

print(f'CAPTCHA {captcha["captcha"]} solved: {captcha["text"]}')
Navigateurs sans tête
Les navigateurs « headless » constituent un outil puissant dans la panoplie des spécialistes du web scraping, permettant un processus de scraping plus fluide et plus efficace. Si vous en avez assez d'être bloqué ou si vous avez besoin d'une méthode plus avancée pour gérer des tâches de scraping complexes, les navigateurs « headless » pourraient bien être la solution qu'il vous faut.
Qu'est-ce qu'un navigateur « headless » ?
Les navigateurs « headless » sont des navigateurs Web qui fonctionnent sans interface graphique (GUI). Ils peuvent afficher des pages Web et exécuter du code JavaScript tout comme les navigateurs traditionnels, mais ils s'exécutent en arrière-plan, sans afficher le contenu à l'utilisateur. Cela les rend parfaits pour les tâches automatisées de scraping Web où l'affichage visuel n'est pas nécessaire.
Avantages de l'utilisation de navigateurs sans interface graphique pour le web scraping
Performances améliorées
- Pourquoi est-ce important? Les navigateurs « headless » consomment moins de ressources, car ils n’affichent pas d’images et ne traitent pas d’éléments visuels. Cela permet d’accélérer les opérations de scraping et d’optimiser l’extraction des données.
- Fonctionnement: en fonctionnant en arrière-plan, les navigateurs « headless » allègent la charge sur votre système, ce qui vous permet d'extraire des données plus rapidement et de traiter des volumes de requêtes plus importants.
Contournement de la détection
- Pourquoi est-ce important? De nombreux sites web utilisent des mécanismes de détection des robots capables d'identifier les méthodes traditionnelles de scraping. Les navigateurs « headless » permettent de contourner certaines de ces techniques de détection en imitant plus fidèlement les interactions d'un utilisateur réel.
- Fonctionnement: les navigateurs « headless » peuvent interagir avec les pages Web exactement comme des utilisateurs lambda, notamment en gérant l'exécution de JavaScript et le chargement de contenu dynamique, ce qui peut contribuer à éviter toute détection.
Automatisation avancée
- Pourquoi est-ce important? Pour les tâches de scraping plus complexes, telles que l'interaction avec des formulaires ou la navigation entre plusieurs pages, les navigateurs « headless » offrent des fonctionnalités d'automatisation avancées qui vont au-delà des simples requêtes HTTP.
- Fonctionnement: ils prennent en charge l'exécution complète du JavaScript et peuvent simuler des interactions utilisateur telles que les clics, les défilements et les envois de formulaires, offrant ainsi une représentation plus fidèle du comportement réel des utilisateurs.
Outils et bibliothèques pour la navigation « headless »
Marionnettiste
- Présentation: Puppeteer est une bibliothèque Node.js qui fournit une API de haut niveau permettant de contrôler Chrome ou Chromium via le protocole DevTools. Elle est largement utilisée pour l'extraction de contenu dynamique et la réalisation de tests automatisés.
- Principales fonctionnalités: contrôle total du navigateur, prise en charge du mode « headless », création de captures d'écran et de fichiers PDF, et interactions automatisées.
Exemple:
const puppeteer = require('puppeteer');

(async () => {

  const browser = await puppeteer.launch({ headless: true });

  const page = await browser.newPage();

  await page.goto('https://www.example.com');

  const content = await page.content();

  console.log(content);

  await browser.close();

})();
Selenium WebDriver
- Présentation: Selenium WebDriver est un outil très répandu permettant d'automatiser les navigateurs Web. Il prend en charge plusieurs langages de programmation et navigateurs, y compris les modes « headless » pour Chrome et Firefox.
- Principales fonctionnalités: compatibilité avec tous les navigateurs, interactions avancées et soutien important de la communauté.
Exemple:
from selenium import webdriver

from selenium.webdriver.chrome.options import Options

chrome_options = Options()

chrome_options.add_argument("--headless")

driver = webdriver.Chrome(options=chrome_options)

driver.get('https://www.example.com')

content = driver.page_source

print(content)

driver.quit()
Dramaturge
- Présentation: Playwright est une bibliothèque Node.js développée par Microsoft qui permet d'automatiser les tests des applications web. Elle prend en charge plusieurs navigateurs et offre des fonctionnalités similaires à celles de Puppeteer.
- Principales fonctionnalités: prise en charge multi-navigateurs, mode « headless » et interactions automatisées dans des scénarios complexes.
Exemple:
const { chromium } = require('playwright');

(async () => {

  const browser = await chromium.launch({ headless: true });

  const page = await browser.newPage();

  await page.goto('https://www.example.com');

  const content = await page.content();

  console.log(content);

  await browser.close();

})();
Gérer les pièges « honeypot »
Les « honeypots » sont des pièges astucieux mis en place par des sites web pour prendre les robots en flagrant délit. Ils se présentent sous différentes formes, chacune étant conçue pour exploiter le comportement prévisible des scripts automatisés.
Liens et champs masqués
Imaginez une page web truffée de pièges invisibles. Les « honeypots » comportent souvent des champs de formulaire, des liens ou des boutons cachés qu’un utilisateur lambda ne verrait jamais ni n’utiliserait. Les bots, en revanche, sont généralement programmés pour cliquer sur tous les liens ou remplir tous les champs de formulaire. Lorsqu’ils interagissent avec ces éléments cachés, ils déclenchent le piège.
Astuces CSS
Les développeurs web utilisent des astuces CSS pour mettre en place ces pièges. Il est possible de masquer des éléments à l'aide de propriétés telles que display: none; ou visibility: hidden;. Même si les utilisateurs humains ne verront pas ces éléments, les robots qui ne prennent pas en charge le CSS interagiront avec eux.
Surpris.
Défis JavaScript
Certains « honeypots » vont encore plus loin en utilisant JavaScript pour ajouter dynamiquement des pièges une fois la page chargée. C'est une stratégie astucieuse. Les robots qui n'exécutent pas correctement le JavaScript tomberont directement dans ces pièges.
Par exemple, un formulaire peut sembler normal lors du chargement initial de la page, mais un champ ou un lien masqué peut être ajouté via JavaScript quelques secondes plus tard. Si un bot tente d'interagir avec ce nouvel élément, cela trahit clairement sa nature automatisée.
Astucieux, non ?
Les « honeypots » exploitent la prévisibilité des bots pour les piéger. Alors que les utilisateurs humains naviguent sans encombre sur le site, tout bot qui tente d'extraire des données ou d'envoyer du spam se fait prendre dans ces pièges cachés.
Techniques pour éviter les pièges de type « honeypot » lors du web scraping
1. Évitez d’interagir avec des éléments masqués
Détection CSS: avant d'interagir avec des éléments, vérifiez leurs propriétés CSS afin de vous assurer qu'ils sont visibles pour les utilisateurs humains. Les éléments présentant des propriétés telles que `display: none;` ou `visibility: hidden;` doivent être ignorés.
from bs4 import BeautifulSoup

import requests

url = 'https://www.example.com'

response = requests.get(url)

soup = BeautifulSoup(response.text, 'html.parser')

for link in soup.find_all('a'):

    if 'display' in link.get('style', '') and 'none' in link['style']:

        continue  # Skip hidden link

    # Process visible link
2. Utiliser des modèles d'interaction de type humain
- Interaction sélective: configurez votre robot de collecte de données pour qu'il n'interagisse qu'avec les éléments auxquels un utilisateur humain typique s'intéresserait. Évitez de cliquer sur tous les liens ou de remplir tous les formulaires sans discernement.
- Simuler le comportement humain: intégrez des pauses et des délais qui imitent le comportement de navigation humain, comme indiqué dans les sections précédentes.
3. Surveiller l'exécution de JavaScript
Analyse JavaScript: utilisez des navigateurs sans interface graphique pour afficher les pages dans leur intégralité et exécuter le code JavaScript. Cela vous permet de détecter les « honeypots » ajoutés dynamiquement et d'éviter toute interaction avec eux.
from selenium import webdriver

driver = webdriver.Chrome()

driver.get('https://www.example.com')

# Check for dynamically added honeypots

links = driver.find_elements_by_tag_name('a')

for link in links:

    style = link.get_attribute('style')

    if 'display: none;' in style or 'visibility: hidden;' in style:

        continue  # Skip hidden link

    # Process visible link
4. Utiliser des outils avancés de scraping
Scrapy et les middlewares: utilisez les middlewares de Scrapy pour filtrer les honeypots en vérifiant la présence d'attributs caractéristiques de ces derniers.
classe IgnoreHoneypotsMiddleware :
def process_spider_output(self, response, result, spider):

        for item in result:

            if isinstance(item, dict):  # Assuming item is a dict

                # Add custom logic to filter honeypots

                if 'honeypot' in item.get('class', ''):

                    continue

        yield item
Conclusion
Pour éviter les interdictions d'accès par adresse IP et réussir à extraire des données depuis des sites web, il faut allier des stratégies intelligentes et des outils adaptés. En comprenant les techniques couramment utilisées par les sites web pour bloquer les robots d'extraction et en mettant en œuvre les méthodes suivantes, vous pouvez réduire considérablement les blocages liés au web scraping :
- Utilisez des proxys rotatifs: répartissez vos requêtes sur plusieurs adresses IP pour éviter d'être détecté.
- Mettre en place une rotation des adresses IP: changez régulièrement d'adresse IP afin de simuler la présence de plusieurs utilisateurs et de réduire le risque d'exclusion.
- Utiliser des proxys résidentiels: utilisez de véritables adresses IP résidentielles pour que votre trafic semble plus légitime.
- Imiter le comportement humain: donnez un aspect naturel à vos activités de scraping en y intégrant des éléments aléatoires et des interactions de type humain.
- Alternance des en-têtes « User-Agent » : modifiez les chaînes « User-Agent » pour éviter d'être repéré par les sites web.
- Gérer la fréquence des requêtes: contrôlez la fréquence de vos requêtes afin d'éviter de surcharger les serveurs.
- Utilisez des outils de résolution de CAPTCHA: automatisez la résolution des CAPTCHA pour contourner ces obstacles courants.
- Utilisez des navigateurs « headless »: tirez parti des navigateurs fonctionnant sans interface graphique pour réaliser des tâches de scraping plus avancées.
- Gérer les pièges « honeypot »: détecter et éviter les éléments cachés conçus pour piéger les bots.
IPBurger propose une gamme de solutions de proxy performantes qui vous aideront à mettre en œuvre efficacement ces techniques. Grâce à ses proxys rotatifs, ses proxys résidentiels et son assistance technique fiable, vous pouvez être sûr de réduire considérablement les blocages liés au web scraping.
Prêt à contourner les restrictions liées au web scraping ? Rendez-vous sur IPBurger pour découvrir nos solutions de proxy avancées.