Các rào cản khi trích xuất dữ liệu từ web thật là phiền phức. Vừa mới thu thập được tất cả dữ liệu cần thiết, thì ngay lập tức bạn đã phải đối mặt với một thông báo lỗi.
Thật bực mình, phải không?
Các trang web ngày càng trở nên hiệu quả hơn trong việc phát hiện các hoạt động thu thập dữ liệu trái phép và nhanh chóng chặn đứng chúng. Đây không chỉ là một rắc rối nhỏ — nó có thể làm đảo lộn toàn bộ dự án của bạn. Nghiên cứu thị trường, phân tích đối thủ cạnh tranh, tổng hợp dữ liệu — tất cả đều bị đình trệ.
Nhưng đừng lo.
Có những cách để vượt qua các rào cản này và đảm bảo các phiên thu thập dữ liệu của bạn diễn ra suôn sẻ.
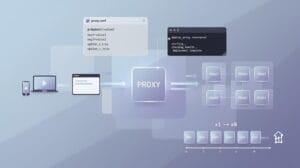
Trước hết, đó là việc luân phiên sử dụng proxy. Cách này có thể giúp bạn tránh bị khóa tài khoản bằng cách liên tục thay đổi địa chỉ IP, khiến các trang web khó phát hiện hoạt động thu thập dữ liệu của bạn hơn. Hãy tưởng tượng việc này giống như thay đổi lớp ngụy trang cứ sau vài phút — bạn sẽ khó bị phát hiện hơn rất nhiều!
Tiếp theo, hãy bắt chước hành vi của con người. Các bot thường thực hiện các yêu cầu nhanh chóng và lặp đi lặp lại, điều này là dấu hiệu nhận biết rõ ràng. Hãy thực hiện quá trình thu thập dữ liệu chậm lại. Thêm các khoảng trễ ngẫu nhiên giữa các thao tác. Mô phỏng các chuyển động và cú nhấp chuột của chuột. Điều này giúp quá trình thu thập dữ liệu của bạn trông giống như đang được thực hiện bởi một người thật hơn.
Việc sử dụng proxy dân dụng cũng có thể là một bước đột phá. Khác với proxy trung tâm dữ liệu, proxy dân dụng sử dụng các địa chỉ IP từ các thiết bị thực, giúp chúng trông hợp pháp hơn và ít có khả năng bị phát hiện hơn.
Tiếp theo là cơ chế luân phiên User-Agent. Các trang web thường chặn bot bằng cách phát hiện chuỗi User-Agent trong các tiêu đề HTTP. Bằng cách luân phiên các tiêu đề này, bạn có thể khiến bot của mình trông giống như đang chạy trên nhiều trình duyệt và thiết bị khác nhau.
Cuối cùng, hãy quản lý tần suất gửi yêu cầu của bạn. Gửi quá nhiều yêu cầu trong thời gian quá ngắn là cách chắc chắn dẫn đến việc bị chặn. Hãy áp dụng cơ chế giới hạn tần suất để tránh bị chú ý.
Sẵn sàng chưa?
Hãy cùng tìm hiểu chi tiết hơn về các chiến lược này để đảm bảo quá trình thu thập dữ liệu của bạn diễn ra suôn sẻ.
Hiểu về các chướng ngại vật trong việc thu thập dữ liệu từ web
Web scraping là quá trình trích xuất dữ liệu tự động từ các trang web bằng cách sử dụng các tập lệnh phần mềm. Đây là một công cụ mạnh mẽ để thu thập thông tin, nhưng nhiều trang web đang tích cực triển khai các biện pháp để chặn các công cụ web scraping. Tại sao vậy?
Tại sao các trang web lại chặn các công cụ thu thập dữ liệu?
Các trang web chặn các công cụ thu thập dữ liệu vì nhiều lý do:
Tải trọng máy chủ: Việc thu thập dữ liệu tự động có thể khiến máy chủ bị quá tải do lượng yêu cầu quá lớn, dẫn đến việc trang web hoạt động chậm lại đối với người dùng thông thường. Hãy tưởng tượng hàng chục bot cùng lúc truy cập ồ ạt vào một trang web; điều này có thể khiến máy chủ bị sập.
Bảo vệ dữ liệu: Các trang web muốn bảo vệ nội dung và dữ liệu của mình khỏi việc bị sao chép trái phép. Dữ liệu độc quyền là một mỏ vàng, và không ai muốn nó bị lấy đi miễn phí.
Quyền riêng tư của người dùng: Các công cụ thu thập dữ liệu đôi khi có thể thu thập thông tin cá nhân, gây ra những lo ngại về quyền riêng tư. Chẳng ai muốn dữ liệu của mình bị thu thập mà không có sự đồng ý, phải không?
Thực thi chính sách: Các trang web thường có điều khoản dịch vụ cấm việc thu thập dữ liệu tự động nhằm duy trì quyền kiểm soát cách thức sử dụng dữ liệu của họ. Điều này nhằm đảm bảo môi trường trực tuyến luôn công bằng và an toàn.
Các trang web phát hiện và chặn các công cụ thu thập dữ liệu như thế nào?
Chặn địa chỉ IP
Định nghĩa: Các trang web theo dõi các địa chỉ IP thực hiện các yêu cầu. Nếu một địa chỉ IP thực hiện quá nhiều yêu cầu trong một khoảng thời gian ngắn, địa chỉ đó sẽ bị đánh dấu và chặn.
Tại sao phương pháp này lại hiệu quả: Phương pháp này hiệu quả vì hầu hết các công cụ thu thập dữ liệu đều hoạt động từ một địa chỉ IP duy nhất hoặc một dải địa chỉ IP hẹp. Điều này giống như việc phát hiện một kẻ gửi thư rác nhờ nhận ra rằng họ gửi 50 email trong một phút.
Phát hiện User-Agent
Định nghĩa: Mỗi yêu cầu gửi đến một trang web đều chứa một chuỗi User-Agent, dùng để xác định trình duyệt và hệ điều hành. Các công cụ thu thập dữ liệu thường sử dụng chuỗi User-Agent mặc định hoặc không sử dụng chuỗi này, khiến chúng dễ bị phát hiện.
Tại sao phương pháp này hiệu quả: Việc phát hiện và chặn các chuỗi User-Agent bất thường giúp các trang web phân biệt giữa người dùng thực và bot. Bot cũng có những dấu hiệu nhận biết, giống như trong trò chơi poker vậy.
Yêu cầu giới hạn tốc độ
Định nghĩa: Các trang web giới hạn số lượng yêu cầu mà một địa chỉ IP hoặc User-Agent có thể gửi trong một khoảng thời gian nhất định.
Tại sao phương pháp này hiệu quả: Bằng cách giới hạn tần suất yêu cầu, các trang web có thể làm chậm hoặc ngăn chặn các công cụ thu thập dữ liệu mà không ảnh hưởng đến người dùng thông thường. Điều này giống như một nhân viên bảo vệ đảm bảo quán bar không quá đông đúc.
Hãy tìm hiểu các phương pháp này.
Hãy tìm hiểu những yếu tố nào gây ra sự bế tắc.
Như vậy, bạn có thể lên kế hoạch cho các hoạt động thu thập dữ liệu của mình một cách hiệu quả hơn.
Tiếp theo, chúng ta sẽ đi sâu vào các kỹ thuật cụ thể để vượt qua những rào cản này.
Hãy theo dõi.
Các kỹ thuật hiệu quả để tránh bị chặn khi thu thập dữ liệu trên web
Sử dụng các máy chủ proxy luân phiên
Một trong những cách hiệu quả nhất để tránh bị chặn khi thu thập dữ liệu web là sử dụng các proxy luân phiên. Dưới đây là cách thức hoạt động của chúng và lý do tại sao chúng lại mang lại lợi ích.
Proxy xoay vòng là gì?
Proxy luân phiên cung cấp một nhóm các địa chỉ IP thay đổi theo định kỳ hoặc sau mỗi yêu cầu. Thay vì gửi tất cả các yêu cầu từ một địa chỉ IP duy nhất – điều này có thể dễ dàng bị phát hiện và chặn – proxy luân phiên sẽ phân bổ các yêu cầu của bạn trên nhiều địa chỉ IP khác nhau.
Khó phát hiện hơn.
Cách sử dụng các máy chủ proxy luân phiên giúp tránh bị chặn địa chỉ IP
Phân bổ địa chỉ IP: Bằng cách luân phiên sử dụng các địa chỉ IP, bạn sẽ mô phỏng hành vi của nhiều người dùng truy cập trang web từ các vị trí khác nhau. Sự phân tán này khiến các trang web khó xác định được các mẫu hành vi và áp dụng các biện pháp cấm truy cập.
Giảm rủi ro bị phát hiện: Nhờ sử dụng các máy chủ proxy luân phiên, mỗi yêu cầu sẽ trông như đến từ một người dùng khác nhau. Điều này giúp tránh việc kích hoạt các giới hạn tần suất và lệnh cấm IP – những biện pháp thường được áp dụng để ngăn chặn các yêu cầu quá mức từ một địa chỉ IP duy nhất.
Xử lý Captcha: Một số dịch vụ proxy luân phiên nâng cao có thể giúp vượt qua Captcha bằng cách phân phối các yêu cầu theo cách làm giảm khả năng kích hoạt các thử thách Captcha.
Lợi ích của việc sử dụng các máy chủ proxy luân phiên trong việc thu thập dữ liệu web
Tăng tỷ lệ thành công: Việc luân phiên sử dụng các địa chỉ proxy giúp tăng đáng kể khả năng trích xuất dữ liệu thành công bằng cách tránh bị phát hiện và giảm nguy cơ bị chặn địa chỉ IP.
Truy cập nội dung bị giới hạn theo khu vực: Với kho địa chỉ IP đa dạng từ các vị trí địa lý khác nhau, bạn có thể vượt qua các hạn chế về khu vực và truy cập nội dung có thể bị chặn ở một số khu vực nhất định.
Trích xuất liên tục: Bằng cách phân bổ các yêu cầu trên nhiều địa chỉ IP, các proxy luân phiên cho phép trích xuất liên tục mà không bị gián đoạn, điều này có ý nghĩa quyết định đối với việc thu thập dữ liệu quy mô lớn.
Tăng cường tính ẩn danh: Các máy chủ proxy luân phiên giúp tăng cường tính ẩn danh của bạn bằng cách che giấu địa chỉ IP thực của bạn và khiến các trang web khó có thể truy vết hoạt động của bạn trở lại chính bạn.
IPBurger cung cấp các proxy luân phiên chất lượng cao, đảm bảo quá trình thu thập dữ liệu web diễn ra mượt mà. Các proxy của họ được thiết kế để cung cấp một loạt địa chỉ IP đa dạng, tốc độ cao và độ tin cậy cao, khiến chúng trở thành giải pháp lý tưởng để vượt qua các rào cản thu thập dữ liệu web.
Sử dụng các máy chủ proxy dành cho hộ gia đình
Khi nói đến việc tránh bị phát hiện trong quá trình thu thập dữ liệu web, các proxy dân dụng thực sự là một bước đột phá. Hãy cùng tìm hiểu lý do tại sao chúng lại hiệu quả đến vậy và điểm khác biệt giữa chúng với các proxy trung tâm dữ liệu.
Địa chỉ IP thực: Các proxy dân dụng sử dụng các địa chỉ IP do các nhà cung cấp dịch vụ Internet (ISP) cấp cho chủ nhà. Điều này giúp chúng xuất hiện như những người dùng hợp pháp trên các trang web, từ đó giảm khả năng bị phát hiện.
Tỷ lệ bị phát hiện thấp hơn: Do các proxy dân dụng trông giống như người dùng thông thường, nên chúng ít có khả năng bị phát hiện và cấm hơn so với các proxy trung tâm dữ liệu, vốn thường bị các trang web nhận diện và chặn.
Ít có nguy cơ bị đưa vào danh sách đen hơn: Các địa chỉ IP dân dụng ít có nguy cơ bị đưa vào danh sách đen mà các trang web sử dụng để chặn các trình thu thập dữ liệu nghi ngờ. Điều này đảm bảo việc truy cập các trang web diễn ra mượt mà và ổn định hơn.
Định vị địa lý: Các proxy dân cư cho phép bạn truy cập nội dung dành riêng cho các khu vực địa lý nhất định. Tính năng này đặc biệt hữu ích để thu thập dữ liệu theo khu vực hoặc vượt qua các hạn chế địa lý đối với nội dung.
Các proxy dân dụng giúp duy trì tỷ lệ phát hiện thấp như thế nào
Mô hình duyệt web tự nhiên: Các proxy dân cư giúp mô phỏng hành vi của người dùng thực, khiến các trang web khó phân biệt được lưu lượng truy cập hợp pháp với các bot thu thập dữ liệu.
Đa dạng địa chỉ IP: Bằng cách sử dụng một dải địa chỉ IP rộng, các proxy dân dụng phân tán các yêu cầu của bạn, khiến các trang web khó phát hiện các mẫu hành vi và chặn các hoạt động của bạn hơn.
Hiệu suất ổn định: Các proxy dân dụng cung cấp kết nối ổn định và đáng tin cậy, vốn là yếu tố thiết yếu cho các dự án thu thập dữ liệu dài hạn. Điều này giúp giảm thiểu rủi ro gián đoạn và bị chặn.
Tính năng thay đổi luân phiên: Nhiều nhà cung cấp proxy dân dụng, như IPBurger, cung cấp dịch vụ proxy dân dụng thay đổi luân phiên, giúp tự động thay đổi địa chỉ IP của bạn, từ đó giảm thiểu nguy cơ bị phát hiện.
Bắt chước hành vi của con người
Một trong những cách hiệu quả nhất để tránh bị phát hiện khi thu thập dữ liệu trên web là bắt chước hành vi của con người. Các trang web sử dụng nhiều phương pháp khác nhau để phát hiện và chặn bot, nhưng bằng cách làm cho các hoạt động thu thập dữ liệu của bạn trông giống con người hơn, bạn có thể giảm đáng kể nguy cơ bị chặn. Dưới đây là cách thực hiện.
Việc bắt chước hành vi con người giúp tránh bị phát hiện như thế nào
Các trang web được trang bị các thuật toán tinh vi nhằm phát hiện và chặn các bot tự động. Các thuật toán này tìm kiếm các mẫu và hành vi đặc trưng của bot, chẳng hạn như các yêu cầu liên tục, không có chuyển động chuột và các hành động lặp đi lặp lại. Bằng cách bắt chước hành vi của con người, bạn sẽ khiến các hoạt động thu thập dữ liệu của mình trở nên khó dự đoán hơn và khó bị phát hiện hơn.
Cách mô phỏng hành vi con người trong việc thu thập dữ liệu trên web
Khoảng thời gian ngẫu nhiên giữa các yêu cầu
- Tại sao phương pháp này hiệu quả: Con người không nhấp vào các liên kết hay duyệt web theo các khoảng thời gian hoàn toàn đều đặn. Việc đưa yếu tố ngẫu nhiên vào khoảng thời gian giữa các yêu cầu có thể giúp mô phỏng hành vi duyệt web tự nhiên.
Cách thực hiện: Sử dụng mã để tạo ra các khoảng thời gian chờ ngẫu nhiên giữa các yêu cầu. Ví dụ:
import time

import random

urls = ['https://www.example.com/page1', 'https://www.example.com/page2']

for url in urls:

    response = requests.get(url)

    # Process response

    sleep_time = random.uniform(1, 5)  # Sleep for a random time between 1 and 5 seconds

    time.sleep(sleep_time)
Mô phỏng chuyển động và các lần nhấp chuột
- Tại sao phương pháp này hiệu quả: Các bot thường điều hướng mà không cần di chuyển hay nhấp chuột, trong khi con người thì tự nhiên di chuyển chuột và nhấp vào các thành phần.
Cách thực hiện: Sử dụng các thư viện như Selenium để mô phỏng các chuyển động và thao tác nhấp chuột.
from selenium import webdriver

from selenium.webdriver.common.action_chains import ActionChains

driver = webdriver.Chrome()

driver.get('https://www.example.com')

element = driver.find_element_by_id('element_id')

ActionChains(driver).move_to_element(element).click().perform()
Sử dụng các User-Agent thực tế
- Tại sao phương pháp này hiệu quả: Chuỗi User-Agent cung cấp thông tin về trình duyệt và hệ điều hành. Việc sử dụng nhiều chuỗi User-Agent khác nhau và trông giống thật có thể giúp các yêu cầu của bạn trông hợp lệ hơn.
Cách thực hiện: Luân phiên các chuỗi User-Agent cho mỗi yêu cầu.
import requests

url = 'https://www.example.com'

headers = {

    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/112.0.0.0 Safari/537.36'

}

response = requests.get(url, headers=headers)
Giới hạn số lượng yêu cầu trong mỗi phiên
- Tại sao phương pháp này hiệu quả: Việc gửi quá nhiều yêu cầu trong một phiên có thể gây nghi ngờ. Việc giới hạn số lượng yêu cầu trong mỗi phiên có thể giúp mô phỏng thói quen duyệt web của con người.
- Cách thực hiện: Chia các tác vụ thu thập dữ liệu thành các đợt nhỏ hơn và phân bổ chúng ra nhiều phiên thực hiện.
Thực hiện điều hướng nhiều bước
- Tại sao phương pháp này lại hiệu quả: Người dùng thường duyệt các trang web qua nhiều bước thay vì truy cập trực tiếp vào một trang duy nhất. Việc bắt chước hành vi này có thể làm giảm khả năng bị phát hiện.
- Cách thực hiện: Sử dụng các tập lệnh để duyệt qua nhiều trang trước khi đến được dữ liệu mục tiêu.
Luân phiên sử dụng các địa chỉ IP và sử dụng máy chủ proxy
- Tại sao phương pháp này hiệu quả: Con người truy cập các trang web từ nhiều địa chỉ IP khác nhau. Việc luân phiên sử dụng các địa chỉ IP và dùng máy chủ proxy có thể giúp mô phỏng hành vi tự nhiên này.
- Cách thực hiện: Tích hợp các proxy luân phiên vào hệ thống thu thập dữ liệu của bạn.
Nhấp ngẫu nhiên vào các liên kết và tương tác với nội dung
- Tại sao phương pháp này hiệu quả: Con người không chỉ thu thập dữ liệu; họ còn tương tác với nội dung, chẳng hạn như nhấp vào các liên kết và nút bấm.
- Cách thực hiện: Sử dụng các tập lệnh tự động để nhấp ngẫu nhiên vào các liên kết và tương tác với các thành phần trên trang.
Xoay vòng các tiêu đề User-Agent
Một chiến lược hiệu quả để tránh bị chặn khi thu thập dữ liệu web là luân phiên thay đổi các tiêu đề User-Agent. Dưới đây là phân tích chi tiết về cách thức hoạt động của phương pháp này và lý do tại sao nó mang lại lợi ích.
Tiêu đề User-Agent là gì?
Tiêu đề User-Agent là một chuỗi ký tự được gửi kèm theo các yêu cầu HTTP để xác định trình duyệt, hệ điều hành và thiết bị thực hiện yêu cầu. Nó cung cấp cho các trang web thông tin về phần mềm và phần cứng đang được sử dụng để truy cập vào các trang web đó. Các trang web sử dụng thông tin này để tối ưu hóa việc phân phối nội dung, đồng thời cũng dùng nó để phát hiện các hoạt động không phải do con người thực hiện.
Cách xoay vòng các tiêu đề User-Agent có thể ngăn chặn việc bị phát hiện
Tránh nhận diện mẫu
- Tại sao phương pháp này hiệu quả: Việc liên tục sử dụng cùng một chuỗi User-Agent cho nhiều yêu cầu có thể khiến hoạt động của bạn nhanh chóng bị nghi ngờ là bot. Việc luân phiên các tiêu đề User-Agent sẽ tạo ấn tượng rằng các yêu cầu đến từ các trình duyệt và thiết bị khác nhau, từ đó mô phỏng hành vi của con người.
- Lợi ích: Bằng cách thay đổi các chuỗi User-Agent, bạn sẽ giảm thiểu nguy cơ bị phát hiện, vì các trang web sẽ khó xác định được các mẫu trong các yêu cầu của bạn hơn.
Vượt qua cơ chế chặn User-Agent
- Tại sao phương pháp này hiệu quả: Một số trang web chặn các yêu cầu từ các chuỗi User-Agent được xác định là của bot. Bằng cách luân phiên sử dụng một danh sách các chuỗi User-Agent phổ biến và hợp lệ, bạn có thể vượt qua các rào cản này và tiếp tục thu thập dữ liệu mà không bị gián đoạn.
- Lợi ích: Việc sử dụng nhiều chuỗi User-Agent khác nhau từ các trình duyệt và thiết bị phổ biến giúp tránh bị chặn và đảm bảo quyền truy cập liên tục.
Các công cụ để tự động hóa việc luân phiên User-Agent
Có một số công cụ và phương pháp mà bạn có thể sử dụng để tự động hóa việc xoay vòng các tiêu đề User-Agent trong các tập lệnh trích xuất dữ liệu web của mình:
Thư viện Requests của Python với tính năng luân phiên User-Agent
Thực hiện: Sử dụng thư viện Requests trong Python để thay đổi tiêu đề User-Agent trong mỗi yêu cầu.
import requests

import random

url = 'https://www.example.com'

user_agents = [

    'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/112.0.0.0 Safari/537.36',

    'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/90.0.4430.93 Safari/537.36',

    'Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/88.0.4324.150 Safari/537.36',

    # Add more User-Agent strings

]

headers = {

    'User-Agent': random.choice(user_agents)

}

response = requests.get(url, headers=headers)

print(response.content)
Khung công cụ Scrapy với phần mềm trung gian User-Agent
Thực hiện: Scrapy, một khung công tác thu thập dữ liệu web phổ biến, cho phép bạn sử dụng phần mềm trung gian để luân phiên các chuỗi User-Agent.
from scrapy import signals

import random

class RotateUserAgentMiddleware(object):

    user_agents = [

        'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/112.0.0.0 Safari/537.36',

        'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/90.0.4430.93 Safari/537.36',

        'Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/88.0.4324.150 Safari/537.36',

        # Add more User-Agent strings

    ]

    def process_request(self, request, spider):

        request.headers['User-Agent'] = random.choice(self.user_agents)
Các công cụ tự động hóa trình duyệt
Selenium WebDriver: Sử dụng Selenium để thay đổi chuỗi User-Agent khi tự động hóa các thao tác trên trình duyệt.
from selenium import webdriver

from selenium.webdriver.chrome.options import Options

import random

user_agents = [

    'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/112.0.0.0 Safari/537.36',

    'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/90.0.4430.93 Safari/537.36',

    'Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/88.0.4324.150 Safari/537.36',

    # Add more User-Agent strings

]

chrome_options = Options()

chrome_options.add_argument(f"user-agent={random.choice(user_agents)}")

driver = webdriver.Chrome(options=chrome_options)

driver.get('https://www.example.com')
Việc thay đổi luân phiên các tiêu đề User-Agent là một cách đơn giản nhưng hiệu quả để giảm nguy cơ bị chặn khi thu thập dữ liệu web. Bằng cách sử dụng các công cụ như Python Requests, Scrapy và Selenium, bạn có thể tự động hóa quy trình này và đảm bảo các hoạt động thu thập dữ liệu của mình không bị phát hiện.
Quản lý tần suất yêu cầu
Một chiến lược quan trọng để thu thập dữ liệu web thành công là quản lý tần suất yêu cầu một cách hiệu quả. Điều này giúp tránh bị phát hiện và đảm bảo các hoạt động thu thập dữ liệu của bạn có thể diễn ra liên tục mà không bị gián đoạn. Dưới đây là lý do tại sao việc quản lý tần suất yêu cầu lại quan trọng và cách bạn có thể áp dụng cơ chế giới hạn tần suất trong các dự án thu thập dữ liệu web của mình.
Tầm quan trọng của việc quản lý tần suất yêu cầu để tránh bị phát hiện
Ngăn ngừa tình trạng quá tải máy chủ
- Tại sao điều này lại quan trọng: Việc gửi quá nhiều yêu cầu trong một khoảng thời gian ngắn có thể làm quá tải máy chủ của trang web. Điều này không chỉ làm chậm tốc độ trang web đối với người dùng thông thường mà còn kích hoạt các cảnh báo, dẫn đến việc địa chỉ IP của bạn có thể bị chặn.
- Lợi ích: Bằng cách giãn cách các yêu cầu, bạn sẽ giảm tải cho máy chủ, từ đó giúp duy trì hiệu suất hoạt động bình thường của trang web và giảm nguy cơ bị hệ thống đánh dấu là bot.
Tránh gây nghi ngờ
- Tại sao điều này lại quan trọng: Người dùng thực thường không gửi hàng trăm yêu cầu mỗi giây. Tần suất yêu cầu quá cao là dấu hiệu rõ ràng cho thấy có hoạt động của bot. Bằng cách bắt chước hành vi duyệt web của con người, bạn có thể tránh gây nghi ngờ.
- Lợi ích: Việc điều chỉnh tần suất yêu cầu sao cho giống với hoạt động của con người sẽ giúp các hoạt động thu thập dữ liệu của bạn diễn ra một cách kín đáo, từ đó giảm thiểu nguy cơ bị phát hiện và chặn.
Các kỹ thuật triển khai giới hạn tốc độ trong việc thu thập dữ liệu web
Thời gian trễ ngẫu nhiên giữa các yêu cầu
Cách thức hoạt động: Tạo ra các khoảng thời gian chờ ngẫu nhiên giữa mỗi yêu cầu để mô phỏng hành vi duyệt web tự nhiên. Bạn có thể thực hiện điều này bằng cách sử dụng một đoạn mã đơn giản trong mã trích xuất dữ liệu web của mình.
import time

import random

urls = ['https://www.example.com/page1', 'https://www.example.com/page2']

for url in urls:

    response = requests.get(url)

    # Process response

    sleep_time = random.uniform(1, 5)  # Sleep for a random time between 1 and 5 seconds

    time.sleep(sleep_time)
Giới hạn tốc độ cố định
Cách thức hoạt động: Đặt khoảng thời gian chờ cố định giữa các yêu cầu để đảm bảo bạn không vượt quá số lượng yêu cầu nhất định mỗi phút.
import time

urls = ['https://www.example.com/page1', 'https://www.example.com/page2']

for url in urls:

    response = requests.get(url)

    # Process response

    time.sleep(2)  # Sleep for 2 seconds between each request
Giới hạn tốc độ thích ứng
Cách thức hoạt động: Điều chỉnh tần suất yêu cầu dựa trên phản hồi của máy chủ. Ví dụ, nếu thời gian phản hồi của máy chủ tăng lên, hãy giảm tần suất yêu cầu của bạn để tránh làm quá tải máy chủ.
Import time
import requests

urls = ['https://www.example.com/page1', 'https://www.example.com/page2']

for url in urls:

    start_time = time.time()

    response = requests.get(url)

    # Process response

    end_time = time.time()

    response_time = end_time - start_time

    if response_time < 2:

        time.sleep(2 - response_time)  # Ensure a minimum of 2 seconds between requests
Sử dụng thư viện và khung công tác
Scrapy: Scrapy, một khung công tác thu thập dữ liệu web phổ biến, có tính năng hỗ trợ giới hạn tốc độ được tích hợp sẵn. Bạn có thể định cấu hình các thiết lập để kiểm soát thời gian chờ tải xuống.
# settings.py in Scrapy project

DOWNLOAD_DELAY = 2 # Delay in seconds between requests- API và cơ chế giới hạn lưu lượng: Một số API cung cấp các cơ chế giới hạn lưu lượng để giúp quản lý tần suất yêu cầu. Hãy sử dụng các tính năng tích hợp sẵn này để đảm bảo bạn luôn tuân thủ các giới hạn yêu cầu cho phép.
Sử dụng các công cụ giải CAPTCHA
CAPTCHA được thiết kế để phân biệt giữa người dùng thực và các bot tự động. Chúng đưa ra các thử thách mà con người có thể giải quyết dễ dàng nhưng lại khó khăn đối với bot. Tuy nhiên, trong quá trình thu thập dữ liệu web, việc gặp phải CAPTCHA có thể khiến hoạt động của bạn bị gián đoạn. Dưới đây là cách các công cụ giải CAPTCHA phát huy tác dụng và cách chúng có thể giúp bạn vượt qua những thử thách này.
Công cụ giải CAPTCHA là gì?
Các công cụ giải CAPTCHA là những công cụ hoặc dịch vụ tự động hóa quá trình giải các bài kiểm tra CAPTCHA. Chúng sử dụng nhiều kỹ thuật khác nhau, chẳng hạn như nhận dạng ký tự quang học (OCR) và học máy, để giải mã và giải CAPTCHA, giúp công cụ thu thập dữ liệu web của bạn tiếp tục thực hiện các tác vụ mà không cần can thiệp thủ công.
Các công cụ giải CAPTCHA có thể giúp vượt qua các thử thách CAPTCHA như thế nào
Giải pháp tự động hóa
- Tại sao điều này lại quan trọng: Việc giải CAPTCHA thủ công có thể tốn nhiều thời gian và không thực tế đối với các hoạt động thu thập dữ liệu quy mô lớn. Các công cụ giải CAPTCHA tự động xử lý nhiệm vụ này một cách hiệu quả, đảm bảo quá trình thu thập dữ liệu diễn ra liên tục mà không bị gián đoạn.
- Cách thức hoạt động: Các công cụ giải CAPTCHA tích hợp với tập lệnh trích xuất dữ liệu web của bạn, tự động phát hiện và giải các CAPTCHA ngay khi chúng xuất hiện. Chúng có thể xử lý nhiều loại CAPTCHA khác nhau, bao gồm CAPTCHA dựa trên văn bản, hình ảnh và âm thanh.
Tỷ lệ thành công được nâng cao
- Tại sao điều này lại quan trọng: Việc vượt qua CAPTCHA thành công sẽ giúp tăng tỷ lệ thành công khi thu thập dữ liệu. Các công cụ giải CAPTCHA giúp giảm nguy cơ trình thu thập dữ liệu của bạn bị kẹt hoặc bị chặn bởi các thử thách CAPTCHA.
- Cách thức hoạt động: Các công cụ giải CAPTCHA tiên tiến sử dụng các mô hình học máy được huấn luyện trên bộ dữ liệu khổng lồ gồm các CAPTCHA để nâng cao độ chính xác và tốc độ. Điều này đảm bảo rằng ngay cả những CAPTCHA phức tạp nhất cũng được giải quyết nhanh chóng và chính xác.
Tích hợp với các công cụ thu thập dữ liệu
- Tại sao điều này lại quan trọng: Việc tích hợp liền mạch với các công cụ và khung làm việc thu thập dữ liệu phổ biến giúp nâng cao hiệu quả của các hoạt động thu thập dữ liệu của bạn.
- Cách thức hoạt động: Nhiều dịch vụ giải CAPTCHA cung cấp các API có thể dễ dàng tích hợp vào hệ thống thu thập dữ liệu hiện có của bạn. Điều này giúp quá trình vận hành diễn ra trơn tru mà không cần phải thực hiện những thay đổi đáng kể đối với mã nguồn của bạn.
Các ví dụ về công cụ giải CAPTCHA
2Captcha: Một dịch vụ phổ biến sử dụng nhân viên thực hiện việc giải CAPTCHA theo thời gian thực. Dịch vụ này hỗ trợ nhiều loại CAPTCHA khác nhau và cung cấp API để tích hợp.
Ví dụ về tích hợp:
import requests

api_key = 'YOUR_2CAPTCHA_API_KEY'

site_key = 'SITE_KEY_FROM_CAPTCHA'

url = 'https://www.example.com'

captcha_id = requests.post(f'http://2captcha.com/in.php?key={api_key}&method=userrecaptcha&googlekey={site_key}&pageurl={url}').text.split('|')[1]

response = None

while not response:

    response = requests.get(f'http://2captcha.com/res.php?key={api_key}&action=get&id={captcha_id}').text

    if 'CAPCHA_NOT_READY' in response:

        time.sleep(5)

    else:

        response = response.split('|')[1]

# Use the response in your form submissionAnti-Captcha: Một dịch vụ nổi tiếng khác sử dụng cả giải pháp tự động lẫn giải pháp do con người thực hiện để giải CAPTCHA. Dịch vụ này cung cấp một API mạnh mẽ, giúp tích hợp dễ dàng.
Ví dụ về tích hợp:
import anticaptchaofficial.recaptchav2proxyless

solver = anticaptchaofficial.recaptchav2proxyless.recaptchav2Proxyless()

solver.set_verbose(1)

solver.set_key("YOUR_ANTI_CAPTCHA_API_KEY")

solver.set_website_url("https://www.example.com")

solver.set_website_key("SITE_KEY_FROM_CAPTCHA")

response = solver.solve_and_return_solution()

if response != 0:

    print(f"Captcha solved: {response}")

else:

    print(f"Error: {solver.error_code}")
Death by CAPTCHA: Cung cấp cả giải pháp tự động lẫn giải pháp do con người thực hiện để giải CAPTCHA. Nổi tiếng về độ tin cậy và tốc độ, dịch vụ này hỗ trợ đa dạng các loại CAPTCHA.
Ví dụ về tích hợp:
import deathbycaptcha

client = deathbycaptcha.SocketClient('username', 'password')

balance = client.get_balance()

print(f'Balance: {balance}')

captcha = client.decode(url='https://www.example.com')

print(f'CAPTCHA {captcha["captcha"]} solved: {captcha["text"]}')
Trình duyệt không đầu
Trình duyệt không giao diện là một công cụ mạnh mẽ trong bộ công cụ của người thu thập dữ liệu web, giúp quá trình thu thập dữ liệu diễn ra mượt mà và hiệu quả hơn. Nếu bạn đã chán ngán việc bị chặn hoặc cần một phương pháp tiên tiến hơn để xử lý các tác vụ thu thập dữ liệu phức tạp, trình duyệt không giao diện có thể chính là giải pháp bạn đang tìm kiếm.
Trình duyệt không giao diện là gì?
Trình duyệt không giao diện (headless browsers) là những trình duyệt web hoạt động mà không cần giao diện người dùng đồ họa (GUI). Chúng có thể hiển thị các trang web và thực thi JavaScript giống như các trình duyệt truyền thống, nhưng lại chạy ở chế độ nền mà không hiển thị nội dung cho người dùng. Điều này khiến chúng trở thành lựa chọn lý tưởng cho các tác vụ thu thập dữ liệu web tự động, nơi không cần đến việc hiển thị hình ảnh.
Lợi ích của việc sử dụng trình duyệt không giao diện (headless) để trích xuất dữ liệu từ web
Hiệu suất được nâng cao
- Tại sao điều này lại quan trọng: Trình duyệt không giao diện tiêu tốn ít tài nguyên hơn vì chúng không hiển thị đồ họa hay xử lý các yếu tố hình ảnh. Điều này giúp các thao tác thu thập dữ liệu diễn ra nhanh hơn và việc trích xuất dữ liệu hiệu quả hơn.
- Cách thức hoạt động: Nhờ hoạt động ở chế độ nền, các trình duyệt không giao diện giúp giảm tải cho hệ thống của bạn, cho phép bạn trích xuất dữ liệu nhanh hơn và xử lý khối lượng yêu cầu lớn hơn.
Vượt qua hệ thống phát hiện
- Tại sao điều này lại quan trọng: Nhiều trang web sử dụng các cơ chế phát hiện bot có thể nhận diện các phương pháp thu thập dữ liệu truyền thống. Trình duyệt không giao diện (headless browsers) có thể giúp vượt qua một số kỹ thuật phát hiện này bằng cách mô phỏng các tương tác của người dùng thực một cách chân thực hơn.
- Cách thức hoạt động: Các trình duyệt không giao diện có thể tương tác với các trang web giống như người dùng thông thường, bao gồm xử lý việc thực thi JavaScript và tải nội dung động, điều này có thể giúp tránh bị phát hiện.
Tự động hóa nâng cao
- Tại sao điều này lại quan trọng: Đối với các tác vụ trích xuất dữ liệu phức tạp hơn, chẳng hạn như tương tác với các biểu mẫu hoặc duyệt qua nhiều trang, trình duyệt không giao diện (headless browsers) cung cấp các khả năng tự động hóa nâng cao, vượt xa các yêu cầu HTTP đơn thuần.
- Cách thức hoạt động: Chúng hỗ trợ thực thi JavaScript đầy đủ và có thể mô phỏng các tương tác của người dùng như nhấp chuột, cuộn trang và gửi biểu mẫu, từ đó phản ánh chính xác hơn hành vi thực tế của người dùng.
Các công cụ và thư viện dành cho trình duyệt không giao diện người dùng
Nghệ sĩ múa rối
- Tổng quan: Puppeteer là một thư viện Node.js cung cấp giao diện lập trình ứng dụng (API) cấp cao để điều khiển Chrome hoặc Chromium thông qua giao thức DevTools. Thư viện này được sử dụng rộng rãi để trích xuất nội dung động và thực hiện các bài kiểm thử tự động.
- Các tính năng chính: Kiểm soát trình duyệt toàn diện, hỗ trợ chế độ không giao diện, chụp ảnh màn hình và tạo tệp PDF, cùng với các tương tác tự động.
Ví dụ:
const puppeteer = require('puppeteer');

(async () => {

  const browser = await puppeteer.launch({ headless: true });

  const page = await browser.newPage();

  await page.goto('https://www.example.com');

  const content = await page.content();

  console.log(content);

  await browser.close();

})();
Selenium WebDriver
- Tổng quan: Selenium WebDriver là một công cụ được sử dụng rộng rãi để tự động hóa trình duyệt web. Công cụ này hỗ trợ nhiều ngôn ngữ lập trình và trình duyệt, bao gồm cả chế độ không giao diện (headless) cho Chrome và Firefox.
- Các tính năng chính: Hỗ trợ đa trình duyệt, các tương tác nâng cao và sự hỗ trợ rộng rãi từ cộng đồng.
Ví dụ:
from selenium import webdriver

from selenium.webdriver.chrome.options import Options

chrome_options = Options()

chrome_options.add_argument("--headless")

driver = webdriver.Chrome(options=chrome_options)

driver.get('https://www.example.com')

content = driver.page_source

print(content)

driver.quit()
Nhà viết kịch
- Tổng quan: Playwright là một thư viện Node.js do Microsoft phát triển, cho phép tự động hóa việc kiểm thử các ứng dụng web. Thư viện này hỗ trợ nhiều trình duyệt và cung cấp các tính năng tương tự như Puppeteer.
- Các tính năng chính: Hỗ trợ đa trình duyệt, chế độ không giao diện và các tương tác tự động trong các tình huống phức tạp.
Ví dụ:
const { chromium } = require('playwright');

(async () => {

  const browser = await chromium.launch({ headless: true });

  const page = await browser.newPage();

  await page.goto('https://www.example.com');

  const content = await page.content();

  console.log(content);

  await browser.close();

})();
Xử lý các bẫy honeypot
Honeypot là những cái bẫy tinh vi do các trang web giăng ra để bắt quả tang các bot. Chúng có nhiều hình thức khác nhau, mỗi hình thức đều được thiết kế để khai thác hành vi có thể dự đoán trước của các tập lệnh tự động.
Các liên kết và trường ẩn
Hãy tưởng tượng một trang web chứa đầy những cái bẫy vô hình. Các “honeypot” thường bao gồm các trường biểu mẫu, liên kết hoặc nút ẩn mà người dùng thông thường sẽ không bao giờ nhìn thấy hay tương tác với chúng. Tuy nhiên, các bot thường được lập trình để nhấp vào tất cả các liên kết hoặc điền vào tất cả các trường biểu mẫu. Khi chúng tương tác với các yếu tố ẩn này, chúng sẽ kích hoạt cái bẫy.
Mẹo CSS
Các nhà phát triển web sử dụng các thủ thuật CSS để đặt ra những cái bẫy này. Các phần tử có thể được ẩn đi bằng cách sử dụng các thuộc tính như display: none; hoặc visibility: hidden;. Mặc dù người dùng sẽ không nhìn thấy các thành phần này, nhưng các bot không xử lý CSS sẽ tương tác với chúng.
Bị bắt.
Các thử thách JavaScript
Một số honeypot còn tiến xa hơn bằng cách sử dụng JavaScript để thêm các bẫy một cách động sau khi trang web được tải xong. Đây là một chiêu thức thông minh. Các bot không thực thi JavaScript đúng cách sẽ rơi thẳng vào những cái bẫy này.
Ví dụ, một biểu mẫu có thể trông bình thường khi trang được tải lần đầu, nhưng một trường ẩn hoặc liên kết có thể được thêm vào thông qua JavaScript vài giây sau đó. Nếu một bot cố gắng tương tác với phần tử mới này, đó chính là dấu hiệu rõ ràng cho thấy nó là một hệ thống tự động.
Thông minh nhỉ?
Các bẫy mật (honeypots) tận dụng tính dễ dự đoán của bot để chống lại chính chúng. Trong khi người dùng thật có thể duyệt trang web một cách trơn tru, bất kỳ bot nào cố gắng thu thập dữ liệu hoặc gửi spam đều sẽ sa vào những cái bẫy ẩn này.
Các kỹ thuật để tránh bẫy honeypot trong quá trình thu thập dữ liệu web
1. Tránh tương tác với các phần tử ẩn
Phát hiện CSS: Trước khi tương tác với các phần tử, hãy kiểm tra các thuộc tính CSS của chúng để đảm bảo chúng hiển thị được với người dùng. Các phần tử có các thuộc tính như `display: none;` hoặc `visibility: hidden;` nên được bỏ qua.
from bs4 import BeautifulSoup

import requests

url = 'https://www.example.com'

response = requests.get(url)

soup = BeautifulSoup(response.text, 'html.parser')

for link in soup.find_all('a'):

    if 'display' in link.get('style', '') and 'none' in link['style']:

        continue  # Skip hidden link

    # Process visible link
2. Sử dụng các mô hình tương tác giống con người
- Tương tác có chọn lọc: Cấu hình trình thu thập dữ liệu của bạn để chỉ tương tác với những phần tử mà một người dùng thông thường sẽ tương tác. Tránh nhấp vào mọi liên kết hoặc điền vào mọi biểu mẫu một cách bừa bãi.
- Mô phỏng hành vi của con người: Tích hợp các khoảng dừng và độ trễ nhằm mô phỏng hành vi duyệt web của con người, như đã đề cập trong các phần trước.
3. Theo dõi quá trình thực thi JavaScript
Phân tích JavaScript: Sử dụng trình duyệt không giao diện (headless) để hiển thị đầy đủ các trang web và thực thi mã JavaScript. Điều này cho phép bạn phát hiện các bẫy mật (honeypots) được thêm vào động và tránh tương tác với chúng.
from selenium import webdriver

driver = webdriver.Chrome()

driver.get('https://www.example.com')

# Check for dynamically added honeypots

links = driver.find_elements_by_tag_name('a')

for link in links:

    style = link.get_attribute('style')

    if 'display: none;' in style or 'visibility: hidden;' in style:

        continue  # Skip hidden link

    # Process visible link
4. Sử dụng các công cụ trích xuất dữ liệu nâng cao
Scrapy kết hợp với Middleware: Sử dụng middleware của Scrapy để lọc bỏ các honeypot bằng cách kiểm tra các thuộc tính điển hình của honeypot.
lớp IgnoreHoneypotsMiddleware:
def process_spider_output(self, response, result, spider):

        for item in result:

            if isinstance(item, dict):  # Assuming item is a dict

                # Add custom logic to filter honeypots

                if 'honeypot' in item.get('class', ''):

                    continue

        yield item
Kết thúc
Để tránh bị chặn IP và trích xuất dữ liệu thành công từ các trang web, cần phải kết hợp giữa các chiến lược thông minh và các công cụ phù hợp. Bằng cách nắm rõ các kỹ thuật phổ biến mà các trang web sử dụng để chặn các công cụ trích xuất dữ liệu và áp dụng các phương pháp sau đây, bạn có thể giảm đáng kể tình trạng bị chặn khi trích xuất dữ liệu từ web:
- Sử dụng các máy chủ proxy luân phiên: Phân bổ các yêu cầu của bạn trên nhiều địa chỉ IP để tránh bị phát hiện.
- Áp dụng tính năng luân phiên địa chỉ IP: Thường xuyên thay đổi địa chỉ IP để mô phỏng nhiều người dùng và giảm nguy cơ bị cấm.
- Sử dụng proxy dân cư: Sử dụng các địa chỉ IP dân cư thực để tạo ra lưu lượng truy cập trông hợp pháp hơn.
- Mô phỏng hành vi của con người: Hãy làm cho các hoạt động trích xuất dữ liệu của bạn trông tự nhiên hơn bằng cách thêm yếu tố ngẫu nhiên và các tương tác giống con người.
- Xoay vòng các tiêu đề User-Agent: Thay đổi các chuỗi User-Agent để tránh bị các trang web phát hiện.
- Quản lý tần suất yêu cầu: Kiểm soát tần suất gửi yêu cầu để tránh làm quá tải máy chủ.
- Sử dụng các công cụ giải CAPTCHA: Tự động hóa quá trình giải CAPTCHA để vượt qua các rào cản phổ biến này.
- Sử dụng trình duyệt không giao diện đồ họa (Headless Browsers): Tận dụng các trình duyệt chạy mà không cần giao diện đồ họa (GUI) để thực hiện các tác vụ trích xuất dữ liệu phức tạp hơn.
- Xử lý các bẫy honeypot: Phát hiện và tránh các yếu tố ẩn được thiết kế để bắt các bot.
IPBurger cung cấp một bộ giải pháp proxy mạnh mẽ, giúp bạn triển khai các kỹ thuật này một cách hiệu quả. Nhờ các proxy luân phiên, proxy dân dụng và dịch vụ hỗ trợ chuyên nghiệp, bạn có thể đảm bảo rằng các trường hợp bị chặn khi thu thập dữ liệu web sẽ được giảm thiểu đáng kể.
Bạn đã sẵn sàng loại bỏ các rào cản khi thu thập dữ liệu web chưa? Hãy truy cập IPBurger để khám phá các giải pháp proxy tiên tiến của chúng tôi.