Блокировки при веб-парсинге — это настоящая головная боль. Только что вы собирали все нужные данные, а в следующую минуту уже смотрите на сообщение об ошибке.
Досадно, правда?
Веб-сайты становятся всё более эффективными в выявлении попыток скрапинга и их оперативном пресечении. Это не просто небольшая неприятность — это может сорвать весь ваш проект. Маркетинговые исследования, анализ конкурентов, сбор данных — всё это приостанавливается.
Но не волнуйтесь.
Существуют способы обойти эти блокировки и обеспечить бесперебойную работу ваших скриптов.
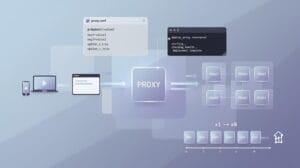
Во-первых, ротация прокси. Они помогут вам избежать блокировки за скрапинг, постоянно меняя ваш IP-адрес, что затрудняет сайтам обнаружение вашей деятельности по скрапингу. Представьте, что вы меняете маскировку каждые несколько минут — вас гораздо сложнее поймать!
Далее, имитируйте поведение человека. Боты, как правило, отправляют быстрые и повторяющиеся запросы, что сразу же выдает их. Снизьте скорость сбора данных. Добавляйте случайные задержки между действиями. Имитируйте движения мыши и щелчки. Благодаря этому ваш сбор данных будет выглядеть так, будто им занимается реальный человек.
Использование резидентных прокси также может стать решающим фактором. В отличие от прокси из центров обработки данных, резидентные прокси используют IP-адреса реальных устройств, благодаря чему они выглядят более легитимными и с меньшей вероятностью будут помечены как подозрительные.
Кроме того, существует метод смены строки «User-Agent». Веб-сайты часто блокируют ботов, распознавая строку «User-Agent» в HTTP-заголовках. Меняя эти заголовки, вы можете создать впечатление, что ваш бот работает под управлением нескольких разных браузеров и устройств.
И наконец, контролируйте частоту отправки запросов. Отправка слишком большого количества запросов за слишком короткий промежуток времени — верный способ попасть под блокировку. Внедрите ограничение частоты запросов, чтобы не привлекать к себе внимания.
Готовы?
Давайте рассмотрим эти стратегии более подробно, чтобы обеспечить бесперебойный сбор данных.
Понимание механизмов блокировки веб-скрейпинга
Веб-скрейпинг — это процесс автоматического извлечения данных с веб-сайтов с помощью программных скриптов. Это мощный инструмент для сбора информации, однако многие веб-сайты принимают активные меры по блокировке скриптов-скрейперов. Почему?
Почему сайты блокируют программы для сбора данных?
Веб-сайты блокируют программы-скрейперы по нескольким причинам:
Нагрузка на сервер: автоматический скрапинг может перегрузить сервер запросами, что приведет к замедлению работы сайта для обычных пользователей. Представьте себе, как десятки ботов одновременно атакуют сайт — это может полностью вывести сервер из строя.
Защита данных: Веб-сайты стремятся защитить свой контент и данные от несанкционированного копирования. Конфиденциальные данные — это настоящая золотая жила, и никто не хочет, чтобы их забирали бесплатно.
Конфиденциальность пользователей: Иногда программы-скрейперы могут собирать личную информацию, что вызывает опасения по поводу конфиденциальности. Ведь никто не хочет, чтобы его данные собирали без его согласия, верно?
Обеспечение соблюдения правил: На веб-сайтах действуют условия предоставления услуг, которые зачастую запрещают автоматический сбор данных, чтобы контролировать способы использования этих данных. Речь идет о том, чтобы обеспечить справедливые и безопасные условия работы.
Как веб-сайты обнаруживают и блокируют скраперы?
Блокировка IP-адресов
Что это такое: веб-сайты отслеживают IP-адреса, с которых поступают запросы. Если с какого-либо IP-адреса за короткий промежуток времени поступает слишком много запросов, он попадает в список подозрительных и блокируется.
Почему это работает: этот метод эффективен, поскольку большинство скриперов работают с одного IP-адреса или небольшого диапазона адресов. Это похоже на то, как поймать спамера, заметив, что он отправляет 50 писем в минуту.
Определение User-Agent
Что это такое: каждый запрос, отправляемый на веб-сайт, содержит строку «User-Agent», которая идентифицирует браузер и операционную систему. Программы-скрейперы часто используют строку «User-Agent» по умолчанию или вообще не используют её, что позволяет легко их обнаружить.
Почему это работает: обнаружение и блокировка необычных строк User-Agent помогает сайтам отличать реальных пользователей от ботов. У ботов, как и в покере, есть свои «признаки».
Ограничение частоты запросов
Что это такое: Веб-сайты ограничивают количество запросов, которые может отправить один IP-адрес или один User-Agent за определённый промежуток времени.
Почему это работает: ограничивая частоту запросов, сайты могут замедлить работу или остановить скриптеры, не создавая неудобств для обычных пользователей. Это похоже на то, как вышибала следит за тем, чтобы в баре не было слишком многолюдно.
Ознакомьтесь с этими методами.
Узнайте, что вызывает блоки.
Тогда вы сможете более эффективно планировать свои действия по сбору данных.
Далее мы рассмотрим конкретные методы обхода этих препятствий.
Следите за новостями.
Эффективные методы предотвращения блокировки при веб-парсинге
Используйте сменяющиеся прокси-серверы
Один из самых эффективных способов избежать блокировки при веб-парсинге — это использование ротационных прокси. Вот как они работают и почему они полезны.
Что такое ротационные прокси?
Вращающиеся прокси предоставляют пул IP-адресов, которые меняются через регулярные промежутки времени или после каждого запроса. Вместо того чтобы отправлять все запросы с одного IP-адреса, который легко можно заметить и заблокировать, вращающиеся прокси распределяют ваши запросы по нескольким IP-адресам.
Трудно обнаружить.
Как сменные прокси помогают избежать блокировки IP-адресов
Распределение IP-адресов: Путем чередования IP-адресов вы имитируете поведение нескольких пользователей, заходящих на сайт из разных мест. Такое распределение затрудняет сайтам выявление закономерностей и введение блокировок.
Снижение риска обнаружения: благодаря использованию сменяющихся прокси каждый запрос выглядит так, будто он поступает от другого пользователя. Это помогает избежать срабатывания ограничений по частоте запросов и блокировок IP-адресов, которые обычно устанавливаются для предотвращения чрезмерного количества запросов с одного IP-адреса.
Работа с капчами: Некоторые продвинутые сервисы ротационных прокси могут помочь обойти капчи, распределяя запросы таким образом, чтобы снизить вероятность появления капч.
Преимущества использования ротационных прокси для веб-парсинга
Повышение показателей успешности: использование сменяющихся прокси-серверов значительно повышает ваши шансы на успешный извлечение данных, позволяя избежать обнаружения и снизить риск блокировки IP-адресов.
Доступ к контенту с географическими ограничениями: благодаря обширной базе IP-адресов из разных географических регионов вы сможете обойти географические ограничения и получить доступ к контенту, который может быть заблокирован в определенных регионах.
Непрерывный скрапинг: благодаря распределению запросов по нескольким IP-адресам ротационные прокси обеспечивают непрерывный скрапинг без перерывов, что имеет решающее значение для сбора данных в больших объемах.
Повышенная анонимность: прокси с ротацией повышают вашу анонимность, маскируя ваш реальный IP-адрес и затрудняя веб-сайтам отслеживание вашей активности до вас.
IPBurger предлагает высококачественные ротационные прокси, обеспечивающие бесперебойный веб-скрейпинг. Их прокси разработаны с учетом обеспечения широкого спектра IP-адресов, высокой скорости и надежности, что делает их идеальным решением для обхода блокировок при веб-скрейпинге.
Используйте прокси-серверы для частного использования
Когда речь заходит о том, как избежать обнаружения при скрапинге веб-страниц, прокси-серверы из жилых районов становятся настоящим прорывом. Давайте разберемся, почему они так эффективны и чем отличаются от прокси-серверов из дата-центров.
Подлинные IP-адреса: в прокси-серверах «для частных пользователей» используются IP-адреса, присваиваемые интернет-провайдерами (ISP) владельцам частных домов. Благодаря этому веб-сайты воспринимают их как легитимных пользователей, что снижает вероятность блокировки.
Более низкая вероятность обнаружения: поскольку прокси-серверы, расположенные в жилых домах, выглядят как обычные пользователи, вероятность их обнаружения и блокировки ниже, чем у прокси-серверов, расположенных в дата-центрах, которые часто распознаются и блокируются веб-сайтами.
Меньше риск попадания в черный список: IP-адреса частных пользователей реже попадают в черные списки, которые веб-сайты используют для блокировки подозрительных скриптов-парсеров. Это обеспечивает более плавный и стабильный доступ к веб-сайтам.
Геотаргетинг: прокси-серверы с домашними адресами позволяют получать доступ к контенту, предназначенному для определенных географических регионов. Это особенно полезно для сбора локализованных данных или обхода географических ограничений на доступ к контенту.
Как прокси-серверы для частного использования помогают поддерживать низкий уровень обнаружения
Естественные модели просмотра: прокси-серверы, расположенные в жилых районах, помогают имитировать поведение реальных пользователей, что затрудняет веб-сайтам различение легитимного трафика и ботов, занимающихся скрапингом.
Разнообразие IP-адресов: благодаря использованию широкого диапазона IP-адресов прокси-серверы для частного использования распределяют ваши запросы, что затрудняет веб-сайтам выявление закономерностей и блокировку ваших действий.
Стабильная производительность: прокси-серверы «Residential» обеспечивают стабильное и надёжное соединение, что крайне важно для долгосрочных проектов по сбору данных. Это снижает риск перебоев в работе и блокировок.
Опции ротации: Многие провайдеры прокси-серверов для частных пользователей, такие как IPBurger, предлагают ротирующиеся прокси-серверы, которые автоматически меняют ваш IP-адрес, что ещё больше снижает вероятность обнаружения.
Имитировать поведение человека
Один из самых эффективных способов избежать обнаружения при скрапинге веб-страниц — имитировать поведение человека. Веб-сайты используют различные методы для обнаружения и блокировки ботов, но если сделать так, чтобы ваши действия по скрапингу выглядели более естественными, вы сможете значительно снизить риск блокировки. Вот как это сделать.
Как имитация поведения человека помогает избежать обнаружения
Веб-сайты оснащены сложными алгоритмами, предназначенными для обнаружения и блокировки автоматизированных ботов. Эти алгоритмы выявляют характерные для ботов закономерности и модели поведения, такие как быстрые запросы, отсутствие движений мыши и повторяющиеся действия. Имитируя поведение человека, вы делаете свои действия по сбору данных менее предсказуемыми и более сложными для обнаружения.
Как имитировать поведение человека при сборе данных из Интернета
Случайные интервалы между запросами
- Почему это работает: люди не переходят по ссылкам и не перемещаются по сайтам с идеально регулярными интервалами. Введение случайности в интервалы между запросами помогает имитировать естественное поведение пользователей при просмотре сайтов.
Как реализовать: Используйте код для генерации случайных интервалов ожидания между запросами. Например:
import time

import random

urls = ['https://www.example.com/page1', 'https://www.example.com/page2']

for url in urls:

    response = requests.get(url)

    # Process response

    sleep_time = random.uniform(1, 5)  # Sleep for a random time between 1 and 5 seconds

    time.sleep(sleep_time)
Моделирование движений и щелчков мыши
- Почему это работает: боты, как правило, перемещаются по странице без каких-либо движений мыши или щелчков, тогда как люди естественным образом двигают мышью и щелкают по элементам.
Как реализовать: Используйте библиотеки, такие как Selenium, для имитации движений мыши и щелчков.
from selenium import webdriver

from selenium.webdriver.common.action_chains import ActionChains

driver = webdriver.Chrome()

driver.get('https://www.example.com')

element = driver.find_element_by_id('element_id')

ActionChains(driver).move_to_element(element).click().perform()
Используйте реалистичные пользовательские агенты
- Почему это работает: Строки User-Agent содержат информацию о браузере и операционной системе. Использование разнообразных реалистичных строк User-Agent может помочь сделать ваши запросы более убедительными.
Как реализовать: чередовать строки User-Agent для каждого запроса.
import requests

url = 'https://www.example.com'

headers = {

    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/112.0.0.0 Safari/537.36'

}

response = requests.get(url, headers=headers)
Ограничение количества запросов за сеанс
- Почему это работает: слишком большое количество запросов за один сеанс может вызвать подозрения. Ограничение количества запросов за сеанс помогает имитировать поведение реального пользователя при просмотре сайта.
- Как это реализовать: разбейте задачи по сбору данных на более мелкие партии и распределите их на несколько сеансов.
Используйте многоступенчатую навигацию
- Почему это работает: Пользователи часто перемещаются по веб-сайтам, выполняя несколько действий, а не переходя напрямую на отдельную страницу. Имитация такого поведения может снизить вероятность обнаружения.
- Как реализовать: Используйте скрипты для перехода по нескольким страницам, прежде чем добраться до целевых данных.
Чередование IP-адресов и использование прокси-серверов
- Почему это работает: Пользователи заходят на сайты с разных IP-адресов. Смена IP-адресов и использование прокси-серверов помогают имитировать это естественное поведение.
- Как реализовать: Внедрите систему сменяющихся прокси-серверов в свою конфигурацию для сбора данных.
Произвольно нажимайте на ссылки и взаимодействуйте с контентом
- Почему это работает: люди не просто собирают данные; они взаимодействуют с контентом, например, нажимая на ссылки и кнопки.
- Как реализовать: Используйте автоматизированные скрипты для случайного перехода по ссылкам и взаимодействия с элементами на странице.
Смена заголовков User-Agent
Одной из эффективных стратегий, позволяющих избежать блокировки при сборе данных из веб-сайтов, является чередование заголовков User-Agent. Ниже подробно рассмотрено, как это работает и в чём заключается преимущество такого подхода.
Что такое заголовки User-Agent?
Заголовок User-Agent — это строка, отправляемая вместе с HTTP-запросами для идентификации браузера, операционной системы и устройства, с которого поступает запрос. Он предоставляет веб-сайтам информацию об используемом программном и аппаратном обеспечении для доступа к ним. Веб-сайты используют эту информацию для оптимизации доставки контента, а также для выявления активности, не связанной с человеком.
Как сменные заголовки User-Agent могут предотвратить обнаружение
Как избежать распознавания шаблонов
- Почему это работает: постоянное использование одной и той же строки User-Agent для нескольких запросов может быстро привести к тому, что ваша активность будет расценена как действие бота. Смена заголовков User-Agent создает впечатление, что запросы поступают с разных браузеров и устройств, что имитирует поведение человека.
- Как это помогает: изменяя строки User-Agent, вы снижаете риск обнаружения, поскольку веб-сайтам становится сложнее выявить закономерности в ваших запросах.
Обход блокировки по User-Agent
- Почему это работает: некоторые веб-сайты блокируют запросы от «User-Agent», характерных для ботов. Переключаясь между строками «User-Agent» из списка распространённых легитимных значений, вы можете обойти эти блокировки и продолжить скрапинг без перерывов.
- Как это помогает: Использование различных строк User-Agent из популярных браузеров и устройств помогает избежать блокировок и обеспечивает постоянный доступ.
Инструменты для автоматизации смены пользовательского агента
Существует несколько инструментов и методов, которые можно использовать для автоматизации смены заголовков User-Agent в ваших скриптах для веб-парсинга:
Библиотека Requests для Python с ротацией User-Agent
Реализация: Используйте библиотеку Requests в Python для смены заголовков User-Agent при каждом запросе.
import requests

import random

url = 'https://www.example.com'

user_agents = [

    'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/112.0.0.0 Safari/537.36',

    'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/90.0.4430.93 Safari/537.36',

    'Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/88.0.4324.150 Safari/537.36',

    # Add more User-Agent strings

]

headers = {

    'User-Agent': random.choice(user_agents)

}

response = requests.get(url, headers=headers)

print(response.content)
Фреймворк Scrapy с промежуточным модулем User-Agent
Реализация: Scrapy — популярный фреймворк для веб-парсинга — позволяет использовать промежуточное ПО для смены строк User-Agent.
from scrapy import signals

import random

class RotateUserAgentMiddleware(object):

    user_agents = [

        'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/112.0.0.0 Safari/537.36',

        'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/90.0.4430.93 Safari/537.36',

        'Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/88.0.4324.150 Safari/537.36',

        # Add more User-Agent strings

    ]

    def process_request(self, request, spider):

        request.headers['User-Agent'] = random.choice(self.user_agents)
Инструменты для автоматизации работы браузера
Selenium WebDriver: Используйте Selenium для смены строк User-Agent при автоматизации взаимодействия с браузером.
from selenium import webdriver

from selenium.webdriver.chrome.options import Options

import random

user_agents = [

    'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/112.0.0.0 Safari/537.36',

    'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/90.0.4430.93 Safari/537.36',

    'Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/88.0.4324.150 Safari/537.36',

    # Add more User-Agent strings

]

chrome_options = Options()

chrome_options.add_argument(f"user-agent={random.choice(user_agents)}")

driver = webdriver.Chrome(options=chrome_options)

driver.get('https://www.example.com')
Смена заголовков User-Agent — это простой, но эффективный способ снизить вероятность блокировки при скрапинге веб-страниц. Используя такие инструменты, как Python Requests, Scrapy и Selenium, вы можете автоматизировать этот процесс и обеспечить незаметность ваших действий по скрапингу.
Управление частотой запросов
Одной из ключевых стратегий успешного веб-скрейпинга является эффективное управление частотой запросов. Это помогает избежать обнаружения и обеспечить бесперебойное выполнение операций по сбору данных. Ниже объясняется, почему управление частотой запросов так важно, и как внедрить ограничение частоты запросов в ваших проектах по веб-скрейпингу.
Важность регулирования частоты запросов для предотвращения обнаружения
Предотвращение перегрузки серверов
- Почему это важно: отправка слишком большого количества запросов за короткий промежуток времени может перегрузить сервер веб-сайта. Это не только замедляет работу сайта для обычных пользователей, но и запускает сигналы тревоги, которые могут привести к блокировке вашего IP-адреса.
- Преимущество: Распределяя запросы во времени, вы снижаете нагрузку на сервер, что помогает поддерживать нормальную производительность сайта и уменьшает вероятность того, что вас сочтут ботом.
Как избежать подозрений
- Почему это важно: обычные пользователи, как правило, не отправляют сотни запросов в секунду. Чрезмерная частота запросов является явным признаком деятельности ботов. Имитируя поведение реальных пользователей при просмотре веб-страниц, вы сможете избежать подозрений.
- Преимущество: Регулирование частоты запросов с целью имитации поведения человека позволяет вашим скрейпинговым операциям оставаться незамеченными, что снижает риск обнаружения и блокировки.
Методы реализации ограничения частоты запросов при веб-парсинге
Случайные задержки между запросами
Как это работает: введите случайные задержки между каждым запросом, чтобы имитировать естественное поведение пользователя при просмотре страниц. Это можно реализовать с помощью простого скрипта в коде для веб-парсинга.
import time

import random

urls = ['https://www.example.com/page1', 'https://www.example.com/page2']

for url in urls:

    response = requests.get(url)

    # Process response

    sleep_time = random.uniform(1, 5)  # Sleep for a random time between 1 and 5 seconds

    time.sleep(sleep_time)
Ограничение фиксированной скорости
Как это работает: установите фиксированную задержку между запросами, чтобы не превысить определённое количество запросов в минуту.
import time

urls = ['https://www.example.com/page1', 'https://www.example.com/page2']

for url in urls:

    response = requests.get(url)

    # Process response

    time.sleep(2)  # Sleep for 2 seconds between each request
Адаптивное ограничение скорости
Как это работает: регулируйте частоту запросов в зависимости от отклика сервера. Например, если время отклика сервера увеличивается, уменьшите частоту запросов, чтобы избежать его перегрузки.
Import time
import requests

urls = ['https://www.example.com/page1', 'https://www.example.com/page2']

for url in urls:

    start_time = time.time()

    response = requests.get(url)

    # Process response

    end_time = time.time()

    response_time = end_time - start_time

    if response_time < 2:

        time.sleep(2 - response_time)  # Ensure a minimum of 2 seconds between requests
Использование библиотек и фреймворков
Scrapy: Scrapy — популярный фреймворк для веб-парсинга — имеет встроенную поддержку ограничения скорости. Вы можете настроить параметры для управления задержкой загрузки.
# settings.py in Scrapy project

DOWNLOAD_DELAY = 2 # Delay in seconds between requests- API и регулирование нагрузки: Некоторые API предоставляют механизмы регулирования нагрузки, помогающие управлять частотой запросов. Используйте эти встроенные функции, чтобы не превышать допустимые лимиты запросов.
Использование программ для разгадывания CAPTCHA
CAPTCHA предназначены для того, чтобы отличать реальных пользователей от автоматизированных ботов. Они представляют собой задачи, которые легко решаются людьми, но затруднительны для ботов. Однако при сборе данных из Интернета появление CAPTCHA может привести к остановке ваших операций. Вот как в этом случае на помощь приходят программы для решения CAPTCHA и как они могут помочь вам обойти эти препятствия.
Что такое программы для разгадывания CAPTCHA?
Программы для решения CAPTCHA — это инструменты или сервисы, которые автоматизируют процесс решения CAPTCHA. Они используют различные методы, такие как оптическое распознавание символов (OCR) и машинное обучение, для декодирования и решения CAPTCHA, что позволяет вашему веб-скрейперу продолжать выполнение своих задач без ручного вмешательства.
Как программы для разгадывания CAPTCHA могут помочь обойти CAPTCHA-задачи
Автоматизированные решения
- Почему это важно: Ручное введение CAPTCHA может быть трудоемким и нецелесообразным для крупномасштабных операций по сбору данных. Автоматические программы для ввода CAPTCHA эффективно справляются с этой задачей, обеспечивая непрерывный сбор данных без перерывов.
- Как это работает: программы для разгадывания CAPTCHA интегрируются с вашим скриптом для веб-парсинга, автоматически обнаруживая и разгадывая CAPTCHA по мере их появления. Они способны обрабатывать различные типы CAPTCHA, в том числе текстовые, графические и аудио-CAPTCHA.
Повышение показателей успешности
- Почему это важно: Успешное обхождение CAPTCHA повышает эффективность вашего скрапера. Программы для решения CAPTCHA снижают вероятность того, что ваш скрапер застрянет или будет заблокирован из-за CAPTCHA.
- Как это работает: Передовые программы для разгадывания CAPTCHA используют модели машинного обучения, обученные на обширных наборах данных CAPTCHA, чтобы повысить точность и скорость работы. Это гарантирует быстрое и правильное разгадывание даже сложных CAPTCHA.
Интеграция с инструментами для сбора данных
- Почему это важно: Безупречная интеграция с популярными инструментами и фреймворками для веб-парсинга повышает эффективность ваших операций по сбору данных.
- Как это работает: Многие сервисы для разгадывания CAPTCHA предоставляют API-интерфейсы, которые можно легко интегрировать в вашу существующую систему скрапинга. Это обеспечивает бесперебойную работу без необходимости внесения существенных изменений в ваш исходный код.
Примеры программ для разгадывания CAPTCHA
2Captcha: популярный сервис, в котором для решения CAPTCHA в режиме реального времени задействуются реальные люди. Он поддерживает различные типы CAPTCHA и предоставляет API для интеграции.
Пример интеграции:
import requests

api_key = 'YOUR_2CAPTCHA_API_KEY'

site_key = 'SITE_KEY_FROM_CAPTCHA'

url = 'https://www.example.com'

captcha_id = requests.post(f'http://2captcha.com/in.php?key={api_key}&method=userrecaptcha&googlekey={site_key}&pageurl={url}').text.split('|')[1]

response = None

while not response:

    response = requests.get(f'http://2captcha.com/res.php?key={api_key}&action=get&id={captcha_id}').text

    if 'CAPCHA_NOT_READY' in response:

        time.sleep(5)

    else:

        response = response.split('|')[1]

# Use the response in your form submissionAnti-Captcha: ещё один известный сервис, использующий как автоматизированные, так и ручные методы для решения капч. Он предлагает надёжный API для удобной интеграции.
Пример интеграции:
import anticaptchaofficial.recaptchav2proxyless

solver = anticaptchaofficial.recaptchav2proxyless.recaptchav2Proxyless()

solver.set_verbose(1)

solver.set_key("YOUR_ANTI_CAPTCHA_API_KEY")

solver.set_website_url("https://www.example.com")

solver.set_website_key("SITE_KEY_FROM_CAPTCHA")

response = solver.solve_and_return_solution()

if response != 0:

    print(f"Captcha solved: {response}")

else:

    print(f"Error: {solver.error_code}")
Death by CAPTCHA: предлагает как автоматические, так и ручные способы прохождения CAPTCHA. Сервис известен своей надёжностью и скоростью работы и поддерживает широкий спектр типов CAPTCHA.
Пример интеграции:
import deathbycaptcha

client = deathbycaptcha.SocketClient('username', 'password')

balance = client.get_balance()

print(f'Balance: {balance}')

captcha = client.decode(url='https://www.example.com')

print(f'CAPTCHA {captcha["captcha"]} solved: {captcha["text"]}')
Безголовые браузеры
«Безголовые» браузеры — это мощный инструмент в арсенале специалистов по веб-парсингу, позволяющий сделать процесс сбора данных более плавным и эффективным. Если вы устали от блокировок или вам нужен более продвинутый способ решения сложных задач по сбору данных, «безголовые» браузеры могут оказаться именно тем, что вам нужно.
Что такое браузеры без интерфейса?
«Безголовые» браузеры — это веб-браузеры, работающие без графического интерфейса пользователя (GUI). Они могут отображать веб-страницы и выполнять JavaScript так же, как и традиционные браузеры, но работают в фоновом режиме, не показывая контент пользователю. Это делает их идеальным решением для автоматизированных задач по извлечению данных из веб-страниц, где визуальное отображение не требуется.
Преимущества использования браузеров без интерфейса для веб-парсинга
Повышенная производительность
- Почему это важно: «безголовые» браузеры потребляют меньше ресурсов, поскольку не отображают графику и не обрабатывают визуальные элементы. Это способствует ускорению операций сбора данных и повышению эффективности их извлечения.
- Принцип работы: Работая в фоновом режиме, браузеры без графического интерфейса снижают нагрузку на систему, что позволяет быстрее извлекать данные и обрабатывать большие объемы запросов.
Обход системы обнаружения
- Почему это важно: Многие веб-сайты используют механизмы обнаружения ботов, способные выявлять традиционные методы скрапинга. «Бесголовые» браузеры помогают обойти некоторые из этих методов обнаружения, более точно имитируя взаимодействие реальных пользователей.
- Принцип работы: «Безголовые» браузеры могут взаимодействовать с веб-страницами так же, как и обычные пользователи, в том числе обеспечивать выполнение JavaScript и загрузку динамического контента, что помогает избежать обнаружения.
Расширенная автоматизация
- Почему это важно: для более сложных задач по сбору данных, таких как заполнение форм или переход по нескольким страницам, «безголовые» браузеры предоставляют расширенные возможности автоматизации, выходящие за рамки простых HTTP-запросов.
- Принцип работы: они поддерживают полное выполнение кода JavaScript и могут имитировать действия пользователей, такие как клики, прокрутку страницы и отправку форм, что позволяет более точно воспроизвести реальное поведение пользователей.
Инструменты и библиотеки для просмотра веб-страниц в режиме без интерфейса
Puppeteer
- Обзор: Puppeteer — это библиотека Node.js, предоставляющая высокоуровневый API для управления Chrome или Chromium через протокол DevTools. Она широко используется для извлечения динамического контента и проведения автоматизированного тестирования.
- Основные возможности: полное управление браузером, поддержка режима без интерфейса, создание снимков экрана и PDF-файлов, а также автоматизированные взаимодействия.
Пример:
const puppeteer = require('puppeteer');

(async () => {

  const browser = await puppeteer.launch({ headless: true });

  const page = await browser.newPage();

  await page.goto('https://www.example.com');

  const content = await page.content();

  console.log(content);

  await browser.close();

})();
Selenium WebDriver
- Обзор: Selenium WebDriver — широко используемый инструмент для автоматизации работы веб-браузеров. Он поддерживает множество языков программирования и браузеров, включая режимы без интерфейса для Chrome и Firefox.
- Основные особенности: кроссбраузерная совместимость, расширенные возможности взаимодействия и широкая поддержка со стороны сообщества.
Пример:
from selenium import webdriver

from selenium.webdriver.chrome.options import Options

chrome_options = Options()

chrome_options.add_argument("--headless")

driver = webdriver.Chrome(options=chrome_options)

driver.get('https://www.example.com')

content = driver.page_source

print(content)

driver.quit()
Драматург
- Обзор: Playwright — это библиотека Node.js, разработанная компанией Microsoft, которая позволяет проводить автоматическое тестирование веб-приложений. Она поддерживает множество браузеров и предоставляет возможности, аналогичные Puppeteer.
- Основные особенности: поддержка различных браузеров, режим без интерфейса и автоматизированное взаимодействие в сложных сценариях.
Пример:
const { chromium } = require('playwright');

(async () => {

  const browser = await chromium.launch({ headless: true });

  const page = await browser.newPage();

  await page.goto('https://www.example.com');

  const content = await page.content();

  console.log(content);

  await browser.close();

})();
Работа с ловушками «медовый горшок»
«Ханипоты» — это хитроумные ловушки, которые веб-сайты расставляют, чтобы поймать ботов с поличным. Они бывают разных видов, и каждый из них рассчитан на то, чтобы использовать предсказуемое поведение автоматизированных скриптов.
Скрытые ссылки и поля
Представьте себе веб-страницу, наполненную невидимыми ловушками. «Медовые ловушки» часто содержат скрытые поля форм, ссылки или кнопки, которые обычный пользователь никогда не увидит и с которыми никогда не будет взаимодействовать. Боты же, как правило, запрограммированы так, чтобы нажимать на все ссылки или заполнять все поля форм. Когда они взаимодействуют с этими скрытыми элементами, они срабатывают как ловушка.
CSS-хитрости
Веб-разработчики используют CSS-трюки, чтобы устанавливать такие «ловушки». Элементы можно скрыть с помощью таких свойств, как display: none; или visibility: hidden;. Хотя пользователи-люди не увидят эти элементы, боты, не обрабатывающие CSS, будут с ними взаимодействовать.
Попался.
Задачи по JavaScript
Некоторые «медовые ловушки» идут ещё дальше, используя JavaScript для динамического добавления ловушек после загрузки страницы. Это умный ход. Боты, которые не могут правильно выполнять JavaScript, попадают прямо в эти ловушки.
Например, при первоначальной загрузке страницы форма может выглядеть обычно, но через несколько секунд с помощью JavaScript может быть добавлено скрытое поле или ссылка. Если бот попытается взаимодействовать с этим новым элементом, это станет явным признаком его автоматизированного характера.
Умно, правда?
«Медовые ловушки» используют предсказуемость поведения ботов против них самих. В то время как реальные пользователи беспрепятственно перемещаются по сайту, любой бот, пытающийся собрать данные или рассылать спам, попадает в эти скрытые ловушки.
Методы, позволяющие избежать ловушек типа «ханипот» при веб-парсинге
1. Избегайте взаимодействия со скрытыми элементами
Проверка CSS: перед взаимодействием с элементами необходимо проверить их свойства CSS, чтобы убедиться, что они отображаются пользователям. Элементы со свойствами, такими как `display: none;` или `visibility: hidden;`, следует игнорировать.
from bs4 import BeautifulSoup

import requests

url = 'https://www.example.com'

response = requests.get(url)

soup = BeautifulSoup(response.text, 'html.parser')

for link in soup.find_all('a'):

    if 'display' in link.get('style', '') and 'none' in link['style']:

        continue  # Skip hidden link

    # Process visible link
2. Использование моделей взаимодействия, напоминающих человеческое поведение
- Избирательное взаимодействие: настройте свой скрейпер так, чтобы он взаимодействовал только с теми элементами, с которыми обычно взаимодействует человек. Не следует без разбора нажимать на каждую ссылку или заполнять каждую форму.
- Моделирование поведения человека: включите паузы и задержки, имитирующие поведение человека при просмотре веб-страниц, как описано в предыдущих разделах.
3. Мониторинг выполнения JavaScript
Анализ JavaScript: используйте браузеры без графического интерфейса для полной прорисовки страниц и выполнения кода JavaScript. Это позволяет обнаруживать динамически добавляемые «медовые ловушки» и избегать взаимодействия с ними.
from selenium import webdriver

driver = webdriver.Chrome()

driver.get('https://www.example.com')

# Check for dynamically added honeypots

links = driver.find_elements_by_tag_name('a')

for link in links:

    style = link.get_attribute('style')

    if 'display: none;' in style or 'visibility: hidden;' in style:

        continue  # Skip hidden link

    # Process visible link
4. Используйте расширенные инструменты для сбора данных
Scrapy с использованием промежуточного программного обеспечения: используйте промежуточное программное обеспечение Scrapy для отсеивания ханипотов путем проверки на наличие типичных атрибутов ханипотов.
класс IgnoreHoneypotsMiddleware:
def process_spider_output(self, response, result, spider):

        for item in result:

            if isinstance(item, dict):  # Assuming item is a dict

                # Add custom logic to filter honeypots

                if 'honeypot' in item.get('class', ''):

                    continue

        yield item
Заключение
Чтобы избежать IP-блокировок и успешно собирать данные с веб-сайтов, необходимо сочетать продуманные стратегии и правильные инструменты. Понимая, какие распространённые методы используют веб-сайты для блокировки скриперов, и применяя приведённые ниже методы, вы сможете значительно сократить количество блокировок при сборе данных:
- Используйте сменяющиеся прокси-серверы: распределяйте запросы по нескольким IP-адресам, чтобы избежать обнаружения.
- Включите ротацию IP-адресов: регулярно меняйте IP-адреса, чтобы имитировать работу нескольких пользователей и снизить риск блокировки.
- Используйте прокси-серверы с домашними адресами: используйте подлинные домашние IP-адреса для создания более естественного трафика.
- Имитация поведения человека: Сделайте свои действия по сбору данных более естественными, добавив элемент случайности и взаимодействия, характерные для человека.
- Чередование заголовков User-Agent: изменение строк User-Agent, чтобы избежать отметки со стороны веб-сайтов.
- Управление частотой запросов: регулируйте частоту отправки запросов, чтобы не перегружать серверы.
- Используйте программы для разгадывания CAPTCHA: автоматизируйте процесс разгадывания CAPTCHA, чтобы обойти эти распространённые средства блокировки.
- Используйте браузеры без графического интерфейса: применяйте браузеры, работающие без графического интерфейса, для выполнения более сложных задач по извлечению данных.
- Работа с ловушками «медового улья»: обнаружение и обход скрытых элементов, предназначенных для поимки ботов.
IPBurger предлагает набор мощных прокси-решений, которые помогут вам эффективно применять эти методы. Благодаря ротационным прокси, прокси с частных адресов и надежной технической поддержке вы сможете значительно снизить количество блокировок при веб-парсинге.
Готовы избавиться от блокировок при скрапинге веб-сайтов? Посетите сайт IPBurger, чтобы ознакомиться с нашими передовыми прокси-решениями.