Web-Scraping-Blockaden sind äußerst lästig. In einem Moment sammeln Sie noch alle benötigten Daten, und im nächsten starren Sie schon auf eine Fehlermeldung.
Das ist doch frustrierend, oder?
Websites werden immer besser darin, Scraping-Aktivitäten zu erkennen und diese umgehend zu unterbinden. Dies ist nicht nur ein kleines Ärgernis – es kann Ihr gesamtes Projekt zum Scheitern bringen. Marktforschung, Wettbewerbsanalyse, Datenaggregation – all dies kommt zum Erliegen.
Aber machen Sie sich keine Sorgen.
Es gibt Möglichkeiten, diese Sperren zu umgehen und dafür zu sorgen, dass Ihre Web-Scraping-Vorgänge reibungslos ablaufen.
Zunächst einmal: rotierende Proxys. Diese können Ihnen dabei helfen, einer Sperre zu entgehen, indem sie Ihre IP-Adresse ständig ändern und es Websites so erschweren, Ihre Scraping-Aktivitäten zu erkennen. Stellen Sie sich das so vor, als würden Sie alle paar Minuten Ihre Tarnung wechseln – so sind Sie viel schwerer zu erwischen!
Als Nächstes sollten Sie menschliches Verhalten nachahmen. Bots neigen dazu, schnelle, sich wiederholende Anfragen zu stellen, was ein eindeutiges Erkennungsmerkmal ist. Führen Sie das Scraping langsamer durch. Fügen Sie zwischen den einzelnen Aktionen zufällige Verzögerungen ein. Simulieren Sie Mausbewegungen und Klicks. Dadurch wirkt Ihr Scraping eher so, als würde es von einer echten Person durchgeführt.
Die Verwendung von Residential-Proxys kann ebenfalls entscheidende Vorteile mit sich bringen. Im Gegensatz zu Rechenzentrums-Proxys nutzen Residential-Proxys IP-Adressen von echten Geräten, wodurch sie seriöser wirken und weniger leicht als verdächtig eingestuft werden.
Dann gibt es noch die User-Agent-Rotation. Websites blockieren Bots häufig, indem sie die User-Agent-Zeichenfolge in den HTTP-Headern erkennen. Durch die Rotation dieser Header können Sie Ihren Bot so darstellen, als handele es sich um mehrere verschiedene Browser und Geräte.
Zu guter Letzt sollten Sie Ihre Anfrageraten kontrollieren. Wenn Sie zu viele Anfragen zu schnell senden, werden Sie mit Sicherheit gesperrt. Führen Sie eine Ratenbegrenzung ein, um nicht aufzufallen.
Sind Sie bereit?
Lassen Sie uns diese Strategien genauer betrachten, damit Ihre Datenerfassung reibungslos weiterläuft.
Web-Scraping-Blöcke verstehen
Unter „Web Scraping“ versteht man den Vorgang der automatischen Extraktion von Daten aus Websites mithilfe von Software-Skripten. Es handelt sich dabei um ein leistungsstarkes Werkzeug zur Informationsbeschaffung, doch viele Websites unternehmen aktive Schritte, um Scraper zu blockieren. Warum?
Warum blockieren Websites Web-Scraper?
Websites blockieren Scraper aus verschiedenen Gründen:
Serverauslastung: Automatisiertes Scraping kann einen Server mit Anfragen überlasten und die Website für normale Nutzer verlangsamen. Stellen Sie sich vor, Dutzende von Bots würden eine Website gleichzeitig bombardieren; dies kann den Server lahmlegen.
Datenschutz: Websites möchten ihre Inhalte und Daten vor unbefugtem Kopieren schützen. Geschützte Daten sind eine Goldgrube, und niemand möchte, dass diese kostenlos entnommen werden.
Datenschutz: Scraper können mitunter personenbezogene Daten erfassen, was Datenschutzbedenken aufwirft. Niemand möchte, dass seine Daten ohne seine Zustimmung gesammelt werden, nicht wahr?
Durchsetzung von Richtlinien: Websites verfügen über Nutzungsbedingungen, die automatisiertes Scraping häufig untersagen, um die Kontrolle darüber zu behalten, wie ihre Daten genutzt werden. Es geht darum, faire und sichere Rahmenbedingungen zu gewährleisten.
Wie erkennen und blockieren Websites Scraper?
Sperrung von IP-Adressen
Was dahintersteckt: Websites überwachen die IP-Adressen, von denen Anfragen stammen. Wenn eine IP-Adresse innerhalb kurzer Zeit zu viele Anfragen stellt, wird sie markiert und gesperrt.
Warum dies funktioniert: Diese Methode ist wirksam, da die meisten Scraper von einer einzigen IP-Adresse oder einem kleinen Adressbereich aus operieren. Es ist so, als würde man einen Spammer überführen, indem man bemerkt, dass er 50 E-Mails pro Minute versendet.
Erkennung des User-Agents
Was es ist: Jede an eine Website gesendete Anfrage enthält eine User-Agent-Zeichenkette, die den Browser und das Betriebssystem identifiziert. Scraper verwenden häufig Standard-User-Agent-Zeichenketten oder gar keine, wodurch sie leicht zu erkennen sind.
Warum dies funktioniert: Das Erkennen und Blockieren ungewöhnlicher User-Agent-Zeichenfolgen hilft Websites dabei, zwischen menschlichen Nutzern und Bots zu unterscheiden. Bots haben verräterische Anzeichen, genau wie beim Poker.
Anfrage zur Begrenzung der Anfragerate
Was es ist: Websites begrenzen die Anzahl der Anfragen, die eine einzelne IP-Adresse oder ein einzelner User-Agent innerhalb eines bestimmten Zeitraums stellen kann.
Warum dies funktioniert: Durch die Begrenzung der Anfragerate können Websites Webcrawler verlangsamen oder stoppen, ohne dass normale Nutzer davon beeinträchtigt werden. Es ist so, als würde ein Türsteher dafür sorgen, dass die Bar nicht zu überfüllt ist.
Machen Sie sich mit diesen Methoden vertraut.
Erfahren Sie, was Blockaden auslöst.
Auf diese Weise können Sie Ihre Scraping-Aktivitäten besser planen.
Als Nächstes werden wir uns mit konkreten Techniken befassen, mit denen sich diese Hindernisse umgehen lassen.
Bleiben Sie auf dem Laufenden.
Wirksame Methoden zur Vermeidung von Web-Scraping-Sperren
Verwenden Sie wechselnde Proxyserver
Eine der wirksamsten Methoden, um Sperren beim Web-Scraping zu vermeiden, ist der Einsatz von rotierenden Proxys. Hier erfahren Sie, wie diese funktionieren und warum sie von Vorteil sind.
Was sind rotierende Proxys?
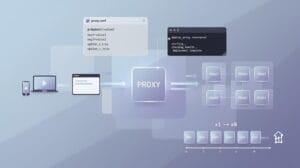
Rotierende Proxys stellen einen Pool von IP-Adressen bereit, die sich in regelmäßigen Abständen oder nach jeder Anfrage ändern. Anstatt alle Ihre Anfragen von einer einzigen IP-Adresse aus zu stellen – die leicht markiert und blockiert werden kann –, verteilen rotierende Proxys Ihre Anfragen auf mehrere IP-Adressen.
Schwieriger zu erkennen.
Wie wechselnde Proxys dabei helfen, IP-Sperren zu vermeiden
Verteilung der IP-Adressen: Durch den Wechsel der IP-Adressen ahmen Sie das Verhalten mehrerer Nutzer nach, die von verschiedenen Standorten aus auf die Website zugreifen. Diese Streuung erschwert es Websites, Muster zu erkennen und Sperren zu verhängen.
Geringeres Risiko, entdeckt zu werden: Durch den Einsatz wechselnder Proxys scheint jede Anfrage von einem anderen Nutzer zu stammen. Dies trägt dazu bei, Ratenbeschränkungen und IP-Sperren zu vermeiden, die üblicherweise eingerichtet werden, um eine übermäßige Anzahl von Anfragen von einer einzelnen IP-Adresse zu verhindern.
Umgang mit Captchas: Einige fortschrittliche Rotations-Proxy-Dienste können dabei helfen, Captchas zu umgehen, indem sie die Anfragen so verteilen, dass die Wahrscheinlichkeit, Captcha-Abfragen auszulösen, verringert wird.
Vorteile der Verwendung rotierender Proxys beim Web-Scraping
Höhere Erfolgsquoten: Durch den Wechsel der Proxys erhöhen Sie Ihre Chancen auf eine erfolgreiche Datenextraktion erheblich, da Sie so einer Erkennung entgehen und das Risiko von IP-Sperren verringern.
Zugriff auf geografisch eingeschränkte Inhalte: Dank eines vielfältigen Pools an IP-Adressen aus verschiedenen geografischen Regionen können Sie geografische Beschränkungen umgehen und auf Inhalte zugreifen, die in bestimmten Regionen möglicherweise gesperrt sind.
Kontinuierliches Scraping: Durch die Verteilung der Anfragen auf mehrere IP-Adressen ermöglichen rotierende Proxys ein kontinuierliches Scraping ohne Unterbrechungen, was für die Datenerfassung in großem Umfang von entscheidender Bedeutung ist.
Verbesserte Anonymität: Rotierende Proxys erhöhen Ihre Anonymität, indem sie Ihre tatsächliche IP-Adresse verbergen und es Websites erschweren, Ihre Aktivitäten zu Ihnen zurückzuverfolgen.
IPBurger bietet hochwertige rotierende Proxys, die ein reibungsloses Web-Scraping gewährleisten. Die Proxys des Anbieters sind darauf ausgelegt, eine vielfältige Auswahl an IP-Adressen, hohe Geschwindigkeit und Zuverlässigkeit zu bieten, wodurch sie sich ideal zur Umgehung von Web-Scraping-Sperren eignen.
Verwenden Sie Privat-Proxys
Wenn es darum geht, beim Web-Scraping einer Erkennung zu entgehen, sind Residential-Proxys ein entscheidender Faktor. Lassen Sie uns untersuchen, warum sie so effektiv sind und wie sie sich von Rechenzentrums-Proxys unterscheiden.
Echte IP-Adressen: Privathaushalts-Proxys verwenden IP-Adressen, die von Internetdienstanbietern (ISPs) an Privathaushalte vergeben werden. Dadurch erscheinen sie auf Websites als legitime Nutzer, was die Wahrscheinlichkeit verringert, dass sie als verdächtig markiert werden.
Geringere Erkennungsraten: Da Wohn-Proxys wie normale Nutzer erscheinen, ist die Wahrscheinlichkeit, dass sie erkannt und gesperrt werden, geringer als bei Rechenzentrums-Proxys, die von Websites häufig erkannt und blockiert werden.
Geringere Wahrscheinlichkeit, auf eine Sperrliste zu geraten: Private IP-Adressen werden seltener in die Sperrlisten aufgenommen, die Websites zur Blockierung mutmaßlicher Web-Scraper verwenden. Dies gewährleistet einen reibungsloseren und konsistenteren Zugriff auf Websites.
Geo-Targeting: Mit Residential-Proxys können Sie auf Inhalte zugreifen, die für bestimmte geografische Regionen bestimmt sind. Dies ist besonders nützlich, um lokalisierte Daten zu extrahieren oder geografische Beschränkungen für Inhalte zu umgehen.
Wie Residential-Proxys dazu beitragen, die Erkennungsrate niedrig zu halten
Natürliche Surfgewohnheiten: Privat-Proxys helfen dabei, das Verhalten echter Nutzer nachzuahmen, wodurch es für Websites schwierig wird, zwischen legitimem Datenverkehr und Scraping-Bots zu unterscheiden.
Vielfalt an IP-Adressen: Durch die Nutzung einer breiten Palette von IP-Adressen verteilen Residential-Proxys Ihre Anfragen, wodurch es für Websites schwieriger wird, Muster zu erkennen und Ihre Aktivitäten zu blockieren.
Konstante Leistung: Residential-Proxys bieten stabile und zuverlässige Verbindungen, die für langfristige Scraping-Projekte unerlässlich sind. Dadurch wird das Risiko von Unterbrechungen und Sperrungen verringert.
Rotierende Optionen: Viele Anbieter von Privat-Proxys, wie beispielsweise IPBurger, bieten rotierende Privat-Proxys an, die Ihre IP-Adresse automatisch ändern und so das Risiko einer Erkennung weiter verringern.
Menschliches Verhalten nachahmen
Eine der wirksamsten Methoden, um beim Web-Scraping nicht entdeckt zu werden, besteht darin, menschliches Verhalten nachzuahmen. Websites nutzen verschiedene Methoden, um Bots zu erkennen und zu blockieren; indem Sie Ihre Scraping-Aktivitäten jedoch menschlicher erscheinen lassen, können Sie das Risiko einer Sperrung erheblich verringern. So geht’s.
Wie das Nachahmen menschlichen Verhaltens dabei hilft, nicht entdeckt zu werden
Websites sind mit ausgeklügelten Algorithmen ausgestattet, die darauf ausgelegt sind, automatisierte Bots zu erkennen und zu blockieren. Diese Algorithmen suchen nach Mustern und Verhaltensweisen, die für Bots typisch sind, wie beispielsweise schnelle Anfragen, fehlende Mausbewegungen und sich wiederholende Aktionen. Indem Sie menschliches Verhalten nachahmen, machen Sie Ihre Scraping-Aktivitäten weniger vorhersehbar und schwerer zu erkennen.
Wie man menschliches Verhalten beim Web-Scraping nachahmt
Zufällige Intervalle zwischen den Anfragen
- Warum dies funktioniert: Menschen klicken nicht in perfekt regelmäßigen Abständen auf Links oder navigieren auf Websites. Durch das Einfügen von Zufälligkeit in die Zeitabstände zwischen den Anfragen lässt sich das natürliche Surfverhalten besser nachahmen.
Vorgehensweise: Verwenden Sie Code, um zufällige Wartezeiten zwischen den Anfragen zu generieren. Beispiel:
import time

import random

urls = ['https://www.example.com/page1', 'https://www.example.com/page2']

for url in urls:

    response = requests.get(url)

    # Process response

    sleep_time = random.uniform(1, 5)  # Sleep for a random time between 1 and 5 seconds

    time.sleep(sleep_time)
Mausbewegungen und Klicks simulieren
- Warum dies funktioniert: Bots navigieren in der Regel ohne Mausbewegungen oder Klicks, während Menschen die Maus ganz natürlich bewegen und auf Elemente klicken.
So gehen Sie vor: Verwenden Sie Bibliotheken wie Selenium, um Mausbewegungen und Klicks zu simulieren.
from selenium import webdriver

from selenium.webdriver.common.action_chains import ActionChains

driver = webdriver.Chrome()

driver.get('https://www.example.com')

element = driver.find_element_by_id('element_id')

ActionChains(driver).move_to_element(element).click().perform()
Verwenden Sie realistische User-Agents
- Warum dies funktioniert: User-Agent-Strings liefern Informationen über den Browser und das Betriebssystem. Die Verwendung einer Vielzahl realistischer User-Agent-Strings kann dazu beitragen, dass Ihre Anfragen seriöser wirken.
Vorgehensweise: Wechseln Sie die User-Agent-Zeichenfolgen bei jeder Anfrage.
import requests

url = 'https://www.example.com'

headers = {

    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/112.0.0.0 Safari/537.36'

}

response = requests.get(url, headers=headers)
Begrenzung der Anzahl der Anfragen pro Sitzung
- Warum dies funktioniert: Zu viele Anfragen in einer einzigen Sitzung können Verdacht erregen. Durch die Begrenzung der Anzahl der Anfragen pro Sitzung lassen sich die Surfgewohnheiten eines Menschen besser nachahmen.
- Vorgehensweise: Teilen Sie Ihre Scraping-Aufgaben in kleinere Teilmengen auf und verteilen Sie diese auf mehrere Sitzungen.
Nutzung der mehrstufigen Navigation
- Warum dies funktioniert: Nutzer navigieren auf Websites häufig in mehreren Schritten, anstatt direkt auf eine einzelne Seite zuzugreifen. Die Nachahmung dieses Verhaltens kann die Wahrscheinlichkeit einer Erkennung verringern.
- Vorgehensweise: Verwenden Sie Skripte, um mehrere Seiten zu durchlaufen, bevor Sie zu den Zieldaten gelangen.
IP-Adressen wechseln und Proxys verwenden
- Warum dies funktioniert: Menschen greifen von verschiedenen IP-Adressen auf Websites zu. Durch den Wechsel der IP-Adressen und die Nutzung von Proxys lässt sich dieses natürliche Verhalten simulieren.
- Vorgehensweise: Integrieren Sie rotierende Proxys in Ihre Scraping-Konfiguration.
Klicken Sie nach dem Zufallsprinzip auf Links und interagieren Sie mit den Inhalten
- Warum dies funktioniert: Menschen beschränken sich nicht darauf, Daten zu extrahieren; sie interagieren mit Inhalten, indem sie beispielsweise auf Links und Schaltflächen klicken.
- Vorgehensweise: Verwenden Sie automatisierte Skripte, um nach dem Zufallsprinzip auf Links zu klicken und mit Elementen auf der Seite zu interagieren.
User-Agent-Header rotieren
Eine wirksame Strategie, um beim Web-Scraping nicht blockiert zu werden, besteht darin, Ihre User-Agent-Header zu wechseln. Hier erfahren Sie im Detail, wie dies funktioniert und warum es von Vorteil ist.
Was sind User-Agent-Header?
Ein „User-Agent“-Header ist eine Zeichenfolge, die zusammen mit HTTP-Anfragen gesendet wird, um den Browser, das Betriebssystem und das Gerät zu identifizieren, von dem die Anfrage stammt. Er liefert Websites Informationen über die Software und Hardware, die für den Zugriff auf diese Websites verwendet werden. Websites nutzen diese Informationen, um die Bereitstellung von Inhalten zu optimieren, aber auch, um nicht-menschliche Aktivitäten zu erkennen.
Wie das Wechseln von User-Agent-Headern die Erkennung verhindern kann
Vermeidung der Mustererkennung
- Warum dies funktioniert: Die konsequente Verwendung derselben User-Agent-Zeichenkette für mehrere Anfragen kann dazu führen, dass Ihre Aktivitäten schnell als Bot erkannt werden. Durch den Wechsel der User-Agent-Header entsteht der Eindruck, dass die Anfragen von verschiedenen Browsern und Geräten stammen, wodurch menschliches Verhalten nachgeahmt wird.
- So funktioniert es: Durch die Variation der User-Agent-Zeichenfolgen verringern Sie das Risiko, entdeckt zu werden, da es für Websites schwieriger wird, Muster in Ihren Anfragen zu erkennen.
Umgehung der User-Agent-Sperre
- Warum dies funktioniert: Einige Websites blockieren Anfragen von bekannten Bot-User-Agents. Indem Sie abwechselnd eine Liste gängiger, legitimer User-Agent-Zeichenfolgen verwenden, können Sie diese Sperren umgehen und das Scraping ohne Unterbrechungen fortsetzen.
- So funktioniert es: Durch die Verwendung verschiedener User-Agent-Strings gängiger Browser und Geräte lassen sich Sperren vermeiden und ein kontinuierlicher Zugriff gewährleisten.
Tools zur Automatisierung der User-Agent-Rotation
Es gibt verschiedene Tools und Methoden, mit denen Sie die Rotation der User-Agent-Header in Ihren Web-Scraping-Skripten automatisieren können:
Python-Requests-Bibliothek mit User-Agent-Rotation
Umsetzung: Verwenden Sie die „Requests“-Bibliothek in Python, um die User-Agent-Header bei jeder Anfrage zu wechseln.
import requests

import random

url = 'https://www.example.com'

user_agents = [

    'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/112.0.0.0 Safari/537.36',

    'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/90.0.4430.93 Safari/537.36',

    'Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/88.0.4324.150 Safari/537.36',

    # Add more User-Agent strings

]

headers = {

    'User-Agent': random.choice(user_agents)

}

response = requests.get(url, headers=headers)

print(response.content)
Das Scrapy-Framework mit User-Agent-Middleware
Implementierung: Mit Scrapy, einem beliebten Web-Scraping-Framework, können Sie mithilfe von Middleware die User-Agent-Strings rotieren lassen.
from scrapy import signals

import random

class RotateUserAgentMiddleware(object):

    user_agents = [

        'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/112.0.0.0 Safari/537.36',

        'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/90.0.4430.93 Safari/537.36',

        'Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/88.0.4324.150 Safari/537.36',

        # Add more User-Agent strings

    ]

    def process_request(self, request, spider):

        request.headers['User-Agent'] = random.choice(self.user_agents)
Tools zur Browser-Automatisierung
Selenium WebDriver: Verwenden Sie Selenium, um User-Agent-Zeichenfolgen bei der Automatisierung von Browser-Interaktionen zu wechseln.
from selenium import webdriver

from selenium.webdriver.chrome.options import Options

import random

user_agents = [

    'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/112.0.0.0 Safari/537.36',

    'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/90.0.4430.93 Safari/537.36',

    'Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/88.0.4324.150 Safari/537.36',

    # Add more User-Agent strings

]

chrome_options = Options()

chrome_options.add_argument(f"user-agent={random.choice(user_agents)}")

driver = webdriver.Chrome(options=chrome_options)

driver.get('https://www.example.com')
Das Wechseln der User-Agent-Header ist eine einfache, aber wirksame Methode, um das Risiko einer Sperrung durch Web-Scraping zu verringern. Mithilfe von Tools wie Python Requests, Scrapy und Selenium können Sie diesen Vorgang automatisieren und sicherstellen, dass Ihre Scraping-Aktivitäten unbemerkt bleiben.
Anfragequoten verwalten
Eine entscheidende Strategie für erfolgreiches Web-Scraping besteht darin, Ihre Anfrageraten effektiv zu steuern. Dies trägt dazu bei, eine Erkennung zu vermeiden und sicherzustellen, dass Ihre Scraping-Aktivitäten ohne Unterbrechungen fortgesetzt werden können. Im Folgenden erfahren Sie, warum die Steuerung der Anfrageraten wichtig ist und wie Sie eine Ratenbegrenzung in Ihren Web-Scraping-Projekten umsetzen können.
Die Bedeutung der Steuerung der Anfrageraten zur Vermeidung einer Entdeckung
Vermeidung einer Überlastung der Server
- Warum dies wichtig ist: Das Senden zu vieler Anfragen innerhalb kurzer Zeit kann den Server einer Website überlasten. Dies verlangsamt nicht nur die Website für normale Nutzer, sondern löst auch Warnmeldungen aus, die dazu führen können, dass Ihre IP-Adresse gesperrt wird.
- Vorteil: Indem Sie Ihre Anfragen zeitlich staffeln, entlasten Sie den Server, was dazu beiträgt, die normale Leistung der Website aufrechtzuerhalten und die Wahrscheinlichkeit zu verringern, als Bot identifiziert zu werden.
Verdacht vermeiden
- Warum dies wichtig ist: Menschliche Nutzer senden in der Regel nicht Hunderte von Anfragen pro Sekunde. Übermäßig hohe Anfrageraten sind ein eindeutiges Anzeichen für Bot-Aktivitäten. Indem Sie das Surfverhalten eines Menschen nachahmen, können Sie vermeiden, Verdacht zu erregen.
- Vorteil: Durch die Steuerung der Anfrageraten, sodass diese dem menschlichen Verhalten nachempfunden sind, bleiben Ihre Scraping-Aktivitäten unbemerkt, wodurch sich das Risiko einer Erkennung und Sperrung verringert.
Methoden zur Umsetzung von Ratenbegrenzung beim Web-Scraping
Zufällige Verzögerungen zwischen den Anfragen
So funktioniert es: Fügen Sie zwischen den einzelnen Anfragen zufällige Verzögerungen ein, um ein natürliches Surfverhalten nachzuahmen. Dies lässt sich mithilfe eines einfachen Skripts in Ihrem Web-Scraping-Code erreichen.
import time

import random

urls = ['https://www.example.com/page1', 'https://www.example.com/page2']

for url in urls:

    response = requests.get(url)

    # Process response

    sleep_time = random.uniform(1, 5)  # Sleep for a random time between 1 and 5 seconds

    time.sleep(sleep_time)
Feste Ratenbegrenzung
So funktioniert es: Legen Sie eine feste Verzögerung zwischen den Anfragen fest, um sicherzustellen, dass Sie eine bestimmte Anzahl von Anfragen pro Minute nicht überschreiten.
import time

urls = ['https://www.example.com/page1', 'https://www.example.com/page2']

for url in urls:

    response = requests.get(url)

    # Process response

    time.sleep(2)  # Sleep for 2 seconds between each request
Adaptive Ratenbegrenzung
So funktioniert es: Passen Sie die Anfragerate entsprechend der Antwort des Servers an. Sollte sich beispielsweise die Antwortzeit des Servers verlängern, verringern Sie die Anfragerate, um eine Überlastung des Servers zu vermeiden.
Import time
import requests

urls = ['https://www.example.com/page1', 'https://www.example.com/page2']

for url in urls:

    start_time = time.time()

    response = requests.get(url)

    # Process response

    end_time = time.time()

    response_time = end_time - start_time

    if response_time < 2:

        time.sleep(2 - response_time)  # Ensure a minimum of 2 seconds between requests
Verwendung von Bibliotheken und Frameworks
Scrapy: Scrapy, ein beliebtes Web-Scraping-Framework, verfügt über eine integrierte Unterstützung für die Ratenbegrenzung. Sie können die Einstellungen so konfigurieren, dass die Download-Verzögerung gesteuert wird.
# settings.py in Scrapy project

DOWNLOAD_DELAY = 2 # Delay in seconds between requests- APIs und Drosselung: Einige APIs bieten Drosselungsmechanismen zur Steuerung der Anfragerate. Nutzen Sie diese integrierten Funktionen, um sicherzustellen, dass Sie die zulässigen Anfragegrenzen einhalten.
CAPTCHA-Löser verwenden
CAPTCHAs dienen dazu, zwischen menschlichen Nutzern und automatisierten Bots zu unterscheiden. Sie stellen Aufgaben, die für Menschen einfach, für Bots jedoch schwer zu lösen sind. Beim Web-Scraping kann das Auftreten eines CAPTCHAs Ihre Vorgänge jedoch zum Stillstand bringen. Hier erfahren Sie, wie CAPTCHA-Lösungsprogramme zum Einsatz kommen und wie sie Ihnen helfen können, diese Hürden zu umgehen.
Was sind CAPTCHA-Löser?
CAPTCHA-Löser sind Tools oder Dienste, die das Lösen von CAPTCHA-Aufgaben automatisieren. Sie nutzen verschiedene Techniken wie die optische Zeichenerkennung (OCR) und maschinelles Lernen, um das CAPTCHA zu entschlüsseln und zu lösen, sodass Ihr Web-Scraper seine Aufgaben ohne manuellen Eingriff fortsetzen kann.
Wie CAPTCHA-Löser dabei helfen können, CAPTCHA-Hürden zu umgehen
Automatisierte Lösungen
- Warum dies wichtig ist: Das manuelle Lösen von CAPTCHAs kann zeitaufwendig und für groß angelegte Scraping-Vorgänge unpraktisch sein. Automatisierte CAPTCHA-Löser bewältigen diese Aufgabe effizient und gewährleisten so ein unterbrechungsfreies Scraping.
- So funktioniert es: CAPTCHA-Löser lassen sich in Ihr Web-Scraping-Skript integrieren und erkennen sowie lösen CAPTCHAs automatisch, sobald diese erscheinen. Sie können verschiedene Arten von CAPTCHAs verarbeiten, darunter textbasierte, bildbasierte und Audio-CAPTCHAs.
Verbesserte Erfolgsquoten
- Warum dies wichtig ist: Die erfolgreiche Umgehung von CAPTCHAs erhöht Ihre Erfolgsquote beim Web-Scraping. CAPTCHA-Löser verringern die Wahrscheinlichkeit, dass Ihr Scraper bei CAPTCHA-Prüfungen ins Stocken gerät oder blockiert wird.
- So funktioniert es: Fortschrittliche CAPTCHA-Löser nutzen Modelle des maschinellen Lernens, die anhand umfangreicher CAPTCHA-Datensätze trainiert wurden, um die Genauigkeit und Geschwindigkeit zu verbessern. Dadurch wird sichergestellt, dass selbst komplexe CAPTCHAs schnell und korrekt gelöst werden.
Integration mit Scraping-Tools
- Warum dies wichtig ist: Die nahtlose Integration mit gängigen Scraping-Tools und -Frameworks steigert die Effizienz Ihrer Scraping-Vorgänge.
- So funktioniert es: Viele CAPTCHA-Lösungsdienste bieten APIs an, die sich problemlos in Ihre bestehende Scraping-Umgebung integrieren lassen. Dies ermöglicht einen reibungslosen Betrieb, ohne dass wesentliche Änderungen an Ihrem Code erforderlich sind.
Beispiele für CAPTCHA-Löser
2Captcha: Ein beliebter Dienst, der menschliche Mitarbeiter einsetzt, um CAPTCHAs in Echtzeit zu lösen. Er unterstützt verschiedene Arten von CAPTCHAs und bietet eine API zur Integration.
Anwendungsbeispiel:
import requests

api_key = 'YOUR_2CAPTCHA_API_KEY'

site_key = 'SITE_KEY_FROM_CAPTCHA'

url = 'https://www.example.com'

captcha_id = requests.post(f'http://2captcha.com/in.php?key={api_key}&method=userrecaptcha&googlekey={site_key}&pageurl={url}').text.split('|')[1]

response = None

while not response:

    response = requests.get(f'http://2captcha.com/res.php?key={api_key}&action=get&id={captcha_id}').text

    if 'CAPCHA_NOT_READY' in response:

        time.sleep(5)

    else:

        response = response.split('|')[1]

# Use the response in your form submissionAnti-Captcha: Ein weiterer bekannter Dienst, der sowohl automatisierte als auch manuelle Lösungen zum Lösen von CAPTCHAs einsetzt. Er bietet eine robuste API für eine einfache Integration.
Anwendungsbeispiel:
import anticaptchaofficial.recaptchav2proxyless

solver = anticaptchaofficial.recaptchav2proxyless.recaptchav2Proxyless()

solver.set_verbose(1)

solver.set_key("YOUR_ANTI_CAPTCHA_API_KEY")

solver.set_website_url("https://www.example.com")

solver.set_website_key("SITE_KEY_FROM_CAPTCHA")

response = solver.solve_and_return_solution()

if response != 0:

    print(f"Captcha solved: {response}")

else:

    print(f"Error: {solver.error_code}")
Death by CAPTCHA: Bietet sowohl automatisierte als auch manuelle Lösungen zur Eingabe von CAPTCHAs. Das Programm ist für seine Zuverlässigkeit und Schnelligkeit bekannt und unterstützt eine Vielzahl von CAPTCHA-Typen.
Anwendungsbeispiel:
import deathbycaptcha

client = deathbycaptcha.SocketClient('username', 'password')

balance = client.get_balance()

print(f'Balance: {balance}')

captcha = client.decode(url='https://www.example.com')

print(f'CAPTCHA {captcha["captcha"]} solved: {captcha["text"]}')
Headless-Browser
Headless-Browser sind ein leistungsstarkes Werkzeug im Werkzeugkasten eines Web-Scrapers und ermöglichen einen nahtloseren und effizienteren Scraping-Prozess. Wenn Sie es leid sind, blockiert zu werden, oder eine fortgeschrittenere Methode zur Bewältigung komplexer Scraping-Aufgaben benötigen, könnten Headless-Browser genau das Richtige für Sie sein.
Was sind Headless-Browser?
Headless-Browser sind Webbrowser, die ohne grafische Benutzeroberfläche (GUI) arbeiten. Sie können Webseiten darstellen und JavaScript ausführen, genau wie herkömmliche Browser, laufen jedoch im Hintergrund, ohne dem Benutzer den Inhalt anzuzeigen. Dadurch eignen sie sich ideal für automatisierte Web-Scraping-Aufgaben, bei denen eine visuelle Darstellung nicht erforderlich ist.
Vorteile der Verwendung von Headless-Browsern für das Web-Scraping
Verbesserte Leistung
- Warum dies von Bedeutung ist: Headless-Browser verbrauchen weniger Ressourcen, da sie keine Grafiken darstellen und keine visuellen Elemente verarbeiten. Dies führt zu schnelleren Scraping-Vorgängen und einer effizienteren Datenextraktion.
- So funktioniert es: Da Headless-Browser im Hintergrund laufen, entlasten sie Ihr System, sodass Sie Daten schneller auslesen und größere Mengen an Anfragen bearbeiten können.
Umgehung der Erkennung
- Warum dies wichtig ist: Viele Websites nutzen Mechanismen zur Bot-Erkennung, die herkömmliche Scraping-Methoden identifizieren können. Headless-Browser können dazu beitragen, einige dieser Erkennungstechniken zu umgehen, indem sie echte Benutzerinteraktionen genauer nachahmen.
- So funktioniert es: Headless-Browser können mit Webseiten genauso interagieren wie normale Nutzer, einschließlich der Ausführung von JavaScript und des Ladens dynamischer Inhalte, was dazu beitragen kann, eine Erkennung zu vermeiden.
Fortgeschrittene Automatisierung
- Warum dies wichtig ist: Für komplexere Scraping-Aufgaben, wie beispielsweise die Interaktion mit Formularen oder die Navigation durch mehrere Seiten, bieten Headless-Browser erweiterte Automatisierungsfunktionen, die über einfache HTTP-Anfragen hinausgehen.
- So funktioniert es: Sie unterstützen die vollständige Ausführung von JavaScript und können Benutzerinteraktionen wie Klicks, Bildlaufbewegungen und das Absenden von Formularen simulieren, wodurch eine genauere Darstellung des tatsächlichen Nutzerverhaltens ermöglicht wird.
Tools und Bibliotheken für das Headless-Browsing
Puppenspieler
- Übersicht: Puppeteer ist eine Node.js-Bibliothek, die eine High-Level-API zur Steuerung von Chrome oder Chromium über das DevTools-Protokoll bereitstellt. Sie wird häufig zum Auslesen dynamischer Inhalte und zur Durchführung automatisierter Tests eingesetzt.
- Wichtigste Funktionen: Vollständige Browser-Steuerung, Unterstützung des Headless-Modus, Erstellung von Screenshots und PDF-Dateien sowie automatisierte Interaktionen.
Beispiel:
const puppeteer = require('puppeteer');

(async () => {

  const browser = await puppeteer.launch({ headless: true });

  const page = await browser.newPage();

  await page.goto('https://www.example.com');

  const content = await page.content();

  console.log(content);

  await browser.close();

})();
Selenium WebDriver
- Überblick: Selenium WebDriver ist ein weit verbreitetes Tool zur Automatisierung von Webbrowsern. Es unterstützt zahlreiche Programmiersprachen und Browser, darunter auch den Headless-Modus für Chrome und Firefox.
- Wichtigste Merkmale: Browserübergreifende Kompatibilität, erweiterte Interaktionsmöglichkeiten und umfassende Unterstützung durch die Community.
Beispiel:
from selenium import webdriver

from selenium.webdriver.chrome.options import Options

chrome_options = Options()

chrome_options.add_argument("--headless")

driver = webdriver.Chrome(options=chrome_options)

driver.get('https://www.example.com')

content = driver.page_source

print(content)

driver.quit()
Dramatiker
- Überblick: „Playwright“ ist eine von Microsoft entwickelte Node.js-Bibliothek, die das automatisierte Testen von Webanwendungen ermöglicht. Sie unterstützt mehrere Browser und bietet ähnliche Funktionen wie „Puppeteer“.
- Wichtigste Funktionen: Browserübergreifende Unterstützung, Headless-Modus und automatisierte Interaktionen in komplexen Szenarien.
Beispiel:
const { chromium } = require('playwright');

(async () => {

  const browser = await chromium.launch({ headless: true });

  const page = await browser.newPage();

  await page.goto('https://www.example.com');

  const content = await page.content();

  console.log(content);

  await browser.close();

})();
Umgang mit Honeypot-Fallen
Honeypots sind raffinierte Fallen, die von Websites aufgestellt werden, um Bots auf frischer Tat zu ertappen. Es gibt sie in verschiedenen Formen, die jeweils darauf ausgelegt sind, das vorhersehbare Verhalten automatisierter Skripte auszunutzen.
Versteckte Links und Felder
Stellen Sie sich eine Webseite vor, die voller unsichtbarer Fallen ist. Honeypots enthalten oft versteckte Formularfelder, Links oder Schaltflächen, die ein gewöhnlicher Nutzer niemals sehen oder mit denen er niemals interagieren würde. Bots hingegen sind in der Regel so programmiert, dass sie auf alle Links klicken oder alle Formularfelder ausfüllen. Wenn sie mit diesen versteckten Elementen interagieren, lösen sie die Falle aus.
CSS-Tricks
Webentwickler nutzen CSS-Tricks, um diese Fallen zu stellen. Elemente lassen sich mithilfe von Eigenschaften wie display: none; oder visibility: hidden;. Während menschliche Nutzer diese Elemente nicht sehen, interagieren Bots, die CSS nicht verarbeiten, mit ihnen.
Erwischt.
JavaScript-Herausforderungen
Einige Honeypots gehen noch einen Schritt weiter und fügen mithilfe von JavaScript nach dem Laden der Seite dynamisch Fallen hinzu. Dies ist ein geschickter Schachzug. Bots, die JavaScript nicht ordnungsgemäß ausführen, tappen direkt in diese Fallen.
Beispielsweise kann ein Formular beim ersten Laden der Seite normal erscheinen, doch einige Sekunden später wird möglicherweise über JavaScript ein verstecktes Feld oder ein Link hinzugefügt. Versucht ein Bot, mit diesem neuen Element zu interagieren, ist dies ein eindeutiges Indiz für seinen automatisierten Charakter.
Clever, nicht wahr?
Honeypots nutzen die Vorhersehbarkeit von Bots gegen diese selbst aus. Während menschliche Nutzer nahtlos durch die Website navigieren, gerät jeder Bot, der versucht, Daten zu scrapen oder Spam zu versenden, in diese versteckten Fallen.
Methoden zur Vermeidung von Honeypot-Fallen beim Web-Scraping
1. Vermeiden Sie die Interaktion mit verborgenen Elementen
CSS-Erkennung: Bevor Sie mit Elementen interagieren, überprüfen Sie deren CSS-Eigenschaften, um sicherzustellen, dass sie für menschliche Nutzer sichtbar sind. Elemente mit Eigenschaften wie „display: none;“ oder „visibility: hidden;“ sollten ignoriert werden.
from bs4 import BeautifulSoup

import requests

url = 'https://www.example.com'

response = requests.get(url)

soup = BeautifulSoup(response.text, 'html.parser')

for link in soup.find_all('a'):

    if 'display' in link.get('style', '') and 'none' in link['style']:

        continue  # Skip hidden link

    # Process visible link
2. Verwenden Sie menschenähnliche Interaktionsmuster
- Selektive Interaktion: Konfigurieren Sie Ihren Scraper so, dass er nur mit Elementen interagiert, mit denen auch ein typischer menschlicher Benutzer interagieren würde. Vermeiden Sie es, wahllos auf jeden Link zu klicken oder jedes Formular auszufüllen.
- Menschliches Verhalten simulieren: Bauen Sie Pausen und Verzögerungen ein, die das Surfverhalten von Menschen nachahmen, wie in den vorangegangenen Abschnitten erläutert.
3. Überwachung der JavaScript-Ausführung
JavaScript-Analyse: Verwenden Sie Headless-Browser, um Seiten vollständig darzustellen und JavaScript auszuführen. Auf diese Weise können Sie dynamisch hinzugefügte Honeypots erkennen und eine Interaktion mit diesen vermeiden.
from selenium import webdriver

driver = webdriver.Chrome()

driver.get('https://www.example.com')

# Check for dynamically added honeypots

links = driver.find_elements_by_tag_name('a')

for link in links:

    style = link.get_attribute('style')

    if 'display: none;' in style or 'visibility: hidden;' in style:

        continue  # Skip hidden link

    # Process visible link
4. Nutzen Sie erweiterte Scraping-Tools
Scrapy mit Middleware: Nutzen Sie die Middleware von Scrapy, um Honeypots herauszufiltern, indem Sie auf typische Honeypot-Merkmale prüfen.
Klasse „IgnoreHoneypotsMiddleware“:
def process_spider_output(self, response, result, spider):

        for item in result:

            if isinstance(item, dict):  # Assuming item is a dict

                # Add custom logic to filter honeypots

                if 'honeypot' in item.get('class', ''):

                    continue

        yield item
Schlussfolgerung
Um IP-Sperren zu vermeiden und Daten erfolgreich von Websites zu extrahieren, bedarf es einer Kombination aus cleveren Strategien und den richtigen Tools. Indem Sie die gängigen Techniken verstehen, mit denen Websites Scraper blockieren, und die folgenden Methoden anwenden, können Sie Blockierungen beim Web-Scraping erheblich reduzieren:
- Verwenden Sie wechselnde Proxys: Verteilen Sie Ihre Anfragen auf mehrere IP-Adressen, um eine Erkennung zu vermeiden.
- IP-Rotation implementieren: Wechseln Sie regelmäßig die IP-Adressen, um den Eindruck mehrerer Nutzer zu erwecken und das Risiko von Sperren zu verringern.
- Nutzung von Wohn-Proxys: Verwenden Sie echte Wohn-IP-Adressen, um den Datenverkehr authentischer erscheinen zu lassen.
- Menschliches Verhalten nachahmen: Lassen Sie Ihre Scraping-Aktivitäten natürlich wirken, indem Sie Zufälligkeiten und menschenähnliche Interaktionen einbauen.
- User-Agent-Header rotieren: Ändern Sie die User-Agent-Zeichenfolgen, um zu vermeiden, dass Sie von Websites als verdächtig eingestuft werden.
- Anfrageraten verwalten: Steuern Sie die Häufigkeit Ihrer Anfragen, um eine Überlastung der Server zu vermeiden.
- Verwenden Sie CAPTCHA-Löser: Automatisieren Sie das Lösen von CAPTCHAs, um diese häufigen Sperren zu umgehen.
- Nutzen Sie Headless-Browser: Setzen Sie Browser ein, die ohne grafische Benutzeroberfläche laufen, um komplexere Scraping-Aufgaben durchzuführen.
- Umgang mit Honeypot-Fallen: Erkennen und vermeiden Sie versteckte Elemente, die dazu dienen, Bots abzufangen.
IPBurger bietet eine Reihe leistungsstarker Proxy-Lösungen an, mit denen Sie diese Techniken effektiv umsetzen können. Dank der rotierenden Proxys, der Residential-Proxys und des zuverlässigen Supports können Sie sicherstellen, dass Ihre Web-Scraping-Sperren deutlich reduziert werden.
Sind Sie bereit, Sperren beim Web-Scraping zu umgehen? Besuchen Sie IPBurger und entdecken Sie unsere fortschrittlichen Proxy-Lösungen.