تعد حالات تعطل عملية استخراج البيانات من الويب أمرًا مزعجًا. ففي لحظة ما تكون بصدد جمع كل البيانات التي تحتاجها، وفي اللحظة التالية تجد نفسك تنظر إلى رسالة خطأ.
هذا محبط، أليس كذلك؟
أصبحت المواقع الإلكترونية أكثر كفاءة في اكتشاف أنشطة استخراج البيانات وإيقافها بسرعة. وهذا ليس مجرد إزعاج بسيط — بل يمكن أن يعطل مشروعك بالكامل. أبحاث السوق، وتحليل المنافسة، وتجميع البيانات — كلها تتوقف.
لكن لا تقلق.
هناك طرق للتغلب على هذه الحواجز والحفاظ على سير عمليات الاستخراج بسلاسة.
أولاً، البروكسيات المتناوبة. يمكن أن تساعدك هذه البروكسيات على تجنب الحظر من خلال تغيير عنوان IP الخاص بك باستمرار، مما يجعل من الصعب على المواقع الإلكترونية اكتشاف أنشطة الاستخراج التي تقوم بها. تخيل الأمر وكأنك تغير تنكرك كل بضع دقائق — فسيصبح من الصعب جدًا اكتشافك!
بعد ذلك، قم بمحاكاة السلوك البشري. تميل الروبوتات إلى إرسال طلبات سريعة ومتكررة، وهو ما يُعد دليلاً واضحاً على وجودها. قم بإبطاء عملية استخراج البيانات. أضف فترات تأخير عشوائية بين الإجراءات. قم بمحاكاة حركات الماوس والنقرات. وهذا يجعل عملية استخراج البيانات تبدو وكأنها تتم بواسطة شخص حقيقي.
كما أن استخدام البروكسيات السكنية يمكن أن يُحدث فرقًا جذريًّا. وعلى عكس بروكسيات مراكز البيانات، تستخدم البروكسيات السكنية عناوين IP من أجهزة حقيقية، مما يجعلها تبدو أكثر شرعية وأقل عرضةً للكشف.
ثم هناك «تناوب User-Agent». غالبًا ما تحجب مواقع الويب الروبوتات من خلال الكشف عن سلسلة User-Agent في رؤوس HTTP. ومن خلال تناوب هذه الرؤوس، يمكنك جعل الروبوت الخاص بك يبدو وكأنه يعمل على عدة متصفحات وأجهزة مختلفة.
وأخيرًا، قم بإدارة معدلات الطلبات الخاصة بك. إن إرسال عدد كبير جدًّا من الطلبات في وقت قصير جدًّا هو طريقة مؤكدة للتعرض للحظر. قم بتطبيق آلية تحديد المعدل لتبقى بعيدًا عن الأنظار.
جاهز؟
دعونا نتعمق في هذه الاستراتيجيات بمزيد من التفصيل ونضمن استمرار عملية جمع البيانات دون انقطاع.
فهم حجب عمليات استخراج البيانات من الويب
يُعرف «استخراج البيانات من الويب» بأنه عملية استخراج البيانات تلقائيًّا من مواقع الويب باستخدام برامج نصية. وهي أداة فعالة لجمع المعلومات، لكن العديد من مواقع الويب تعمل جاهدةً على حجب برامج استخراج البيانات. لماذا؟
لماذا تحجب المواقع الإلكترونية برامج استخراج البيانات؟
تحظر المواقع الإلكترونية برامج استخراج البيانات لأسباب عديدة:
حمل الخادم: قد يؤدي الاستخراج الآلي إلى إثقال كاهل الخادم بالطلبات، مما يؤدي إلى إبطاء سرعة الموقع بالنسبة للمستخدمين العاديين. تخيل عشرات الروبوتات تهاجم الموقع في وقت واحد؛ فهذا قد يؤدي إلى تعطل الخادم تمامًا.
حماية البيانات: تسعى المواقع الإلكترونية إلى حماية محتواها وبياناتها من النسخ دون إذن. فالبيانات المسجلة الملكية تعد منجم ذهب، ولا أحد يرغب في أن يتم الحصول عليها مجانًا.
خصوصية المستخدم: قد تقوم برامج الاستخراج أحيانًا بجمع معلومات شخصية، مما يثير مخاوف تتعلق بالخصوصية. لا أحد يرغب في أن يتم جمع بياناته دون موافقته، أليس كذلك؟
تطبيق السياسات: تتضمن مواقع الويب شروط خدمة تحظر في كثير من الأحيان عملية الاستخراج الآلي للبيانات، وذلك للحفاظ على السيطرة على كيفية استخدام بياناتها. والهدف من ذلك هو الحفاظ على بيئة عادلة وآمنة.
كيف تكتشف المواقع الإلكترونية برامج استخراج البيانات وتمنعها؟
حجب عناوين IP
ما هو: تقوم مواقع الويب بمراقبة عناوين IP التي ترسل الطلبات. وإذا أرسلت إحدى عناوين IP عددًا كبيرًا جدًّا من الطلبات في فترة زمنية قصيرة، يتم وضع علامة عليها وحظرها.
لماذا تنجح هذه الطريقة: هذه الطريقة فعالة لأن معظم برامج استخراج البيانات تعمل من عنوان IP واحد أو نطاق صغير من العناوين. الأمر أشبه بالقبض على مرسِل بريد مزعج بعد ملاحظة أنه يرسل 50 رسالة بريد إلكتروني في الدقيقة.
الكشف عن وكيل المستخدم
ما هو: يتضمن كل طلب يتم إرساله إلى موقع ويب سلسلة «User-Agent» التي تحدد المتصفح ونظام التشغيل. وغالبًا ما تستخدم أدوات استخراج البيانات سلاسل «User-Agent» افتراضية أو لا تستخدم أي سلاسل على الإطلاق، مما يجعل من السهل اكتشافها.
لماذا ينجح هذا الأسلوب: يساعد اكتشاف سلاسل «User-Agent» غير المعتادة وحجبها المواقع على التمييز بين المستخدمين البشريين والروبوتات. فالروبوتات لديها علامات تدل عليها، تمامًا كما هو الحال في لعبة البوكر.
طلب تقييد معدل الاستخدام
ما هو: تحدد مواقع الويب عدد الطلبات التي يمكن لعنوان IP واحد أو وكيل مستخدم واحد إرسالها خلال فترة زمنية معينة.
لماذا ينجح هذا الأسلوب: من خلال وضع حد أقصى لمعدل الطلبات، يمكن للمواقع إبطاء أو إيقاف برامج استخراج البيانات دون التأثير على المستخدمين العاديين. الأمر أشبه بحارس مدخل يضمن ألا يكون البار مزدحمًا للغاية.
افهم هذه الأساليب.
تعرف على العوامل التي تؤدي إلى حدوث حالات الانسداد.
وبذلك، يمكنك التخطيط لأنشطة استخراج البيانات بشكل أفضل.
بعد ذلك، سنتعمق في تقنيات محددة لتجاوز هذه العوائق.
تابعونا.
تقنيات فعالة لتجنب حجب عمليات استخراج البيانات من الويب
استخدام الخوادم الوكيلة المتناوبة
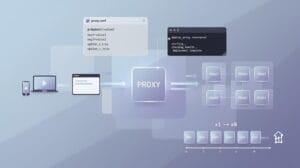
تعد إحدى أكثر الطرق فعالية لتجنب حجب عمليات استخراج البيانات من الويب هي استخدام البروكسيات المتناوبة. وفيما يلي شرح لكيفية عملها وأسباب فائدتها.
ما هي الخوادم الوكيلة الدوارة؟
توفر البروكسيات الدورية مجموعة من عناوين IP التي تتغير على فترات منتظمة أو بعد كل طلب. وبدلاً من إرسال جميع طلباتك من عنوان IP واحد — وهو ما قد يؤدي بسهولة إلى رصده وحظره — تعمل البروكسيات الدورية على توزيع طلباتك عبر عناوين IP متعددة.
يصعب اكتشافها.
كيف تساعد البروكسيات المتناوبة في تجنب حظر عناوين IP
توزيع عناوين IP: من خلال التناوب بين عناوين IP، فإنك تحاكي سلوك العديد من المستخدمين الذين يصلون إلى الموقع من مواقع مختلفة. وهذا التوزيع يجعل من الصعب على المواقع الإلكترونية تحديد الأنماط وفرض الحظر.
تقليل مخاطر الكشف: بفضل استخدام الوكلاء المتناوبين، يبدو أن كل طلب يأتي من مستخدم مختلف. وهذا يساعد على تجنب تفعيل حدود معدل الاستخدام وحظر عناوين IP، وهي الإجراءات التي تُفرض عادةً لمنع الطلبات المفرطة من عنوان IP واحد.
التعامل مع اختبارات «كابتشا»: يمكن لبعض خدمات البروكسي المتناوبة المتقدمة أن تساعد في تجاوز اختبارات «كابتشا» من خلال توزيع الطلبات بطريقة تقلل من احتمالية ظهور اختبارات «كابتشا».
فوائد استخدام البروكسيات المتناوبة في استخراج البيانات من الويب
ارتفاع معدلات النجاح: تساهم الوكلاء المتناوبة في زيادة فرص نجاح عملية استخراج البيانات بشكل كبير، وذلك من خلال تجنب الكشف وتقليل مخاطر حظر عناوين IP.
الوصول إلى المحتوى المقيد جغرافيًا: بفضل مجموعة متنوعة من عناوين IP من مواقع جغرافية مختلفة، يمكنك تجاوز القيود الجغرافية والوصول إلى المحتوى الذي قد يكون محجوبًا في مناطق معينة.
الاستخراج المستمر: من خلال توزيع الطلبات على عناوين IP متعددة، تتيح البروكسيات الدورية إجراء عملية الاستخراج بشكل مستمر دون انقطاع، وهو أمر بالغ الأهمية لجمع البيانات على نطاق واسع.
تحسين إخفاء الهوية: تعمل الخوادم الوكيلة المتناوبة على تعزيز إخفاء هويتك من خلال إخفاء عنوان IP الحقيقي الخاص بك، مما يجعل من الصعب على المواقع الإلكترونية تتبع نشاطك والوصول إليك.
تقدم IPBurger بروكسيات متناوبة عالية الجودة تضمن عملية استخراج البيانات من الويب بسلاسة. وقد صُممت بروكسياتها لتوفير مجموعة متنوعة من عناوين IP، وسرعة عالية، وموثوقية، مما يجعلها مثالية لتجاوز الحظر المفروض على عمليات استخراج البيانات من الويب.
استخدام البروكسيات السكنية
عندما يتعلق الأمر بتجنب الكشف أثناء عملية استخراج البيانات من الويب، فإن البروكسيات السكنية تُعد عاملاً حاسماً. دعونا نستكشف أسباب فعاليتها الكبيرة وكيف تختلف عن بروكسيات مراكز البيانات.
عناوين IP حقيقية: تستخدم البروكسيات السكنية عناوين IP التي يخصصها مزوّدو خدمات الإنترنت (ISPs) لأصحاب المنازل. وهذا يجعلها تبدو كمستخدمين شرعيين بالنسبة للمواقع الإلكترونية، مما يقلل من احتمالية الإبلاغ عنها.
معدلات كشف أقل: نظرًا لأن البروكسيات السكنية تبدو وكأنها مستخدمين عاديين، فإن احتمال كشفها وحظرها أقل مقارنةً بالبروكسيات الخاصة بمراكز البيانات، التي غالبًا ما تتعرف عليها المواقع الإلكترونية وتقوم بحظرها.
أقل عرضة للإدراج في القوائم السوداء: تقل احتمالية إدراج عناوين IP السكنية في القوائم السوداء التي تستخدمها المواقع الإلكترونية لحجب برامج الاستخراج المشتبه بها. وهذا يضمن وصولاً أكثر سلاسة واتساقاً إلى المواقع الإلكترونية.
الاستهداف الجغرافي: تتيح لك البروكسيات السكنية الوصول إلى محتوى خاص بمناطق جغرافية معينة. ويُعد هذا مفيدًا بشكل خاص لاستخراج البيانات المُترجمة أو تجاوز القيود الجغرافية المفروضة على المحتوى.
كيف تساعد البروكسيات السكنية في الحفاظ على معدلات كشف منخفضة
أنماط التصفح الطبيعية: تساعد البروكسيات السكنية في محاكاة سلوك المستخدمين الحقيقيين، مما يجعل من الصعب على مواقع الويب التمييز بين حركة المرور الشرعية وروبوتات استخراج البيانات.
تنوع عناوين IP: من خلال استخدام مجموعة واسعة من عناوين IP، تعمل البروكسيات السكنية على توزيع طلباتك، مما يجعل من الصعب على المواقع الإلكترونية اكتشاف الأنماط وحظر أنشطتك.
أداء ثابت: توفر البروكسيات السكنية اتصالات مستقرة وموثوقة، وهي أمر ضروري لمشاريع استخراج البيانات طويلة الأمد. وهذا يقلل من مخاطر الانقطاعات والحظر.
خيارات التناوب: يقدم العديد من مزودي خدمات البروكسي السكني، مثل IPBurger، بروكسيات سكنية متناوبة تعمل على تغيير عنوان IP الخاص بك تلقائيًا، مما يقلل بشكل أكبر من احتمالات الكشف.
تقليد السلوك البشري
تعد محاكاة السلوك البشري إحدى أكثر الطرق فعالية لتجنب الكشف أثناء عملية استخراج البيانات من الويب. تستخدم مواقع الويب أساليب متنوعة للكشف عن الروبوتات وحجبها، ولكن من خلال جعل أنشطة الاستخراج التي تقوم بها تبدو أكثر شبهاً بالسلوك البشري، يمكنك تقليل خطر التعرض للحجب بشكل كبير. وإليك كيفية القيام بذلك.
كيف يساعد تقليد السلوك البشري في تجنب الكشف
تتمتع مواقع الويب بخوارزميات متطورة مصممة لاكتشاف الروبوتات الآلية وحجبها. تبحث هذه الخوارزميات عن الأنماط والسلوكيات التي تميز الروبوتات، مثل الطلبات السريعة، وغياب حركة الماوس، والإجراءات المتكررة. ومن خلال محاكاة السلوك البشري، فإنك تجعل أنشطة استخراج البيانات التي تقوم بها أقل قابلية للتنبؤ بها وأكثر صعوبة في اكتشافها.
كيفية محاكاة السلوك البشري في عملية استخراج البيانات من الويب
فترات زمنية عشوائية بين الطلبات
- لماذا ينجح هذا الأسلوب: لا ينقر البشر على الروابط أو يتصفحون المواقع الإلكترونية على فترات زمنية منتظمة تمامًا. ويمكن أن يساعد إدخال عنصر العشوائية في الفترة الزمنية الفاصلة بين الطلبات على محاكاة سلوك التصفح الطبيعي.
طريقة التنفيذ: استخدم كودًا لإنشاء فترات انتظار عشوائية بين الطلبات. على سبيل المثال:
import time

import random

urls = ['https://www.example.com/page1', 'https://www.example.com/page2']

for url in urls:

    response = requests.get(url)

    # Process response

    sleep_time = random.uniform(1, 5)  # Sleep for a random time between 1 and 5 seconds

    time.sleep(sleep_time)
محاكاة حركات الماوس والنقرات
- لماذا ينجح هذا الأسلوب: عادةً ما تتنقل الروبوتات دون أي حركات أو نقرات بالماوس، في حين أن البشر يحركون الماوس وينقرون على العناصر بشكل طبيعي.
طريقة التنفيذ: استخدم مكتبات مثل Selenium لمحاكاة حركات الماوس والنقرات.
from selenium import webdriver

from selenium.webdriver.common.action_chains import ActionChains

driver = webdriver.Chrome()

driver.get('https://www.example.com')

element = driver.find_element_by_id('element_id')

ActionChains(driver).move_to_element(element).click().perform()
استخدام وكلاء مستخدمين واقعيين
- لماذا ينجح هذا الأسلوب: توفر سلاسل «User-Agent» معلومات عن المتصفح ونظام التشغيل. ويمكن أن يساعد استخدام مجموعة متنوعة من سلاسل «User-Agent» الواقعية في جعل طلباتك تبدو أكثر شرعية.
طريقة التنفيذ: قم بتبديل سلاسل «User-Agent» في كل طلب.
import requests

url = 'https://www.example.com'

headers = {

    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/112.0.0.0 Safari/537.36'

}

response = requests.get(url, headers=headers)
تحديد عدد الطلبات في كل جلسة
- لماذا ينجح هذا الأسلوب: إن إرسال عدد كبير جدًّا من الطلبات في جلسة واحدة قد يثير الشكوك. لذا، فإن الحد من عدد الطلبات في كل جلسة يمكن أن يساعد في محاكاة أنماط التصفح البشرية.
- كيفية التنفيذ: قسّم مهام استخراج البيانات إلى مجموعات أصغر ووزعها على جلسات متعددة.
الانتقال عبر خطوات متعددة
- لماذا ينجح هذا الأسلوب: غالبًا ما يتصفح المستخدمون المواقع الإلكترونية عبر عدة خطوات بدلاً من الوصول مباشرةً إلى صفحة واحدة. ويمكن أن يؤدي محاكاة هذا السلوك إلى تقليل احتمالية الكشف عن النشاط.
- طريقة التنفيذ: استخدم البرامج النصية للتنقل عبر عدة صفحات قبل الوصول إلى البيانات المستهدفة.
تناوب عناوين IP واستخدام الخوادم الوكيلة
- لماذا ينجح هذا الأسلوب: يدخل المستخدمون إلى المواقع الإلكترونية من عناوين IP مختلفة. ويمكن أن يساعد التبديل بين عناوين IP واستخدام الخوادم الوكيلة في محاكاة هذا السلوك الطبيعي.
- كيفية التنفيذ: قم بدمج الوكلاء المتناوبين في إعدادات عملية استخراج البيانات.
النقر عشوائيًا على الروابط والتفاعل مع المحتوى
- لماذا ينجح هذا النهج: لا يقتصر دور البشر على جمع البيانات فحسب؛ بل يتفاعلون مع المحتوى، مثل النقر على الروابط والأزرار.
- طريقة التنفيذ: استخدم البرامج النصية الآلية للنقر بشكل عشوائي على الروابط والتفاعل مع العناصر الموجودة على الصفحة.
تناوب رؤوس «User-Agent»
تتمثل إحدى الاستراتيجيات الفعالة لتجنب الحظر أثناء عملية استخراج البيانات من الويب في التناوب بين رؤوس "User-Agent". وفيما يلي نظرة تفصيلية على كيفية عمل هذه الاستراتيجية وأسباب فائدتها.
ما هي رؤوس «User-Agent»؟
رأس «User-Agent» هو سلسلة نصية تُرسل مع طلبات HTTP لتحديد المتصفح ونظام التشغيل والجهاز الذي يقوم بإرسال الطلب. ويزود هذا الرأس مواقع الويب بمعلومات حول البرامج والأجهزة المستخدمة للوصول إليها. وتستخدم مواقع الويب هذه المعلومات لتحسين تقديم المحتوى، كما تستخدمها أيضًا للكشف عن الأنشطة غير البشرية.
كيف يمكن أن يمنع تغيير رؤوس «User-Agent» اكتشاف الهوية
تجنب التعرف على الأنماط
- لماذا ينجح هذا الأسلوب: إن الاستخدام المتكرر لنفس سلسلة «User-Agent» في طلبات متعددة قد يؤدي سريعًا إلى تصنيف نشاطك على أنه نشاط روبوت. أما التناوب بين رؤوس «User-Agent»، فيجعل الطلبات تبدو وكأنها قادمة من متصفحات وأجهزة مختلفة، مما يحاكي السلوك البشري.
- كيف يساعد ذلك: من خلال تنويع سلاسل «User-Agent»، فإنك تقلل من خطر الكشف عنك، حيث يصبح من الصعب على مواقع الويب تحديد الأنماط في طلباتك.
تجاوز حظر "User-Agent"
- لماذا ينجح هذا الأسلوب: تقوم بعض المواقع الإلكترونية بحظر الطلبات الواردة من وكلاء المستخدم (User-Agents) المعروفين بأنهم روبوتات. ومن خلال التناوب بين قائمة من سلاسل وكلاء المستخدم الشائعة والشرعية، يمكنك تجاوز هذه الحظر ومواصلة عملية استخراج البيانات دون انقطاع.
- كيف يساعد ذلك: إن استخدام مجموعة متنوعة من سلاسل «User-Agent» المستمدة من المتصفحات والأجهزة الشائعة يساعد على تجنب الحجب ويضمن الوصول المستمر.
أدوات لأتمتة تبديل وكيل المستخدم
هناك العديد من الأدوات والطرق التي يمكنك استخدامها لأتمتة تبديل رؤوس «User-Agent» في نصوصك البرمجية الخاصة باستخراج البيانات من الويب:
مكتبة Requests في لغة بايثون مع تبديل وكيل المستخدم
التنفيذ: استخدم مكتبة Requests في لغة Python لتغيير رؤوس User-Agent مع كل طلب.
import requests

import random

url = 'https://www.example.com'

user_agents = [

    'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/112.0.0.0 Safari/537.36',

    'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/90.0.4430.93 Safari/537.36',

    'Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/88.0.4324.150 Safari/537.36',

    # Add more User-Agent strings

]

headers = {

    'User-Agent': random.choice(user_agents)

}

response = requests.get(url, headers=headers)

print(response.content)
إطار عمل Scrapy مع برمجيات وسيطة لـ User-Agent
التنفيذ: يتيح لك «Scrapy»، وهو إطار عمل شائع لاستخراج البيانات من الويب، استخدام برامج وسيطة لتناوب سلاسل «User-Agent».
from scrapy import signals

import random

class RotateUserAgentMiddleware(object):

    user_agents = [

        'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/112.0.0.0 Safari/537.36',

        'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/90.0.4430.93 Safari/537.36',

        'Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/88.0.4324.150 Safari/537.36',

        # Add more User-Agent strings

    ]

    def process_request(self, request, spider):

        request.headers['User-Agent'] = random.choice(self.user_agents)
أدوات أتمتة المتصفح
Selenium WebDriver: استخدم Selenium لتبديل سلاسل User-Agent عند أتمتة التفاعلات مع المتصفح.
from selenium import webdriver

from selenium.webdriver.chrome.options import Options

import random

user_agents = [

    'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/112.0.0.0 Safari/537.36',

    'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/90.0.4430.93 Safari/537.36',

    'Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/88.0.4324.150 Safari/537.36',

    # Add more User-Agent strings

]

chrome_options = Options()

chrome_options.add_argument(f"user-agent={random.choice(user_agents)}")

driver = webdriver.Chrome(options=chrome_options)

driver.get('https://www.example.com')
يُعد التناوب بين رؤوس «User-Agent» طريقة بسيطة لكنها فعالة لتقليل احتمالات حظر عمليات استخراج البيانات من الويب. وباستخدام أدوات مثل Python Requests وScrapy وSelenium، يمكنك أتمتة هذه العملية وضمان بقاء أنشطة استخراج البيانات الخاصة بك بعيدًا عن الأنظار.
إدارة معدلات الطلبات
تتمثل إحدى الاستراتيجيات الحاسمة لنجاح عملية استخراج البيانات من الويب في إدارة معدلات الطلبات بشكل فعال. فهذا يساعد على تجنب الكشف عن نشاطك ويضمن استمرار عمليات الاستخراج دون انقطاع. وفيما يلي الأسباب التي تجعل إدارة معدلات الطلبات أمرًا مهمًا، وكيفية تطبيق آلية تحديد المعدلات في مشاريع استخراج البيانات من الويب الخاصة بك.
أهمية إدارة معدلات الطلبات لتجنب الكشف
منع التحميل الزائد على الخوادم
- أهمية الأمر: قد يؤدي إرسال عدد كبير جدًّا من الطلبات في فترة زمنية قصيرة إلى إثقال كاهل خادم الموقع الإلكتروني. وهذا لا يؤدي فقط إلى إبطاء سرعة الموقع بالنسبة للمستخدمين العاديين، بل يؤدي أيضًا إلى إطلاق إنذارات قد تؤدي إلى حظر عنوان IP الخاص بك.
- الميزة: من خلال تباعد الطلبات، فإنك تقلل من الحمل على الخادم، مما يساعد في الحفاظ على الأداء الطبيعي للموقع ويقلل من احتمالية اعتبارك روبوتًا.
تجنب إثارة الشكوك
- أهمية الأمر: لا يقوم المستخدمون البشريون عادةً بإرسال مئات الطلبات في الثانية. وتعد معدلات الطلبات المفرطة مؤشراً واضحاً على نشاط الروبوتات. ومن خلال محاكاة سلوك التصفح البشري، يمكنك تجنب إثارة الشكوك.
- الميزة: إن إدارة معدلات الطلبات بحيث تحاكي النشاط البشري تساعد جهودك في استخراج البيانات على المرور دون لفت الانتباه، مما يقلل من مخاطر الكشف والحظر.
تقنيات تطبيق تقييد معدل الاستعلام في عملية استخراج البيانات من الويب
تأخيرات عشوائية بين الطلبات
كيفية العمل: أدخل فترات تأخير عشوائية بين كل طلب لتقليد سلوك التصفح الطبيعي. ويمكن تحقيق ذلك باستخدام برنامج نصي بسيط في كود استخراج البيانات من الويب الخاص بك.
import time

import random

urls = ['https://www.example.com/page1', 'https://www.example.com/page2']

for url in urls:

    response = requests.get(url)

    # Process response

    sleep_time = random.uniform(1, 5)  # Sleep for a random time between 1 and 5 seconds

    time.sleep(sleep_time)
تحديد السعة بسعر ثابت
كيفية العمل: قم بتعيين فترة تأخير ثابتة بين الطلبات لضمان عدم تجاوز عدد معين من الطلبات في الدقيقة.
import time

urls = ['https://www.example.com/page1', 'https://www.example.com/page2']

for url in urls:

    response = requests.get(url)

    # Process response

    time.sleep(2)  # Sleep for 2 seconds between each request
الحد التكيفي لمعدل البيانات
كيفية العمل: اضبط معدل الطلبات بناءً على استجابة الخادم. على سبيل المثال، إذا زاد وقت استجابة الخادم، فقم بتخفيض معدل الطلبات لتجنب إثقال كاهله.
Import time
import requests

urls = ['https://www.example.com/page1', 'https://www.example.com/page2']

for url in urls:

    start_time = time.time()

    response = requests.get(url)

    # Process response

    end_time = time.time()

    response_time = end_time - start_time

    if response_time < 2:

        time.sleep(2 - response_time)  # Ensure a minimum of 2 seconds between requests
استخدام المكتبات والأطر البرمجية
Scrapy: يتميز Scrapy، وهو إطار عمل شائع لاستخراج البيانات من الويب، بدعم مدمج لتحديد معدل الاسترداد. يمكنك تكوين الإعدادات للتحكم في تأخير التنزيل.
# settings.py in Scrapy project

DOWNLOAD_DELAY = 2 # Delay in seconds between requests- واجهات برمجة التطبيقات (API) والتحكم في معدل الطلبات: توفر بعض واجهات برمجة التطبيقات آليات للتحكم في معدل الطلبات للمساعدة في إدارة معدلات الطلبات. استخدم هذه الميزات المدمجة لضمان البقاء ضمن الحدود المسموح بها لعدد الطلبات.
استخدام برامج حل اختبارات CAPTCHA
صُممت اختبارات CAPTCHA للتمييز بين المستخدمين البشريين والروبوتات الآلية. فهي تطرح تحديات يسهل على البشر حلها، بينما يصعب على الروبوتات حلها. ومع ذلك، في سياق استخراج البيانات من الويب، قد يؤدي مواجهة اختبار CAPTCHA إلى توقف عملياتك. وإليك كيف تدخل أدوات حل اختبارات CAPTCHA حيز التنفيذ وكيف يمكنها مساعدتك في تجاوز هذه التحديات.
ما هي برامج حل اختبارات CAPTCHA؟
أدوات حل اختبارات CAPTCHA هي أدوات أو خدمات تعمل على أتمتة عملية حل اختبارات CAPTCHA. وهي تستخدم تقنيات متنوعة، مثل التعرف الضوئي على الحروف (OCR) والتعلم الآلي، لفك تشفير اختبارات CAPTCHA وحلها، مما يتيح لبرنامج استخراج البيانات من الويب الخاص بك مواصلة مهامه دون تدخل يدوي.
كيف يمكن لبرامج حل اختبارات CAPTCHA المساعدة في تجاوز تحديات اختبارات CAPTCHA
الحلول الآلية
- أهمية الأمر: قد يستغرق حل اختبارات CAPTCHA يدويًّا وقتًا طويلاً، كما أنه قد يكون غير عملي في عمليات استخراج البيانات على نطاق واسع. أما برامج حل اختبارات CAPTCHA الآلية، فتتولى هذه المهمة بكفاءة، مما يضمن استمرار عملية استخراج البيانات دون انقطاع.
- كيفية العمل: تتكامل أدوات حل اختبارات CAPTCHA مع برنامجك النصي لاستخراج البيانات من الويب، حيث تقوم تلقائيًا باكتشاف اختبارات CAPTCHA وحلها فور ظهورها. ويمكنها معالجة أنواع مختلفة من اختبارات CAPTCHA، بما في ذلك الاختبارات النصية، والاختبارات القائمة على الصور، والاختبارات الصوتية.
تحسن معدلات النجاح
- أهمية الأمر: إن التغلب بنجاح على اختبارات CAPTCHA يزيد من معدلات نجاح عملية استخراج البيانات. فبرامج حل اختبارات CAPTCHA تقلل من احتمالية تعطل أداة استخراج البيانات أو حظرها بسبب تحديات CAPTCHA.
- كيف تعمل: تستخدم برامج حل اختبارات CAPTCHA المتقدمة نماذج التعلم الآلي التي تم تدريبها على مجموعات بيانات ضخمة من اختبارات CAPTCHA لتحسين الدقة والسرعة. وهذا يضمن حل اختبارات CAPTCHA، حتى المعقدة منها، بسرعة وبدقة.
التكامل مع أدوات استخراج البيانات
- أهمية الأمر: إن التكامل السلس مع أدوات وأطر عمل استخراج البيانات الشائعة يعزز كفاءة عمليات استخراج البيانات الخاصة بك.
- كيفية العمل: توفر العديد من خدمات حل اختبارات CAPTCHA واجهات برمجة تطبيقات (APIs) يمكن دمجها بسهولة في نظام استخراج البيانات الحالي لديك. وهذا يتيح التشغيل السلس دون الحاجة إلى إجراء تغييرات جوهرية على قاعدة الكود الخاصة بك.
أمثلة على برامج حل اختبارات CAPTCHA
2Captcha: خدمة شائعة تعتمد على موظفين بشريين لحل اختبارات CAPTCHA في الوقت الفعلي. وهي تدعم أنواعًا متنوعة من اختبارات CAPTCHA وتوفر واجهة برمجة تطبيقات (API) للتكامل.
مثال على التكامل:
import requests

api_key = 'YOUR_2CAPTCHA_API_KEY'

site_key = 'SITE_KEY_FROM_CAPTCHA'

url = 'https://www.example.com'

captcha_id = requests.post(f'http://2captcha.com/in.php?key={api_key}&method=userrecaptcha&googlekey={site_key}&pageurl={url}').text.split('|')[1]

response = None

while not response:

    response = requests.get(f'http://2captcha.com/res.php?key={api_key}&action=get&id={captcha_id}').text

    if 'CAPCHA_NOT_READY' in response:

        time.sleep(5)

    else:

        response = response.split('|')[1]

# Use the response in your form submissionAnti-Captcha: خدمة أخرى معروفة تستخدم حلولاً آلية وبشرية على حد سواء لحل اختبارات CAPTCHA. وتوفر واجهة برمجة تطبيقات (API) قوية لتسهيل عملية الدمج.
مثال على التكامل:
import anticaptchaofficial.recaptchav2proxyless

solver = anticaptchaofficial.recaptchav2proxyless.recaptchav2Proxyless()

solver.set_verbose(1)

solver.set_key("YOUR_ANTI_CAPTCHA_API_KEY")

solver.set_website_url("https://www.example.com")

solver.set_website_key("SITE_KEY_FROM_CAPTCHA")

response = solver.solve_and_return_solution()

if response != 0:

    print(f"Captcha solved: {response}")

else:

    print(f"Error: {solver.error_code}")
Death by CAPTCHA: يقدم حلولاً آلية وبشرية على حد سواء لحل اختبارات CAPTCHA. ويشتهر هذا البرنامج بموثوقيته وسرعته، كما يدعم مجموعة واسعة من أنواع اختبارات CAPTCHA.
مثال على التكامل:
import deathbycaptcha

client = deathbycaptcha.SocketClient('username', 'password')

balance = client.get_balance()

print(f'Balance: {balance}')

captcha = client.decode(url='https://www.example.com')

print(f'CAPTCHA {captcha["captcha"]} solved: {captcha["text"]}')
المتصفحات غير المرتبطة بواجهة مستخدم
تُعد المتصفحات الخالية من الواجهة أداة قوية ضمن مجموعة أدوات مستخدمي أدوات استخراج البيانات من الويب، حيث تتيح عملية استخراج أكثر سلاسة وكفاءة. إذا سئمت من التعرض للحظر أو كنت بحاجة إلى طريقة أكثر تقدمًا للتعامل مع مهام الاستخراج المعقدة، فقد تكون المتصفحات الخالية من الواجهة هي بالضبط ما تحتاجه.
ما هي المتصفحات عديمة الواجهة؟
المتصفحات غير المرئية هي متصفحات ويب تعمل بدون واجهة مستخدم رسومية (GUI). وهي قادرة على عرض صفحات الويب وتنفيذ جافا سكريبت تمامًا مثل المتصفحات التقليدية، لكنها تعمل في الخلفية دون عرض المحتوى للمستخدم. وهذا يجعلها مثالية لمهام استخراج البيانات الآلية من الويب التي لا تتطلب عرضًا مرئيًا.
فوائد استخدام المتصفحات عديمة الواجهة في استخراج البيانات من الويب
أداء محسّن
- أهمية الأمر: تستهلك المتصفحات عديمة الواجهة موارد أقل لأنها لا تعرض الرسومات ولا تعالج العناصر المرئية. ويؤدي ذلك إلى تسريع عمليات الاستخراج وزيادة كفاءة استخراج البيانات.
- كيف تعمل: من خلال العمل في الخلفية، تقلل المتصفحات عديمة الواجهة من الحمل على نظامك، مما يتيح لك استخراج البيانات بسرعة أكبر ومعالجة أحجام أكبر من الطلبات.
تجاوز الكشف
- أهمية الأمر: تستخدم العديد من المواقع الإلكترونية آليات للكشف عن الروبوتات قادرة على تحديد أساليب الاستخراج التقليدية. ويمكن للمتصفحات «الخالية من الواجهة» المساعدة في تجاوز بعض تقنيات الكشف هذه من خلال محاكاة تفاعلات المستخدمين الحقيقيين بشكل أكثر دقة.
- كيفية العمل: يمكن للمتصفحات عديمة الواجهة التفاعل مع صفحات الويب تمامًا مثل المستخدمين العاديين، بما في ذلك تنفيذ جافا سكريبت وتحميل المحتوى الديناميكي، مما يساعد على تجنب الكشف.
الأتمتة المتقدمة
- أهمية الأمر: بالنسبة لمهام استخراج البيانات الأكثر تعقيدًا، مثل التفاعل مع النماذج أو التنقل بين صفحات متعددة، توفر المتصفحات عديمة الواجهة إمكانات أتمتة متقدمة تتجاوز نطاق طلبات HTTP البسيطة.
- كيفية العمل: تدعم هذه الأدوات التنفيذ الكامل لـ JavaScript، ويمكنها محاكاة تفاعلات المستخدم مثل النقرات، والتمرير، وإرسال النماذج، مما يوفر تمثيلاً أكثر دقة لسلوك المستخدم الحقيقي.
أدوات ومكتبات للتصفح بدون واجهة مستخدم
محرك الدمى
- نظرة عامة: Puppeteer هي مكتبة Node.js توفر واجهة برمجة تطبيقات (API) عالية المستوى للتحكم في متصفح Chrome أو Chromium عبر بروتوكول DevTools. وهي تُستخدم على نطاق واسع لاستخراج المحتوى الديناميكي وإجراء الاختبارات الآلية.
- الميزات الرئيسية: تحكم كامل في المتصفح، ودعم الوضع بدون واجهة مستخدم، والتقاط لقطات الشاشة وإنشاء ملفات PDF، والتفاعلات الآلية.
مثال:
const puppeteer = require('puppeteer');

(async () => {

  const browser = await puppeteer.launch({ headless: true });

  const page = await browser.newPage();

  await page.goto('https://www.example.com');

  const content = await page.content();

  console.log(content);

  await browser.close();

})();
Selenium WebDriver
- نظرة عامة: يُعد Selenium WebDriver أداة شائعة الاستخدام لأتمتة متصفحات الويب. وهو يدعم العديد من لغات البرمجة والمتصفحات، بما في ذلك أوضاع التشغيل بدون واجهة مستخدم لمتصفحي Chrome وFirefox.
- الميزات الرئيسية: دعم متصفحات متعددة، وتفاعلات متقدمة، ودعم واسع النطاق من المجتمع.
مثال:
from selenium import webdriver

from selenium.webdriver.chrome.options import Options

chrome_options = Options()

chrome_options.add_argument("--headless")

driver = webdriver.Chrome(options=chrome_options)

driver.get('https://www.example.com')

content = driver.page_source

print(content)

driver.quit()
كاتب مسرحي
- نظرة عامة: Playwright هي مكتبة Node.js طورتها شركة مايكروسوفت تتيح إجراء الاختبارات الآلية لتطبيقات الويب. وهي تدعم متصفحات متعددة وتوفر إمكانيات مشابهة لتلك التي توفرها Puppeteer.
- الميزات الرئيسية: دعم متصفحات متعددة، ووضع التشغيل بدون واجهة مستخدم، والتفاعلات الآلية مع السيناريوهات المعقدة.
مثال:
const { chromium } = require('playwright');

(async () => {

  const browser = await chromium.launch({ headless: true });

  const page = await browser.newPage();

  await page.goto('https://www.example.com');

  const content = await page.content();

  console.log(content);

  await browser.close();

})();
التعامل مع مصائد «هوني بوت»
«هوني بوتس» هي أفخاخ ماكرة تنصبها مواقع الويب للقبض على الروبوتات متلبسةً. وهي تتخذ أشكالاً متنوعة، كل منها مصمم لاستغلال السلوك المتوقع للبرامج النصية الآلية.
الروابط والحقول المخفية
تخيل صفحة ويب مليئة بالفخاخ غير المرئية. غالبًا ما تتضمن «مصائد العسل» حقول نماذج أو روابط أو أزرارًا مخفية لا يراها المستخدم العادي أبدًا ولا يتفاعل معها. أما الروبوتات، فهي تُبرمج عادةً للنقر على جميع الروابط أو ملء جميع حقول النماذج. وعندما تتفاعل مع هذه العناصر المخفية، فإنها تُفعّل الفخ.
حيل CSS
يستخدم مطورو الويب حيلًا في CSS لنصب هذه الفخاخ. ويمكن إخفاء العناصر باستخدام خصائص مثل display: none; أو visibility: hidden;. ورغم أن المستخدمين البشريين لن يروا هذه العناصر، فإن الروبوتات التي لا تعالج CSS ستتفاعل معها.
تم القبض عليه.
تحديات جافا سكريبت
تذهب بعض «مصائد العسل» إلى أبعد من ذلك باستخدام لغة جافا سكريبت لإضافة مصائد ديناميكيًّا بعد تحميل الصفحة. وهذه خطوة ذكية؛ فالروبوتات التي لا تُنفِّذ لغة جافا سكريبت بشكل صحيح ستقع مباشرةً في هذه المصائد.
على سبيل المثال، قد يبدو النموذج عاديًا عند تحميل الصفحة لأول مرة، ولكن قد يتم إضافة حقل أو رابط مخفي عبر جافا سكريبت بعد بضع ثوانٍ. وإذا حاول الروبوت التفاعل مع هذا العنصر الجديد، فسيكون ذلك دليلًا واضحًا على طبيعته الآلية.
ذكي، أليس كذلك؟
تستغل «مصائد العسل» قابلية توقع سلوك الروبوتات لتستخدمها ضدهم. ففي حين يتصفح المستخدمون البشريون الموقع بسلاسة، فإن أي روبوت يحاول استخراج البيانات أو إرسال رسائل غير مرغوب فيها يقع في هذه الفخاخ الخفية.
تقنيات لتجنب الوقوع في أفخاخ «هوني بوت» عند استخراج البيانات من الويب
1. تجنب التفاعل مع العناصر المخفية
الكشف عن CSS: قبل التفاعل مع العناصر، تحقق من خصائص CSS الخاصة بها للتأكد من أنها مرئية للمستخدمين البشريين. يجب تجاهل العناصر التي تحتوي على خصائص مثل display: none; أو visibility: hidden;.
from bs4 import BeautifulSoup

import requests

url = 'https://www.example.com'

response = requests.get(url)

soup = BeautifulSoup(response.text, 'html.parser')

for link in soup.find_all('a'):

    if 'display' in link.get('style', '') and 'none' in link['style']:

        continue  # Skip hidden link

    # Process visible link
2. استخدام أنماط تفاعل شبيهة بالبشر
- التفاعل الانتقائي: قم بتكوين أداة الاستخراج الخاصة بك بحيث تتفاعل فقط مع العناصر التي يتفاعل معها المستخدم البشري العادي. تجنب النقر على كل رابط أو ملء كل نموذج بشكل عشوائي.
- محاكاة السلوك البشري: قم بإدراج فترات توقف وتأخيرات تحاكي سلوك التصفح البشري، كما تمت مناقشته في الأقسام السابقة.
3. مراقبة تنفيذ جافا سكريبت
تحليل جافا سكريبت: استخدم متصفحات بدون واجهة مستخدم لعرض الصفحات بالكامل وتنفيذ جافا سكريبت. يتيح لك ذلك اكتشاف مصائد الخداع المضافة ديناميكيًا وتجنب التفاعل معها.
from selenium import webdriver

driver = webdriver.Chrome()

driver.get('https://www.example.com')

# Check for dynamically added honeypots

links = driver.find_elements_by_tag_name('a')

for link in links:

    style = link.get_attribute('style')

    if 'display: none;' in style or 'visibility: hidden;' in style:

        continue  # Skip hidden link

    # Process visible link
4. استخدام أدوات الاستخراج المتقدمة
Scrapy مع البرمجيات الوسيطة: استخدم البرمجيات الوسيطة في Scrapy لتصفية مصائد الخداع (honeypots) من خلال التحقق من السمات النموذجية لهذه المصائد.
فئة IgnoreHoneypotsMiddleware:
def process_spider_output(self, response, result, spider):

        for item in result:

            if isinstance(item, dict):  # Assuming item is a dict

                # Add custom logic to filter honeypots

                if 'honeypot' in item.get('class', ''):

                    continue

        yield item
الخلاصة
يتطلب تجنب حظر عناوين IP واستخراج البيانات بنجاح من المواقع الإلكترونية مزيجًا من الاستراتيجيات الذكية والأدوات المناسبة. ومن خلال فهم التقنيات الشائعة التي تستخدمها المواقع الإلكترونية لحجب برامج استخراج البيانات وتطبيق الطرق التالية، يمكنك تقليل حالات حجب استخراج البيانات من الويب بشكل كبير:
- استخدم البروكسيات المتناوبة: وزع طلباتك على عدة عناوين IP لتجنب الكشف عنك.
- تطبيق نظام تدوير عناوين IP: قم بتغيير عناوين IP بانتظام لمحاكاة وجود عدة مستخدمين وتقليل مخاطر الحظر.
- استخدام البروكسيات السكنية: استخدم عناوين IP سكنية حقيقية للحصول على حركة مرور تبدو أكثر شرعية.
- تقليد السلوك البشري: اجعل أنشطة استخراج البيانات تبدو طبيعية من خلال إدخال العشوائية والتفاعلات الشبيهة بالسلوك البشري.
- تناوب رؤوس "User-Agent": تغيير سلاسل "User-Agent" لتجنب الإبلاغ عنك من قِبل مواقع الويب.
- إدارة معدلات الطلبات: التحكم في وتيرة الطلبات لتجنب إثقال كاهل الخوادم.
- استخدم أدوات حل اختبارات CAPTCHA: قم بأتمتة عملية حل اختبارات CAPTCHA لتجاوز هذه العوائق الشائعة.
- استخدام المتصفحات عديمة الواجهة: استفد من المتصفحات التي تعمل بدون واجهة مستخدم رسومية (GUI) لتنفيذ مهام استخراج البيانات الأكثر تعقيدًا.
- التعامل مع مصائد «هوني بوت»: اكتشاف العناصر المخفية المصممة لاصطياد الروبوتات وتجنبها.
تقدم IPBurger مجموعة من حلول البروكسي القوية التي يمكن أن تساعدك على تطبيق هذه التقنيات بفعالية. وبفضل بروكسياتها المتناوبة والبروكسيات السكنية والدعم الفعال الذي توفره، يمكنك ضمان تقليل حالات حظر استخراج البيانات من الويب بشكل كبير.
هل أنت مستعد للتخلص من حظر استخراج البيانات من الويب؟ تفضل بزيارة موقع IPBurger لاستكشاف حلول البروكسي المتطورة التي نقدمها.