人们很容易将网络搜索和网络抓取混为一谈。
但你又不会伤害他们的感情什么的......
好吧,我们还是小心点,学会分辨它们吧(我们都看过《终结者》和《iRobot》)。(我们都看过《终结者》和《iRobot》)。
此外,了解您能从他们那里得到什么,不能得到什么,肯定会有所帮助。
网络清除器和网络爬虫一览...
如果想从互联网上提取数据,就需要网络爬虫和网络刮刀。网络爬虫负责查找链接,网络刮刀负责从这些链接中下载数据。有了数据后,你就可以对其进行处理,比如将其放入数据库或以某种方式加以利用。
您可以将网络刮擦工具和爬虫视为网络数据提取领域的神探夏洛克和华生。没有爬虫,你就很少能进行刮擦,而没有刮擦器则永远无法进行爬行。
我给你举个例子。
假装你在图书馆为一个研究项目收集数据。
你翻阅教科书和文件夹,寻找你要找的东西,盯着索引,一页页翻阅......这就是爬的部分。当你写下任何笔记或复制页面时,这就是 "刮 "的部分。
正如你所看到的,不爬着刮是非常困难的,反之亦然。
进一步了解网络刮擦和网络抓取之间的区别...
为了进一步区分两者,我们可以看看网络爬行和刮擦是如何工作的。
网络搜索是如何工作的?
我们都知道,网络搜刮指的是提取数据。你可以随心所欲地复制和粘贴,但这非常耗时。相反,复制和粘贴策略是通过机器人完成的。
自动化流程分为三个步骤:
- 请求回复
- 解析
- 提取
这是通过编写或编程脚本自动访问网页并提取特定信息来实现的。这涉及到对 HTML、CSS、JSON 等进行解析......之后,您就可以抓取所有数据了。然后,您可以将其导出到电子表格中,以便于查看和分析。
如果您使用手动刮擦工具,通常会用到点选式刮擦工具。这些网络刮擦工具会为您提供一个抓取的 URL 列表,供您访问以收集数据。
网络抓取是如何工作的?
网络爬行指的是机器人逐一访问网站所有页面以发现指向另一个网站的链接的技术。发现链接可以让爬虫或浏览器发现新内容,并将其添加到索引中,以便日后检索。网络爬虫还会下载每个页面,以便在需要时使用。
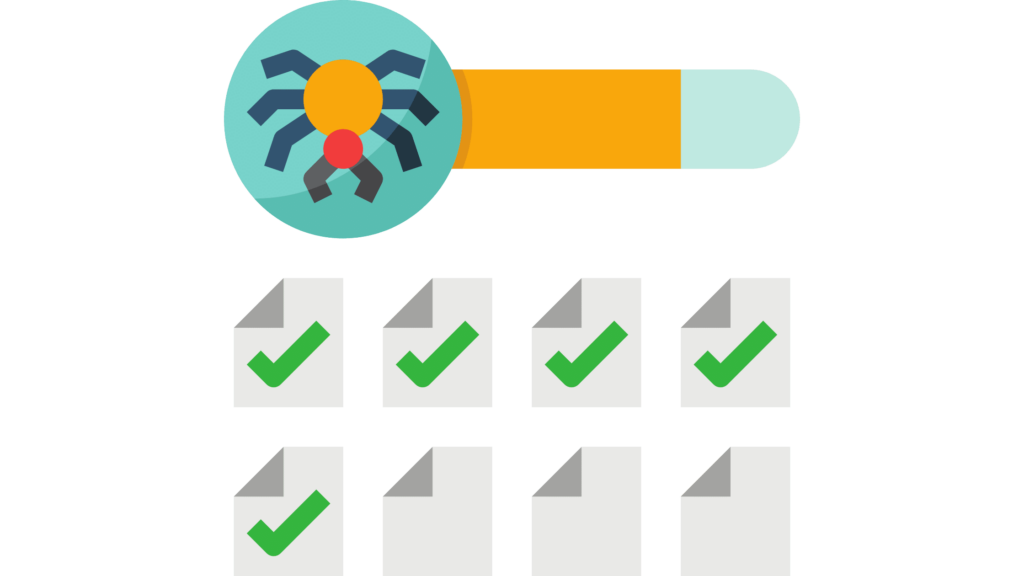
网络爬行的方式与网络刮擦基本相同。但网络爬虫不是提取信息,而是存储内部链接以创建索引。
具体步骤如下
- 通过链接浏览每一页。
- 为每个链接建立索引。
- 在数据库中存储链接数据。
正如你所看到的,这两个过程遵循相同的步骤,只是略有不同:爬取遍及整个网站,而刮擦则提取特定的数据集。
日常网络抓取和网络刮擦使用案例。
数据有时可能是纯学术、商业或金融研究的组成部分。我们可以看到,网络爬行和网络刮擦是每一个在线业务的幕后黑手。例如,Googlebot 通过不断抓取和刮擦来构建和维护 Google 的搜索引擎结果页面(SERP)。
SERPs
每天,谷歌在搜索结果中抓取近 270 亿个网站。爬虫在数以百万计的网站上搜索他们想要的信息。除了不断变化的用户需求,爬虫也必须适应用户需求。因此,谷歌爬虫会对网页进行分类,评估内容质量,并执行多种索引功能。
房地产
大多数房地产网站通过在文本和链接中加入关键字来与搜索引擎打交道。最好的房地产网络爬虫会使用这些信号来确定特定页面或网站的重要程度。
市场数据分析
金融服务部门使用爬虫和网络刮擦技术获取股票市场数据。其目的是从知名网站收集有价值的数据,对内容进行各种分析,并相应地自动更新市场指数。
零售与电子商务
零售和电子商务企业需要进行市场分析,以保持竞争优势。他们可以检索消费者产品数据、产品描述、竞争对手产品详情,分析这些数据如何影响销售模式,并制定最佳零售营销和销售策略。
增长一代
研究发现,对客户数据进行分析和识别,能使企业获得更多销售额和商业线索的可能性提高23倍。企业必须通过持续的用户调查和数据采集技术来分析客户行为。
网络开发
爬虫对网站开发至关重要。它们创建网站、分析网站并不断改进网站结构,直至达到最佳用户体验。
机器学习
机器学习使用网络爬虫和刮擦器来建立数据存储库。数据存储库是网络上所有相关信息的集合。爬虫会以易于检索的形式自动存储这些数据,供机器或人类在未来进行分析和处理。
数据汇总
企业通过网络爬行和刮擦工具发现了数据聚合的广泛用途。其中包括监控竞争对手的价格或产品、跟踪网络声誉以及从社交媒体平台收集数据。
搜索引擎排名
在搜索引擎优化行业,网络搜刮器和爬虫对于分析内容和进行修改以提高网站的搜索引擎排名至关重要。它们也是 SEMRush 和 AHREFS 等网站的引擎。
营销自动化
想要从目标受众或客户那里收集数据的公司也可以在营销自动化项目中使用网络搜刮工具。他们通过客户反馈工具、市场调研网站或社交媒体平台来实现这一目的。
安全
最常用的数据汇总工具是安全网络爬虫,它可以监控互联网上的任何漏洞。其中包括 DDoS 保护、漏洞扫描和恶意软件检测。
品牌保护
品牌保护已成为防止品牌欺诈和品牌褪色,以及识别利用企业知识产权(如品牌名称标识)非法牟利的恶意行为者的一部分。
在几乎所有的业务领域,数据搜索似乎都能发挥巨大的作用。然而,它也面临着挑战。
网络搜刮和网络爬行面临的主要挑战。
某些网站设有反爬虫政策,禁止用户在未获得适当授权的情况下从特定网站获取数据。仅因使用数据中心代理进行网页爬取而遭到IP封禁的情况并不少见。
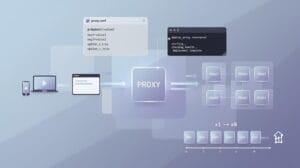
在这种情况下,网络爬虫API会非常有效,尤其是当它们能为您提供大型住宅代理网络的访问权限时,这有助于您使用真实用户的IP地址收集数据,并绕过此类封锁。
如果您在内部进行数据采集,住宅代理将是您数据采集工具包中不可或缺的一部分。有了它们,您的网络搜索和抓取工作就不会受到地理限制或反僵尸措施的阻挠。
请阅读这篇深度解析,了解在网页抓取方面,住宅代理为何优于数据中心代理。
总之,网络抓取和刮擦都能为企业带来巨大价值,但也会带来一些挑战。归根结底,二者各有千秋,但最终必须协同工作。