هناك الآلاف من مكتبات تحليل النصوص. ما هي أفضلها لتحليل لغة HTML من مواقع الويب؟
ربما تكون على دراية بالفعل بكيفية استخدام لغة HTML لعرض المحتوى على موقعك الإلكتروني، لكن هل تعلم أن هناك أدوات تسمح باستخراج البيانات التي تحتاجها دون الحاجة إلى كتابة أي كود برمجي؟ تقوم هذه المكتبات بكل شيء بدءًا من استخراج عناوين الصفحات والأوصاف التعريفية وصولاً إلى تحديد الصور والروابط وحتى أرقام الهواتف وعناوين البريد الإلكتروني، دون أن يتطلب ذلك منك سوى القليل من الجهد أو دون أي جهد إضافي على الإطلاق.
تستعرض هذه المقالة أفضل مكتبات تحليل البيانات، وتقدم توصيات بناءً على أنواع المحتوى التي تحاول تحليلها ولغة البرمجة التي يستخدمها موقعك الإلكتروني.
ما هو التحليل النحوي؟
التحليل النحوي هو مصطلح آخر يشير إلى التحليل الصرفي، أو عملية تحليل أجزاء الجملة — أو في حالتنا هذه — سلسلة من التعليمات البرمجية. إذا كنت تقوم بتحليل لغة HTML، فأنت تقوم بتحليل العلامات والعناصر الموجودة في صفحة ويب واستخراج البيانات منها.
ما المقصود بتحليل لغة HTML؟
لغة ترميز النص التشعبي (HTML) هي لغة حاسوبية تُستخدم لتنسيق نصوص مواقع الويب. لا يمكنك رؤيتها إلا إذا كنت في وضع المطور، لكن لغة HTML تعمل في الخلفية لتقدم تعليمات لأجهزة الكمبيوتر الزائرة حول كيفية عرض نص صفحة الويب.
تقوم أدوات التحليل البسيط بتقسيم أسطر HTML إلى أجزاء أصغر، وتعيين علامات لها وفقًا للفئة التي تنتمي إليها. واعتمادًا على مكتبة التحليل البسيط التي تستخدمها، يمكنك استخدام أنظمة وضع علامات مختلفة وتحليل HTML من لغات برمجة مواقع ويب مختلفة.
وهي مفيدة في عملية استخراج البيانات من الويب لأنها تتيح لك تقسيم المواقع الإلكترونية الكبيرة التي يصعب قراءتها إلى أجزاء أصغر حجمًا. إذا كنت تحاول فهم كيفية عمل متاجرك المفضلة، فجرّب الاطلاع على كود HTML الخاص بها كنقطة انطلاق.
ما هي مكتبات التحليل النحوي؟
مكتبات التحليل هي أطر عمل تُستخدم لقراءة بيانات الويب وتحليلها وتنظيمها. وهي بمثابة مفاتيح تعمل على ترجمة أسطر البرمجة إلى مخرجات متنوعة وقيّمة. على سبيل المثال، تحتاج إلى مكتبة تحليل بلغة C# لاستخراج البيانات ومعالجتها من موقع ويب تم إنشاؤه باستخدام لغة C#.
فيما يلي، نستعرض مكتبات تحليل الجمل البرمجية لعدد من لغات البرمجة الأكثر شيوعًا التي قد تصادفها عند استخراج البيانات من الويب، بما في ذلك جافا وبايثون وC# وجافا سكريبت.
تحليل لغة HTML في لغة جافا.
يعرف معظم المطورين أن لغة جافا (Java) هي لغة شائعة المستخدمة في بناء واجهات برمجة التطبيقات (APIs) وأنظمة الخلفية، لكن قلة منهم قد تدرك أنها مفيدة أيضًا عند كتابة برامج التحليل النحوي. وهناك حاليًا العديد من مكتبات التحليل النحوي بلغة جافا قيد التطوير، بما في ذلك Jsoup وLagarto وHTMLCleaner. يمكنك الآن الاستفادة من معرفتك بقواعد لغة جافا لتنفيذ عمليات استخراج البيانات من الويب باستخدام لغتي C# وNode.js. وتقدم كل منهما مزايا مميزة للمطورين الذين يعملون على بناء تطبيقات واسعة النطاق.
Jsoup
Jsoup هي مكتبة جافا مخصصة للتعامل مع صفحات الويب الفعلية. وهي توفر واجهة برمجة تطبيقات (API) سهلة الاستخدام لاستخراج البيانات ومعالجتها باستخدام أفضل أساليب DOM وCSS والأساليب المشابهة لـ jQuery.
يقوم Jsoup بتنفيذ HTMLParser من الصفر استنادًا إلى jsoup.dom. يمكنك استخدام هذا المُحلل مع أطر عمل شائعة أخرى مثل Xpath وJQuery وغيرها. وأثناء الكتابة على صفحة ويب، يمكنك بسهولة تحويلها إلى مستند XML، واستخراج العناصر منها، ومعالجة محتوياتها بشكل أكبر باستخدام بضعة أسطر من الكود.
لاغارتو
Lagarto هي أداة لاستخراج البيانات ومتصفح ويب. وهي متوفرة بتنفيذات بلغة جافا وجافا سكريبت. يمكنها استخراج البيانات من ملفات HTML وXML وCSV وJSON وOpenDocument Spreadsheet. Lagarto مخصصة للمطورين الذين يرغبون في التحكم الكامل في استخراج المعلومات من المحتوى غير المنظم. كانت أهداف التصميم الأساسية هي البساطة وسرعة التطوير، ولكن دون المساس بالأداء أو الدقة. تتيح سهولة استخدام Lagarto للمطورين ذوي الخبرة المحدودة في مجال تحليل البيانات البدء في العمل على الفور من خلال الاستفادة من معرفتهم الحالية بالتعبيرات العادية أو محددات CSS لإنشاء أدوات تحليل خاصة بهم لتنسيقات الإدخال المخصصة، أو حتى إنشاء تنسيقات إدخال جديدة تمامًا من الصفر.
HTMLCleaner
HTMCleaner هو محلل لمحتوى الويب يستخدم صيغة تشبه CSS لاستخراج البيانات من HTML. باستخدام HTMCleaner، يمكنك تحليل المستندات وتعديلها وإعادة تحليلها بعدة طرق مفيدة. وبالمقارنة مع Lagarto أو Jsoup، لا يوفر HTMCleaner واجهة برمجة تطبيقات (API) للتحليل المخصص؛ فهو مخصص فقط لاستخراج البيانات من كود HTML المصدري (لكن أساليبه تشبه واجهة برمجة تطبيقات DOM بشكل أكبر). قد تمثل هذه الميزة ميزة للمطورين الذين يحتاجون إلى مزيد من التحكم في عملية التحليل مقارنةً باستخدام واجهة برمجة تطبيقات DOM. الغرض الأساسي من HTMLCleaner هو السماح باستخراج المحتوى بسهولة مع الحفاظ على الفصل بين العرض والبنية (HTML). وهذا يعني أنك ستتمكن من بناء طبقة العرض الخاصة بك استنادًا إلى بنية المستند الحالية.
تحليل لغة HTML في لغة بايثون.
أشهر مكتبات تحليل البيانات بلغة بايثون اليوم هي Scrapy وBeautiful Soup وlxml. لكل منها نقاط قوتها ونقاط ضعفها؛ لذا عليك اختيار إحداها بناءً على احتياجاتك. وسيتوقف الخيار الأفضل على اللغات التي كُتب بها موقعك، ومدى ديناميكيته، وعدد الصفحات التي تحتاج إلى استخراج البيانات منها، وما إلى ذلك.
سكرابي
يُعد «Scrapy» أداة قوية وسريعة؛ فهو يدعم لغات برمجة متعددة مثل «Python» و«Java» و«Ruby»، لكن كتابة «سبايدر» لـ«Scrapy» قد تكون صعبة إذا كنت مبتدئًا في مجال استخراج البيانات من الويب.
حساء جميل
يُعد Beautiful Soup خيارًا ممتازًا للمبتدئين لأنه يوفر طريقة بسيطة لاستخراج البيانات من صفحة HTML باستخدام التعبيرات النمطية. علاوة على ذلك، هناك مجتمع نشط يدعم Beautiful Soup، مما يجعل الحصول على الدعم أمرًا سهلاً.
LXML
إذا كنت تبحث عن خيار أكثر مرونة، فإن lxml يُعد خيارًا ممتازًا. وهو محلل لجمع البيانات من الويب مبني بلغة C ويستخدم محددات XPath وCSS لتحليل سريع. إذا كان موقعك مكتوبًا بلغات مثل PHP أو ASP، فقد يكون lxml خيارًا جيدًا. على الرغم من أنه ليس سهل الاستخدام مثل Beautiful Soup، إلا أنه يمكنك كتابة قواعد مخصصة لـ lxml إذا كنت بحاجة إلى تحقيق شيء يتجاوز نطاق قدراته القياسية. علاوة على ذلك، يتكامل بسلاسة مع Nokogiri، مما يجعله أكثر قوة وتنوعًا من Beautiful Soup. ومع ذلك، هناك ثمن لذلك — فهو أبطأ بكثير وأصعب في التعلم مقارنةً بـ BS أو Scrapy.
نوصي بتجربة Beautiful Soup أولاً إذا كنت مبتدئًا في مجال استخراج البيانات من الويب. ثم عندما تصبح مستعدًا لاستخدام أداة أسرع وأكثر تقدمًا، جرب Scrapy. إذا لم يكن لديك خيار سوى العمل مع مستند XML (بسبب متطلبات عمل معينة)، فإن استخدام محلل XML سيُسهل عليك الأمور.
تحليل لغة HTML في لغة C#.
من المهم ملاحظة أنه لا يوجد سوى عدد قليل من الخيارات عندما تحتاج إلى محلل HTML للغة C#، وجميعها قابلة للتبادل. إذا كنت تتعامل مع صفحات ويب حديثة، فمن المرجح أن تعمل إحدى هذه المكتبات معك دون أي تعقيدات أو مشاكل. أما إذا كانت مهمتك تتمثل في استخراج البيانات من مواقع ويب قديمة — مثل تلك التي تم إنشاؤها باستخدام ASP Classic أو حتى JSP — فإن الأمور تصبح أكثر تعقيدًا بعض الشيء، وللأسف، أكثر صعوبة.
AngleSharp
AngleSharp هو مشروع مفتوح المصدر جديد نسبيًا، ويبلغ إصداره الحالي 1.4.4، ويوفر دعمًا متعدد المنصات لكل من عملاء الويب وتطبيقات سطح المكتب التي تعمل بنظام ويندوز. ويخضع هذا المشروع لصيانة نشطة، ويتمتع بمجموعة قوية من الوظائف، كما يأتي مزودًا بواجهة برمجة تطبيقات (API) سهلة الاستخدام.
ومع ذلك، لا تزال مكتبة AngleSharp لا تدعم المنصات القديمة مثل Silverlight أو JSP، كما أنها تفتقر إلى بعض الميزات الإضافية التي توفرها المكتبات الأخرى. على سبيل المثال، لا توفر أي نوع من المعالجة المدمجة لـ XML ضمن إطار عملها، مما يعني أنك ستحتاج إلى محلل آخر للتعامل مع هذا الجانب إذا كان ذلك ضروريًا لتطبيقك.
HtmlAgilityPack
يشبه HtmlAgilityPack مكتبة AngleSharp من نواحٍ عديدة. فهو متعدد المنصات، ويخضع لصيانة وتطوير مستمرين. كما يوفر العديد من الوظائف والخدمات التي يمكنك الوصول إليها من خلال واجهة برمجة تطبيقات (API) سهلة الاستخدام. وتكمن مشكلته الحقيقية الوحيدة في أن وثائقه أقل شمولية من وثائق AngleSharp، مما يجعل من الصعب على المستخدمين الجدد فهم كيفية عمل كل شيء إذا لم تكن لديهم خبرة سابقة في استخدام مكتبات تحليل النصوص. علاوة على ذلك، لا يتضمن أي ميزات إضافية مثل معالجة XML. وهذا يعني أنك ستحتاج إلى محلل آخر لـ XML إذا كنت ترغب في العمل مع بيانات من مصادر متعددة في آن واحد. بخلاف ذلك، يقوم HtmlAgilityPack بكل المهام الأخرى تقريبًا بنفس الكفاءة أو بشكل أفضل من AngleSharp، وهو بالتأكيد يستحق التجربة إذا كنت تبحث عن محلل HTML قوي بلغة C#.
تحليل لغة HTML في JavaScript.
jQuery
تساعدك مكتبة jQuery على تحديد عناصر HTML والبحث عنها وتعديلها بطريقة سهلة الفهم. يمكنك البدء في استخدام jQuery بسرعة معقولة؛ وإذا كنت قادمًا من jQuery، فسيكون من السهل عليك ترجمة معرفتك إلى لغة C#. تتطلب بعض الوظائف مجهودًا أكبر قليلاً مقارنةً بالطرق المدمجة في jQuery، ولكن هنا يأتي دور مكتبات تحليل النصوص!
Node.js
Node.js هي منصة مبنية على متصفح Chrome تتيح لك تشغيل كود JavaScript خارج بيئة المتصفح، مما يساعد في إنشاء أدوات سطر الأوامر أو تحليل البيانات من مواقع الويب. وهي رائعة لتشغيل موقع ويب على جهاز الكمبيوتر الخاص بك، ولكنها ليست مناسبة جدًّا لتحليل الكود الذي يتم تشغيله على خوادم خارجية، مثل Facebook أو Amazon.
ستحتاج في هذه الحالات إلى واجهة برمجة تطبيقات (API) قادرة على إجراء عملية استخراج البيانات من الويب من جانب الخادم بلغة جافا. وإذا كنت بحاجة إلى كل من استخراج البيانات من الويب وجمع معلومات نظام التشغيل وتصفيتها (مثل تصفية البيانات بناءً على مصدرها)، فإن Htmlparser2 يُعد الخيار المثالي. فهو يوفر المرونة والأداء العالي. كما تتيح إحدى وظائفه الوصول إلى مكتبات متنوعة تابعة لجهات خارجية، مما يجعلها مفيدة لمعالجة البيانات عندما يكون هناك أكثر من طريقة واحدة لحل مشكلة ما.
إلى اللقاء
على عكس jQuery، يُعد Cheerio إطار عمل أكثر بساطة بكثير، ولا يتطلب منك كتابة سوى قدر أقل من التعليمات البرمجية لإنجاز العديد من المهام التي ترغب فيها. فهو لا يتضمن العديد من الميزات، لكنه يشتمل على عناصر مثل محرك Ajax غير المتزامن مع دعم التخزين المؤقت (وهو أمر مفيد)، وسهولة إضافة وظائف الاستدعاء ومعالجات الأحداث، وغير ذلك. ويمكن أن يكون هذا الإطار الخفيف الوزن خيارًا جيدًا إذا كنت تبحث عن شيء سريع لكنه قوي في الوقت نفسه.
علاوة على كل ذلك، فإنه يدعم استخدام القوالب من جانب العميل، والتي يمكن للمستخدمين من خلالها تطبيق عوامل التصفية على البيانات في الوقت الفعلي. تتوفر مكونات إضافية لمعالجة محددات CSS في القوالب، بحيث يمكن للمستخدمين تنسيق مخرجاتهم بسهولة بالطرق المناسبة، مع ضمان التوافق مع معظم مكتبات التحليل.
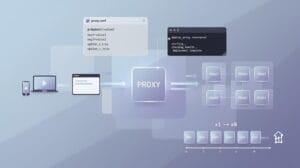
تناوب الخوادم الوكيلة لتسهيل عملية جمع البيانات.
على الرغم من أنه يمكنك إنجاز بعض مهام استخراج البيانات من الويب باستخدام بروكسي سكني واحد، إلا أن هناك حالات عديدة تتطلب استخدام بروكسيات متعددة. إذا كنت بحاجة إلى الوصول إلى عناوين URL عديدة أو إجراء استعلامات على محركات بحث داخلية مختلفة، فإن استخدام بروكسيات متعددة يضمن ألا يؤدي استخراج البيانات إلى حظرك على مستوى الموقع بأكمله. وهناك سيناريو آخر يتمثل في الحاجة إلى استخراج البيانات بشكل مستمر من نفس الهدف. وتساعد ميزة تدوير البروكسيات على تجنب الحظر من خلال إرسال الطلبات من عنوان IP جديد في كل مرة.
للحصول على خدمة تبديل عناوين IP عالية الجودة باستخدام أسرع البروكسيات السكنية وأكثرها موثوقية، يرجى الاتصال بفريق IPBurger.
هل سئمت من التعرض للحظر والإقصاء؟
احصل على الدليل المجاني الذي سيوضح لك بالضبط كيفية استخدام الخوادم الوكيلة لتجنب الحجب والحظر واختبارات «كابتشا» في عملك.
أرسل لي الدليل المجاني الآن!