Vous mettez votre scraper à l'échelle et les problèmes commencent. Des CAPTCHA partout, votre scraper bloqué pour la moitié de vos requêtes, des adresses IP bannées avant même d'avoir pu se connecter. Vous vous mettez alors à chercher des moyens de contourner les CAPTCHA. Ce n'est pas par là qu'il faut chercher.
Les CAPTCHA ne sont pas à l'origine du problème. Ils en sont le signe. Lorsqu'un CAPTCHA apparaît, votre adresse IP a déjà été signalée.
Le marché du web scraping devrait presque tripler d'ici 2032. Les opérations menées à cette échelle ont été les premières à résoudre le problème de la propriété intellectuelle. C'est justement de cela qu'il s'agit.
Les difficultés liées à l'extraction de données qui contournent les CAPTCHA ne disparaîtront pas tant que l'infrastructure qui les sous-tend n'aura pas changé.
Ce que les CAPTCHA vous révèlent réellement
Les systèmes anti-bots tels que Cloudflare, DataDome et Akamai calculent un score de confiance pour chaque requête entrante avant que le contenu ne soit diffusé. Type d'adresse IP, réputation de l'adresse IP, empreinte TLS, empreinte du navigateur, en-têtes de requête : tous ces éléments contribuent à établir un score qui détermine la suite du processus.
Lorsque ce score passe en dessous d'un seuil, un CAPTCHA s'affiche. S'il est suffisamment bas, la requête est purement et simplement bloquée.
C'est pourquoi la résolution des CAPTCHA ne fonctionne pas à grande échelle. Le score qui a déclenché le processus reste faible. La requête suivante passe par la même infrastructure et obtient le même résultat.
Se contenter de corriger les symptômes alors que le problème sous-jacent de contournement du CAPTCHA et d'extraction de données persiste ne fait qu'entraîner davantage de CAPTCHA, davantage de blocages et davantage de temps consacré à la maintenance au lieu de la collecte de données.
Pourquoi les adresses IP des centres de données ne sont pas adaptées aux grands volumes
Les adresses IP des centres de données proviennent de fournisseurs de services cloud tels qu’AWS, Google Cloud et Azure. Les systèmes anti-bots connaissent toutes les plages d’adresses IP dont disposent ces fournisseurs. Dès qu’une requête provient de l’une de ces plages, elle est signalée comme susceptible d’être automatisée avant même que d’autres vérifications ne soient effectuées.
C’est là le problème structurel lié à la détection du scraping à partir d’adresses IP de centres de données. Une adresse IP de centre de données n’affiche pas seulement un faible score de confiance en raison de l’utilisation qui en a été faite. Elle affiche un faible score en raison de sa nature même. Les adresses IP partagées des centres de données aggravent encore la situation. Des centaines de robots de scraping passant successivement par les mêmes adresses font que ces adresses IP accumulent rapidement un historique de blocages. Vous héritez de cet historique dès que vous vous connectez.
À grande échelle, cela s'accumule rapidement. Plus vous envoyez de requêtes, plus l'historique s'épaissit pour votre pool d'adresses IP. Si vous essayez d'éviter les problèmes de blocage d'adresses IP liés au web scraping en alternant davantage d'adresses de centres de données, vous ne faites que passer d'une adresse à l'autre tout en conservant le même problème structurel.
Le problème du « Trust Score » va bien au-delà de l'adresse IP
La fixation de l'adresse IP est l'étape la plus déterminante, mais les systèmes de détection anti-bot ne se limitent pas à l'analyse de l'adresse IP. Au moment où une requête arrive, plusieurs autres signaux ont déjà été évalués.
- L'empreinte TLS permet d'identifier le type de client dès la phase d'établissement de la connexion, avant tout échange de contenu. La plupart des bibliothèques HTTP génèrent une signature TLS différente de celle d'un véritable navigateur, ce qui les trahit immédiatement.
- L'empreinte numérique du navigateur établit un profil à partir de la résolution d'écran, des polices installées, du moteur de rendu WebGL et des données du canevas. Les navigateurs « headless » divulguent des informations spécifiques qui les distinguent des sessions utilisateur réelles.
- Les schémas comportementaux englobent la fréquence des requêtes, les parcours de navigation et les données d'interaction. Les requêtes qui arrivent à des intervalles parfaitement réguliers ou qui s'écartent du comportement de navigation habituel se démarquent.
- Les en-têtes de requête viennent compléter le tableau. Les en-têtes manquantes ou incohérentes, qui ne correspondent pas à l’agent utilisateur déclaré, sont immédiatement signalées.
Rien de tout cela ne compense une mauvaise adresse IP. Une adresse IP résidentielle dotée d'un score de confiance élevé augmente les chances que tous les autres signaux soient acceptés. Une adresse IP de centre de données fausse l'évaluation avant même que les autres signaux ne soient examinés.
Comment les proxys résidentiels résolvent le problème à la racine
Les proxys résidentiels destinés au web scraping remplacent les adresses IP de centres de données par des adresses attribuées par de véritables FAI à de véritables connexions domestiques. Les systèmes anti-bots les considèrent dès la première requête comme du trafic probablement humain, car c’est ce qu’indiquent les métadonnées associées à ces adresses IP.
L'amélioration du score de confiance est immédiate. Une adresse IP résidentielle n'est pas associée à la classification « centre de données » qui entraîne automatiquement l'attribution de scores faibles. Elle part d'un niveau de référence neutre ou positif, ce qui permet au reste de la requête d'avoir une chance de passer les autres couches de détection.
La rotation permet de résoudre le problème d'échelle. La rotation des proxys utilisés pour le scraping répartit les requêtes sur un vaste pool d'adresses. Aucune adresse IP ne cumule à elle seule suffisamment d'historique de requêtes pour déclencher la détection de schémas récurrents. Chaque adresse du pool part d'une situation « propre ».
En combinant la rotation des adresses IP résidentielles avec des en-têtes de requête réalistes et un espacement aléatoire entre les requêtes, on obtient des taux de réussite de 90 à 95 % sur la plupart des sites web protégés. C'est ce qui fait la différence entre une opération de scraping qui fonctionne en continu et une autre qui passe la moitié de son temps à gérer les blocages.
Pour l'analyse des données analyse de données où une même adresse IP doit conserver son état sur plusieurs requêtes, les proxys FAI statiques constituent la meilleure solution. Même légitimité résidentielle, même niveau de base de score de confiance, sans rotation. C’est également là que les problèmes liés au contournement des CAPTCHA lors de l’extraction de données disparaissent efficacement, car le score de confiance ne baisse jamais suffisamment pour en déclencher un.
À quoi ressemble la rotation des proxys résidentiels à grande échelle ?
Près de 40 % des développeurs ont déjà recours à des services de proxy pour contourner les barrières anti-bots. Pour quiconque effectue du scraping à grande échelle, une infrastructure de web scraping basée sur des proxys résidentiels n'est pas une option, mais bien la base même de son activité.
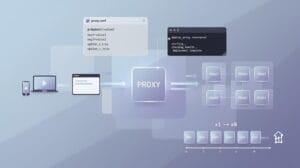
Voici comment fonctionne la rotation dans la pratique. Chaque requête passe par une adresse IP résidentielle différente issue du pool. Aucune adresse ne cumule à elle seule suffisamment de trafic pour déclencher une limitation de débit ou la détection d'un proxy utilisé pour le web scraping. Le pool reste « propre » grâce à la répartition de la charge.
La répartition géographique a également son importance. Les adresses IP réparties sur différents lieux pertinents donnent davantage l'impression d'un trafic naturel qu'un pic concentré provenant d'une seule région.
La couche comportementale est gérée par le biais de la synchronisation. Des délais aléatoires de 2 à 10 secondes entre les requêtes permettent d'éviter les intervalles parfaitement réguliers que les systèmes anti-bots détectent comme étant le fait d'un automatisme.
Pour les opérations de collecte de données de recherche , c'est cette combinaison qui permet aux robots de collecte de fonctionner en continu. Une collecte de données sur le Web avec rotation des proxys, lorsqu’elle est correctement mise en œuvre, garantit que l’opération ne laisse jamais une empreinte suffisante sur une seule adresse IP pour attirer l’attention.
Proxys résidentiels rotatifs d'IPBurger pour le web scraping
La plupart des opérations de scraping se heurtent au même obstacle. Les adresses IP des centres de données sont signalées, les blocages s'accumulent et l'équipe passe plus de temps à gérer l'infrastructure qu'à collecter des données. Le passage aux proxys résidentiels d'IPBurger pour le scraping Web résout ce problème à la source.
Voici à quoi ressemble l'infrastructure :
- Plus de 75 millions de proxys résidentiels rotatifs répartis dans plus de 190 pays, chacun présentant un historique vierge et n'ayant jamais été associé à des activités de scraping ou à des bots
- Ciblage au niveau de la ville et du pays afin que les requêtes proviennent des emplacements précis requis par votre collecte de données
- Une classification IP résidentielle authentique que les systèmes anti-bots considèrent comme du trafic légitime dès la première requête
- Aucune plage de centres de données partagés ne déclenche automatiquement des scores de confiance faibles avant même qu’une seule requête ne soit traitée
Le résultat est une solution d'extraction de données contournant les CAPTCHA, évolutive et ne nécessitant aucune charge de maintenance permanente. Finis les obstacles CAPTCHA, les cycles de rotation des adresses IP bannie et les interventions d'urgence sur l'infrastructure. Le système fonctionne et les données affluent.
Ne résolvez plus les CAPTCHA. Ne les recevez plus.
Plus de 80 % des détaillants américains ont déjà recours à l'extraction automatisée des prix pour la réévaluation dynamique des prix. Ces entreprises ne résolvent pas manuellement les CAPTCHA : elles ont mis en place une infrastructure qui ne les génère pas.
L'objectif n'a jamais été de contourner les bloqueurs de scraping des données CAPTCHA. Il s'agissait plutôt de maintenir un score de confiance suffisamment élevé pour qu'ils n'apparaissent jamais. Les adresses IP de centres de données rendent cela impossible à grande échelle. Les proxys résidentiels destinés au scraping Web en font la norme.
Réglez l'adresse IP, et le reste suivra.