Bạn mở rộng quy mô công cụ thu thập dữ liệu và các rào cản bắt đầu xuất hiện. CAPTCHA xuất hiện khắp nơi, công cụ thu thập dữ liệu web bị chặn ở một nửa số yêu cầu, các địa chỉ IP bị cấm ngay cả trước khi yêu cầu kịp được xử lý. Thế là bạn bắt đầu tìm cách vượt qua các CAPTCHA. Đó không phải là hướng đi đúng đắn.
CAPTCHA không phải là nguyên nhân gây ra vấn đề. Chúng chỉ là dấu hiệu báo trước vấn đề. Khi CAPTCHA xuất hiện, địa chỉ IP của bạn đã bị đánh dấu là đáng ngờ rồi.
Thị trường thu thập dữ liệu web đang trên đà tăng gần gấp ba lần vào năm 2032. Các hoạt động quy mô lớn như vậy đã giải quyết vấn đề địa chỉ IP trước tiên. Đó chính là nội dung chính của bài viết này.
Những thách thức trong việc thu thập dữ liệu khi vượt qua CAPTCHA sẽ không biến mất cho đến khi cơ sở hạ tầng đằng sau chúng được thay đổi.
CAPTCHA thực sự đang muốn nói gì với bạn
Các hệ thống chống bot như Cloudflare, DataDome và Akamai tính toán điểm tin cậy cho mỗi yêu cầu đến trước khi bất kỳ nội dung nào được phân phối. Loại địa chỉ IP, danh tiếng IP, dấu vân tay TLS, dấu vân tay trình duyệt, tiêu đề yêu cầu. Tất cả các yếu tố này đều được tính vào điểm số, từ đó quyết định bước tiếp theo sẽ diễn ra như thế nào.
Khi điểm số đó giảm xuống dưới ngưỡng quy định, một CAPTCHA sẽ xuất hiện. Khi điểm số thấp đến mức nhất định, yêu cầu sẽ bị chặn ngay lập tức.
Đó là lý do tại sao việc giải CAPTCHA không hiệu quả khi áp dụng trên quy mô lớn. Điểm số đã kích hoạt cơ chế này vẫn còn thấp. Yêu cầu tiếp theo sẽ đi qua cùng một hệ thống cơ sở hạ tầng và nhận được kết quả tương tự.
Việc chỉ khắc phục triệu chứng trong khi vấn đề cốt lõi là việc trích xuất dữ liệu qua CAPTCHA vẫn còn tồn tại chỉ dẫn đến việc phải đối mặt với nhiều CAPTCHA hơn, nhiều trường hợp bị chặn hơn và tốn nhiều thời gian hơn cho việc bảo trì thay vì thu thập dữ liệu.
Tại sao các địa chỉ IP của trung tâm dữ liệu lại không đáp ứng được khi mở rộng quy mô
Các địa chỉ IP của trung tâm dữ liệu đến từ các nhà cung cấp dịch vụ đám mây như AWS, Google Cloud và Azure. Các hệ thống chống bot đều nắm rõ mọi dải địa chỉ IP mà các nhà cung cấp này sở hữu. Ngay khi một yêu cầu đến từ một trong những dải địa chỉ đó, nó sẽ bị đánh dấu là có khả năng là yêu cầu tự động trước khi bất kỳ kiểm tra nào khác được thực hiện.
Đó chính là vấn đề cơ bản trong việc phát hiện các hoạt động thu thập dữ liệu qua địa chỉ IP trung tâm dữ liệu. Một địa chỉ IP trung tâm dữ liệu không chỉ có điểm tin cậy thấp vì những gì bạn đã làm với nó. Nó có điểm thấp vì bản chất của nó. Các địa chỉ IP trung tâm dữ liệu được chia sẻ càng làm tình hình tồi tệ hơn. Hàng trăm công cụ thu thập dữ liệu luân phiên sử dụng cùng một dải địa chỉ có nghĩa là những địa chỉ IP đó nhanh chóng tích lũy lịch sử bị chặn. Bạn sẽ kế thừa lịch sử đó ngay khi kết nối.
Khi mở rộng quy mô, vấn đề này sẽ nhanh chóng trở nên nghiêm trọng hơn. Càng gửi nhiều yêu cầu, lịch sử hoạt động liên quan đến nhóm địa chỉ IP của bạn càng tích lũy nhiều. Nếu bạn đang cố gắng tránh các vấn đề bị chặn IP do thu thập dữ liệu web bằng cách luân phiên sử dụng nhiều địa chỉ từ các trung tâm dữ liệu khác nhau, thì thực chất bạn chỉ đang luân phiên sử dụng nhiều địa chỉ hơn với cùng một vấn đề cơ bản.
Vấn đề về điểm tin cậy còn sâu xa hơn cả vấn đề về địa chỉ IP
Việc cố định địa chỉ IP là bước có tác động lớn nhất, nhưng các hệ thống phát hiện và ngăn chặn bot không chỉ dừng lại ở việc phân tích địa chỉ IP. Khi một yêu cầu được gửi đến, nhiều tín hiệu khác đã được đánh giá từ trước đó.
- Phương pháp nhận dạng dấu vân tay TLS xác định loại máy khách thông qua quá trình bắt tay (handshake) trước khi bất kỳ nội dung nào được trao đổi. Hầu hết các thư viện HTTP đều tạo ra dấu vân tay TLS khác với trình duyệt thực sự, và đây chính là dấu hiệu nhận biết ngay lập tức.
- Kỹ thuật nhận dạng dấu vân tay trình duyệt tạo ra một hồ sơ dựa trên độ phân giải màn hình, các phông chữ đã cài đặt, trình hiển thị WebGL và dữ liệu canvas. Các trình duyệt không giao diện (headless) để lộ những chi tiết cụ thể giúp phân biệt chúng với các phiên người dùng thực.
- Các mẫu hành vi bao gồm thời điểm gửi yêu cầu, đường dẫn điều hướng và dữ liệu tương tác. Những yêu cầu được gửi đến với khoảng thời gian hoàn toàn đều đặn hoặc không tuân theo hành vi duyệt web thông thường sẽ trở nên nổi bật.
- Các tiêu đề yêu cầu hoàn thiện quy trình này. Các tiêu đề bị thiếu hoặc không khớp với User-Agent đã khai báo sẽ ngay lập tức bị đánh dấu.
Không có yếu tố nào trong số này có thể bù đắp cho một địa chỉ IP kém chất lượng. Một địa chỉ IP dân dụng có điểm tin cậy cao sẽ giúp các tín hiệu khác có cơ hội được chấp nhận cao hơn. Trong khi đó, một địa chỉ IP từ trung tâm dữ liệu sẽ làm sai lệch kết quả đánh giá ngay từ đầu, trước khi các tín hiệu khác được kiểm tra.
Cách các máy chủ proxy dành cho hộ gia đình giải quyết tận gốc vấn đề
Các proxy dân dụng dùng cho việc thu thập dữ liệu web thay thế các địa chỉ IP từ trung tâm dữ liệu bằng các địa chỉ do các nhà cung cấp dịch vụ internet (ISP) thực sự cấp cho các kết nối hộ gia đình thực sự. Các hệ thống chống bot coi chúng là lưu lượng truy cập có khả năng đến từ người dùng thực ngay từ yêu cầu đầu tiên, bởi vì đó chính là thông tin mà siêu dữ liệu IP cho thấy.
Điểm tin cậy được cải thiện ngay lập tức. Địa chỉ IP dân dụng không thuộc phân loại “trung tâm dữ liệu” – loại phân loại khiến điểm tin cậy bị hạ xuống mức thấp một cách tự động. Điểm tin cậy bắt đầu từ mức cơ sở trung lập hoặc tích cực, từ đó tạo cơ hội cho phần còn lại của yêu cầu vượt qua các lớp phát hiện khác.
Kỹ thuật luân phiên giải quyết vấn đề về quy mô. Các proxy luân phiên dùng cho việc thu thập dữ liệu sẽ phân bổ các yêu cầu trên một nhóm địa chỉ IP lớn. Không có địa chỉ IP nào tích lũy đủ lịch sử yêu cầu để kích hoạt cơ chế phát hiện mẫu. Mỗi địa chỉ trong nhóm đều bắt đầu với trạng thái “sạch”.
Việc kết hợp cơ chế luân phiên địa chỉ IP dân dụng với các tiêu đề yêu cầu chân thực và thời gian ngẫu nhiên giữa các yêu cầu giúp đạt tỷ lệ thành công từ 90–95% trên hầu hết các trang web được bảo vệ. Đó chính là sự khác biệt giữa một hoạt động thu thập dữ liệu diễn ra liên tục và một hoạt động phải dành một nửa thời gian để xử lý các trường hợp bị chặn.
Đối với việc phân tích dữ liệu viên phân tích dữ liệu trong đó cùng một địa chỉ IP cần duy trì trạng thái qua nhiều yêu cầu, các proxy ISP tĩnh là lựa chọn phù hợp hơn. Cùng mức độ hợp pháp như địa chỉ IP dân cư, cùng mức điểm tin cậy cơ bản, mà không cần xoay vòng. Đó cũng chính là lúc các vấn đề về việc vượt qua CAPTCHA trong việc thu thập dữ liệu gần như biến mất, vì điểm tin cậy không bao giờ giảm xuống mức đủ thấp để kích hoạt CAPTCHA.
Quá trình luân chuyển proxy dân cư trên quy mô lớn diễn ra như thế nào
Gần 40% các nhà phát triển hiện đã sử dụng các dịch vụ proxy để vượt qua các rào cản chống bot. Đối với bất kỳ ai thực hiện thu thập dữ liệu trên quy mô lớn, hạ tầng thu thập dữ liệu web thông qua proxy dân dụng không chỉ là một lựa chọn, mà còn là nền tảng cơ bản.
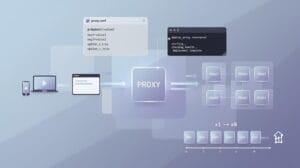
Dưới đây là cách thức hoạt động của cơ chế luân phiên trong thực tế. Mỗi yêu cầu sẽ được gửi qua một địa chỉ IP dân dụng khác nhau trong nhóm. Không có địa chỉ nào tích lũy đủ lưu lượng để kích hoạt cơ chế giới hạn tốc độ hoặc bị phát hiện là proxy dùng để trích xuất dữ liệu web. Nhóm địa chỉ IP luôn được duy trì an toàn nhờ việc phân tán tải.
Phân bố địa lý cũng rất quan trọng. Các địa chỉ IP phân bố rải rác tại các vị trí liên quan sẽ trông giống lưu lượng truy cập tự nhiên hơn so với một đợt truy cập tập trung từ một khu vực duy nhất.
Lớp hành vi được điều chỉnh thông qua thời gian. Các khoảng trễ ngẫu nhiên từ 2 đến 10 giây giữa các yêu cầu giúp tránh được những khoảng thời gian hoàn toàn đều đặn – điều mà các hệ thống chống bot thường đánh dấu là hoạt động tự động.
Đối với dữ liệu có khối lượng lớn và các hoạt động thu thập dữ liệu , sự kết hợp này chính là yếu tố giúp các công cụ thu thập dữ liệu web hoạt động liên tục. Việc thu thập dữ liệu web bằng cách xoay vòng proxy nếu được thực hiện đúng cách sẽ đảm bảo hoạt động này không bao giờ để lại dấu vết đủ lớn trên bất kỳ địa chỉ IP nào đến mức bị phát hiện.
Các proxy dân cư luân phiên của IPBurger dành cho việc thu thập dữ liệu web
Hầu hết các hoạt động thu thập dữ liệu đều vấp phải cùng một trở ngại. Các địa chỉ IP của trung tâm dữ liệu bị đánh dấu, các lệnh chặn ngày càng nhiều, và đội ngũ phải dành nhiều thời gian hơn cho việc quản lý hạ tầng thay vì thu thập dữ liệu. Việc chuyển sang sử dụng các proxy dân dụng của IPBurger cho việc thu thập dữ liệu web sẽ giải quyết vấn đề này ngay từ gốc rễ.
Dưới đây là hình ảnh về cơ sở hạ tầng:
- Hơn 75 triệu proxy dân cư luân phiên tại hơn 190 quốc gia, mỗi proxy đều có lịch sử hoạt động sạch sẽ và chưa từng liên quan đến việc thu thập dữ liệu trái phép hay bot
- Nhắm mục tiêu theo cấp độ thành phố và quốc gia để các yêu cầu được phát ra từ chính xác các vị trí mà quá trình thu thập dữ liệu của bạn yêu cầu
- Phân loại IP dân dụng thực sự mà các hệ thống chống bot coi là lưu lượng truy cập hợp lệ ngay từ yêu cầu đầu tiên
- Không có dải địa chỉ trung tâm dữ liệu được chia sẻ nào gây ra việc tự động hạ điểm tin cậy trước khi có bất kỳ yêu cầu nào được gửi đến
Kết quả tổng thể là một hệ thống trích xuất dữ liệu bỏ qua CAPTCHA có khả năng mở rộng quy mô mà không cần chi phí bảo trì liên tục. Không còn rào cản CAPTCHA, không còn chu kỳ luân chuyển địa chỉ IP do bị chặn, không còn phải xử lý khẩn cấp các sự cố về hạ tầng. Hệ thống vận hành trơn tru và dữ liệu liên tục được thu thập.
Đừng giải CAPTCHA nữa. Đừng để chúng xuất hiện nữa.
Hơn 80% các nhà bán lẻ tại Mỹ hiện đã sử dụng công nghệ thu thập giá tự động để điều chỉnh giá theo thời gian thực. Các hoạt động này không giải quyết CAPTCHA theo cách thủ công. Họ đã xây dựng một hệ thống cơ sở hạ tầng không tạo ra CAPTCHA.
Mục tiêu không bao giờ là để vượt qua các cơ chế chặn thu thập dữ liệu CAPTCHA. Mục tiêu là duy trì điểm tin cậy đủ cao để các cơ chế đó không bao giờ xuất hiện. Các địa chỉ IP của trung tâm dữ liệu khiến điều này trở nên bất khả thi khi thực hiện trên quy mô lớn. Trong khi đó, việc sử dụng proxy dân dụng để thu thập dữ liệu web lại khiến điều này trở thành tiêu chuẩn mặc định.
Chỉ cần khắc phục vấn đề về địa chỉ IP là mọi thứ khác sẽ tự khắc ổn thỏa.