无论是个人决策还是商业决策,数据集都是做出明智选择的关键。在本完整指南中了解如何查找和提取数据集。
收集和分析网络数据对企业来说非常有价值。通过了解人们与公司网站的交互方式,可以获得有助于改善用户体验、设计和营销等方面的见解。本博文将讨论网络数据收集和分析的基础知识,包括什么是网络数据、为什么网络数据至关重要以及如何开始提取网络数据。
数据集类型。
数据集有三种类型:
1. 原始数据 -在处理或清理之前的原始数据。原始数据始终是寻找准确性的最佳起点。
2.处理过的数据--是干净的数据,可用于分析 通常,你会看到表格形式的处理过的数据。
3.分析数据--是经过处理和分析的数据,可用于解释。
在哪里可以找到数据集?
有许多不同的地方可以为数据科学和机器学习项目查找数据集。下面是一些最受欢迎的来源。
1.加州大学洛杉矶分校机器学习资料库--是一个庞大的数据集集合,包括各种机器学习算法的训练和测试数据。
2.Kaggle是数据科学家和机器学习专家分享数据集和参加数据科学竞赛的平台。
3.数据枢纽是一个搜索引擎,可让您搜索各种来源的数据集,包括政府数据集。
如何使用数据集
数据集是数据驱动决策的宝贵资源。您可以使用它们来训练机器学习模型、制定业务决策等。使用数据集有几种方法:
1.训练机器学习模型
数据集可用于训练机器学习模型。方法是将数据集分成两部分:训练集和验证集。训练集用于训练模型,验证集用于评估模型的准确性。
2.做出商业决策
数据集可用于帮助企业做出更好的决策。例如,零售商可能会分析顾客的消费模式,以决定在店内备有哪些产品。
3.侦查欺诈行为
数据集可用于检测欺诈模式。例如,银行可以利用客户交易数据来识别可能表明存在欺诈行为的可疑行为。
4.了解客户需求
数据集可用于了解客户的需求和偏好。例如,公司可以利用客户调查数据来了解客户需要哪些产品和服务。
自定义数据集。
有时,数据集已经过时或与您的决策无关。在这种情况下,您应该直接从数据源获取数据。获取实时数据的唯一方法就是从网站上抓取数据。有两种刮取数据的方法:
人工刮削
当你想从少量网站中提取数据时,请使用这种方法。您需要在浏览器中打开网站,然后手动复制数据。
1.在浏览器中打开网站。
2.选择要提取的数据。
3.复制数据。
4.将数据粘贴到电子表格或文本编辑器中。
自动刮削
当你想从许多网站中提取数据时,可以使用这种方法。你需要找到一个能自动为你搜刮数据的工具。有几种不同的工具可以帮你做到这一点,其中大多数都相当容易使用。
您可以借助可下载到计算机上或通过网页浏览器使用的软件程序,进行自动网页抓取。网页抓取API虽然最易于使用,但价格往往较高。开源的抓取应用程序、爬虫和解析脚本虽然需要更多的编程知识,但您可以以相对较低的成本收集大量数据。
使用自动网页抓取工具的唯一问题是,网站通常会封禁那些表现得像机器人的访问者的IP地址。要避免被封禁,只需找到一些高质量的住宅代理即可。
使用代理,让工作变得简单而准确。
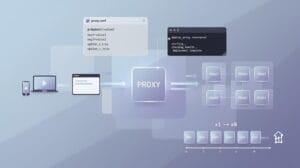
代理轮换是网站爬取过程中必不可少的头号工具。如果不轮换 IP 地址,您将不断遭遇IP 封禁,这不仅会拖慢数据采集进程,还会导致数据质量不理想。通过使用轮换的住宅代理,您可以放心,不会遇到任何问题。您的数据安全无虞,系统运行稳妥,还能节省您最宝贵的资源——时间。
想找到一款完美的网络爬虫工具来采集数据集吗?快来看看我们关于如何选择爬虫工具的文章吧。