L'analyse syntaxique des données consiste à convertir des données d'un format (par exemple, JSON, XML) à un autre (par exemple, JavaScript Object Notation). Cela peut être utile lorsque vous souhaitez stocker des données structurées dans votre application et que vous ne savez pas à quoi elles ressembleront au moment de l'exécution. L'analyse syntaxique vous permet d'utiliser un langage de programmation qui vous est plus familier, tel que JavaScript, au lieu d'utiliser un tout autre langage pour la même tâche.
L'analyse syntaxique des données est également utilisée à d'autres fins : par exemple, si une API renvoie des données au format JSON. Toutefois, si votre programme ne comprend que les données au format XML, vous n'aurez pas d'autre choix que d'analyser les données JSON pour les rendre compréhensibles par votre programme.
Le moyen le plus courant d'y parvenir consiste à utiliser une bibliothèque appelée jQuery, qui analyse les documents HTML pour les transformer en éléments DOM, puis utilise ces éléments dans son code. Cela permet aux développeurs qui ne maîtrisent pas la syntaxe HTML/CSS/JavaScript de travailler plus facilement avec des API qui renvoient du contenu HTML.
Vous êtes confus ? Dans ce cas, voyons ce qu'il en est.
Comment fonctionne l'analyse des données ?
L'analyse des données consiste à analyser le contenu HTML brut pour en faire un modèle d'objet prêt à être interrogé. Ce processus est appelé mappage ou indexation. En sortie, tous les champs sont mappés avec leurs valeurs respectives extraites du document/de la page/du courrier électronique source, etc.
Pourquoi utiliser l'analyse syntaxique des données ?
Voici quelques-unes des utilisations les plus courantes : L'extraction de données à partir de sites web, de courriers électroniques et d'autres documents. Pour ce faire, le contenu HTML est analysé et transformé en un modèle d'objet qui peut être interrogé pour récupérer les informations requises. La sortie aura tous les champs mappés avec leurs valeurs extraites du document/page/mail source. Il fournit également des méthodes pour interroger ces objets et récupérer les informations requises.
Ces bibliothèques prennent en charge diverses requêtes, y compris les expressions régulières, les requêtes XPath et des techniques plus avancées comme XQuery, qui vous permet d'écrire des requêtes personnalisées à l'aide de la syntaxe XML. Les langages les plus couramment utilisés sont Java, PHP, Python, C# .NET, etc.
Plusieurs types d'analyseurs syntaxiques sont disponibles sur le web aujourd'hui, mais ils fonctionnent tous de la même manière : ils convertissent le texte d'entrée en une structure d'objets représentant ce qu'ils trouvent dans ce texte.
Les objets représentent soit des nœuds, soit des attributs à l'intérieur de ces nœuds (éléments). Par exemple, si vous avez un document contenant des balises avec du contenu à l'intérieur, chaque balise représente un nœud d'objet dans la structure résultante. Elles représentent tout ce qui se trouve dans le contenu de cet élément. La balise serait représentée comme un nœud d'attributs contenant des informations sur son élément parent.
Dans les sections suivantes, nous aborderons quelques-uns des analyseurs les plus populaires disponibles sur le web aujourd'hui.
Bibliothèques d'analyse Html.
Les bibliothèques HTML d'analyse de données sont utilisées pour analyser le contenu HTML et en extraire les données. Elles sont utilisées pour extraire des données de pages web, de documents, d'e-mails ou de textes structurés. Ces bibliothèques peuvent être utilisées à diverses fins, telles que l'extraction de données de sites web, l'analyse de messages électroniques, etc.
Une belle soupe
Beautiful Soup est une bibliothèque Python destinée à l'analyse syntaxique du HTML. Conçue pour être simple d'utilisation et rapide, elle est néanmoins suffisamment puissante pour traiter les documents les plus complexes. Beautiful Soup peut analyser du code HTML provenant de nombreuses sources, notamment des fichiers, des URL, des e-mails et même le presse-papiers.
L'analyse des balises et des attributs HTML se fait de manière rapide mais décisive. Cela signifie que Beautiful Soup peut traiter les documents les plus complexes.
Beautiful Soup a été conçu pour être facile à utiliser, avec une API simple pour manipuler le document et un ensemble complet de classes pour travailler avec les éléments de votre document.
Cheerio
Cheerio prend en charge l'analyse des documents au format JavaScript Object Notation (JSON) ainsi que la notation native des objets ECMAScript (ES5) de JavaScript. Outre la syntaxe ES5, il prend également en charge des fonctionnalités plus récentes telles que les fonctions fléchées dans les blocs de code ES6. L'API de Cheerio est conçue pour être facile à utiliser et à intégrer à d'autres bibliothèques. Elle permet d'accéder aux données analysées sous la forme d'une Map Java, d'une ArrayList ou d'un flux d'objets JSON.
JSoup
JSoup est une bibliothèque permettant d'analyser des documents HTML et XML. Elle fournit une API qui permet d'analyser des fichiers HTML, XML, JSON et CSS, ainsi que des éléments DOM. Vous pouvez utiliser cet analyseur de différentes manières :
- extraire des données du document (par exemple, extraire tous les liens d'une page HTML).
- créer de nouveaux documents (par exemple, créer un nouveau fichier XML à partir de zéro ou convertir un fichier HTML existant dans son format XHTML équivalent).
- à des fins de validation (par exemple, validation des formulaires en fonction des valeurs saisies).
Marionnettiste
Puppeteer est une extension de navigateur qui vous permet d'inspecter et de modifier le DOM de n'importe quel site web. Elle est actuellement disponible pour Chrome, Firefox et Opera.
Comment utiliser Puppeteer pour l'analyse des données ?
La façon la plus simple de l'utiliser est d'utiliser l'icône de l'extension dans la barre d'outils de votre navigateur : Une fois l'extension installée, vous verrez apparaître une nouvelle icône dans la barre d'outils de votre navigateur :
Cliquez sur l'icône et vous serez invité à choisir le site web à inspecter. Lors de la première exécution, il vous demandera la permission d'accéder à tous les sites web actuellement ouverts dans votre navigateur. Vous pouvez toujours modifier ce choix ultérieurement en cliquant sur le bouton Options en bas de la fenêtre :
À partir de là, utilisez Puppeteer Parser comme n'importe quel autre inspecteur DOM. Il fonctionne exactement comme Chrome Developer Tools ou Firefox Developer Tools, mais il est beaucoup plus puissant que l'un ou l'autre de ces outils.
Construire un analyseur syntaxique ou acheter un analyseur syntaxique.
La construction d'un analyseur syntaxique ne se limite pas à la création de l'analyseur. Il s'agit également de comprendre comment l'utiliser. Cela signifie que vous devez comprendre la grammaire de votre langue et apprendre à écrire un bon lexer/tokenizer (ce qui nécessite une connaissance suffisante des expressions régulières).
De nombreuses personnes pensent qu'il est moins cher d'acheter un analyseur syntaxique que d'en créer un à partir de zéro. Mais ce n'est pas vrai : si vous achetez un analyseur syntaxique, il sera installé gratuitement sur votre ordinateur par le logiciel que vous êtes en train d'installer. Vous pouvez alors l'utiliser sans vous soucier de configurer ou d'installer quoi que ce soit d'autre.
Cela peut sembler un avantage, mais la plupart des analyseurs ont des limitations qui les rendent inadaptés à certaines applications (par exemple, ils ne prennent pas en charge les structures imbriquées).
De plus, bien qu'il existe de nombreux analyseurs libres, leurs actions sont généralement très limitées. Ils ne peuvent pas gérer des grammaires plus compliquées que celles supportées par leurs bibliothèques de base (même ces bibliothèques ont souvent des restrictions).
Enfin, lorsque vous écrivez du code à partir d'une telle bibliothèque, vous devez toujours garder à l'esprit que les différentes versions peuvent se comporter différemment, en fonction de leur auteur. Ainsi, à moins que quelqu'un n'ait écrit des tests pour sa bibliothèque et une documentation expliquant ce que fait chaque élément - et pourquoi - l'utilisation d'une telle API pourrait être assez frustrante.
Examinons donc les avantages de la création d'un analyseur syntaxique :
- Vous pouvez écrire votre propre analyseur pour une grammaire qu'aucune bibliothèque ne prend en charge. Vous n'avez pas à vous fier aux limitations d'un analyseur préexistant, et vous pouvez le rendre aussi compliqué ou simple que vous le souhaitez.
- Vous pourrez l'utiliser dans tous vos projets sans avoir à vous soucier des problèmes de portabilité (par exemple, si un jour quelqu'un décide de passer de la version 2.0 à la version 3.5 de .NET Framework).
- C'est beaucoup plus facile que d'écrire des tests pour un analyseur. Comme il n'y a aucune restriction sur ce que vous pouvez faire avec, vous avez un contrôle total sur ce qui se passe pendant l'analyse et sur la façon dont chaque élément se comporte lorsqu'il est rencontré (vous pouvez même décider que certains éléments doivent se comporter différemment selon le contexte).
- Le code sera plus simple car de nombreuses choses comme la gestion des erreurs, les exceptions, etc., sont déjà prises en charge par le framework lui-même (et de cette manière, elles n'encombreront pas inutilement votre code).
- Enfin, la plupart des analyseurs syntaxiques sont assortis de restrictions : ils ne prennent en charge que certaines grammaires ou structures, alors que la création de votre propre analyseur syntaxique vous permet de créer le type de grammaire qui vous convient le mieux.
Procurations résidentielles.
Si vous analysez des données HTML extraites de sites web, vous pouvez utiliser des outils d'automatisation.
Saviez-vous que la rotation du proxy est cruciale pour retrouver rapidement les bonnes données ?
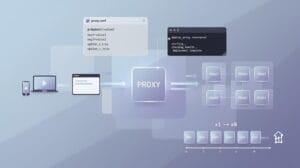
De nombreux sites web bloquent les outils de scraping web s'ils n'utilisent pas des proxys résidentiels rotatifs. Les proxys ne se contentent pas de masquer leur adresse IP et d'empêcher les interdictions : ils peuvent répartir les requêtes entre des milliers d'IP.
IPBurger propose une rotation automatique des proxys avec un nombre illimité de threads et de connexions simultanées. Vous pouvez ainsi accélérer considérablement la collecte de données sans jamais avoir à vous soucier des blocages d'adresses IP.
Consultez notre page consacrée aux proxys pour le web scraping pour en savoir plus.