Web-Scraping ist unverzichtbar, aber nicht ganz einfach. Websites blockieren es häufig, wodurch es schwierig wird, an Daten zu gelangen. Hier kommt IPBurger ins Spiel – mit seinen erstklassigen Proxys – sowohl dedizierten als auch rotierenden –, damit Sie unerkannt bleiben.
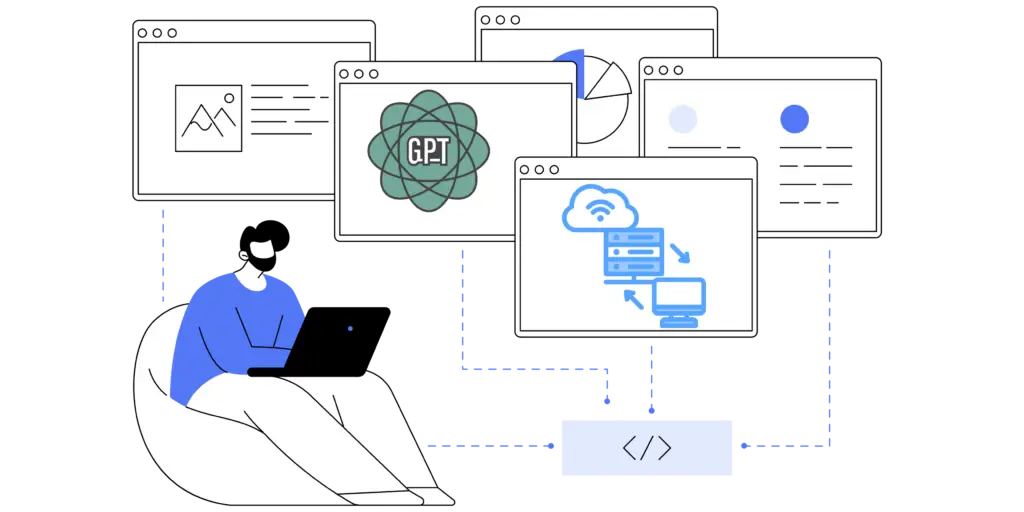
Hier kommt ChatGPT ins Spiel: Es gehtnicht nur darum, Daten zu extrahieren, sondern sie auch zu verstehen. In Kombination mit IPBurger bildet es ein leistungsstarkes Duo für alle, die sich ernsthaft mit Web-Scraping beschäftigen.
Dieser Artikel dient Ihnen als Leitfaden für den Einsatz von Web-Scraping mit IPBurger und ChatGPT. Wir zeigen Ihnen, wie Sie effizient und zielgerichtet Daten aus dem Internet extrahieren können – von der Marktforschung bis hin zur Trendbeobachtung. Freuen Sie sich auf klare Tipps ohne überflüssigen Ballast.
Sind Sie bereit? Dann legen wir los.

Die Bedeutung von Proxys beim Web-Scraping
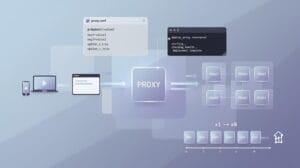
In der Welt des Web-Scrapings sind Proxys Ihre Geheimwaffe. Mit ihnen können Sie Daten erfassen, ohne blockiert zu werden. Stellen Sie sich vor, Sie versuchen mehrmals von derselben IP-Adresse aus, auf eine Website zuzugreifen. Das lässt die Alarmglocken läuten – und schon sind Sie ausgesperrt. Proxys verbergen Ihre echte IP-Adresse und lassen es so aussehen, als käme jede Anfrage von einem anderen Ort. Auf diese Weise bleiben Sie unbemerkt.
Proxys für Privathaushalte im Vergleich zu Proxys für Rechenzentren

- Privatan-Proxys:Hierbei handelt es sich um echte IP-Adressen von tatsächlichen Geräten. Websites erkennen diese als normale Besucher, wodurch die Wahrscheinlichkeit einer Sperrung sinkt. Ideal für Websites, die sich nur schwer auslesen lassen, können jedoch kostspieliger sein.
- Rechenzentrums-Proxys: Diesestammen von Servern in Rechenzentren. Sie sind schnell und kostengünstiger und eignen sich hervorragend für das Scraping in großem Umfang. Der Haken daran? Da sie nicht an einen Internetdienstanbieter gebunden sind, können manche Websites sie möglicherweise schneller blockieren.
Informieren Sie sich hier über die anderen Arten von Proxys.
Warum die Proxys von IPBurger für das Web-Scraping so hervorragend geeignet sind
IPBurger bietet beide Varianten an, sodass Sie die für Ihr Projekt am besten geeignete auswählen können. Hier sind die Gründe, warum sie sich auszeichnen:
- Stealth:Die Proxys von IPBurger wirken wie eine digitale Tarnung und machen Ihre Scraping-Aktivitäten vor neugierigen Blicken unsichtbar.
- Zuverlässigkeit: MitIPBurger können Sie sich auf stabile Verbindungen verlassen. Es kommt nicht mehr vor, dass die Verbindung mitten im Scraping unterbrochen wird.
- Auswahl:Wählen Sie je nach Ihren Anforderungen zwischen Optionen für Privathaushalte und Rechenzentren – ganz gleich, ob es darum geht, sich in den normalen Datenverkehr einzufügen oder umfangreiche Datenabfragen zu bewältigen.
- Globale Reichweite: Greifen Sievon überall aufInhalte zu, umgehen Sie geografische Beschränkungen und erheben Sie Daten auf globaler Ebene.
Die Nutzung der Proxys von IPBurger sorgt für reibungsloseres Scraping, ein geringeres Risiko von Sperren und einen besseren Datenzugriff. Es geht darum, intelligenter zu scrapen, nicht härter.
ChatGPT verstehen

ChatGPT ist eine leistungsstarke KI, die von OpenAI entwickelt wurde. Sie wurde darauf trainiert, auf der Grundlage der ihr zugeführten Eingaben menschenähnliche Texte zu verstehen und zu generieren. Stellen Sie sich das als einen hochintelligenten Chatbot vor, der eine Vielzahl von Themen diskutieren, Fragen beantworten und sogar Code schreiben kann.
Die Funktionen von ChatGPT
Bei ChatGPT geht es nicht nur um Konversation. Es kann Artikel zusammenfassen, Inhalte erstellen, Sprachen übersetzen und vieles mehr. Dank seiner Fähigkeit, natürliche Sprache zu verarbeiten und zu verstehen, ist es für verschiedene Aufgaben, darunter auch das Web-Scraping, unglaublich vielseitig einsetzbar.
Einsatz von ChatGPT beim Web-Scraping
- Datenanalyse: SobaldSie Ihre Daten erfasst haben, kann ChatGPT Ihnen dabei helfen, diese zu interpretieren. Das Programm kann Inhalte zusammenfassen, zentrale Themen identifizieren und sogar die Stimmung analysieren.
- Verbesserte Datenextraktion:ChatGPT kann Sie bei der Erstellung von XPath- oder Regex-Abfragen unterstützen, basierend auf Ihrer Beschreibung der Daten, die Sie extrahieren möchten. Dies erleichtert es Ihnen, die richtigen Informationen auf einer Webseite gezielt zu erfassen.
- Automatisierung:Automatisieren Sie sich wiederholende Analyseaufgaben mit ChatGPT. Beispielsweise die Aufbereitung und Kategorisierung von Kundenbewertungen auf verschiedenen Websites.
- Qualitätskontrolle: ChatGPTkann dazu beitragen, den Datenextraktionsprozess zu optimieren, indem es Unstimmigkeiten oder Fehler in den gesammelten Daten identifiziert und so für Datensätze höherer Qualität sorgt.
Die Einbindung von ChatGPT in Ihren Web-Scraping-Workflow fügt eine Ebene der Intelligenz hinzu, die den Wert der gesammelten Daten erheblich steigern kann. Es geht darum, von der einfachen Datengewinnung zur intelligenten Datenverarbeitung und -analyse überzugehen.
Integration von IPBurger-Proxys in Web-Scraping-Tools
Der Einstieg in die Nutzung von IPBurger für Ihre Web-Scraping-Projekte ist ganz einfach. Wählen Sie zunächst je nach Ihren Anforderungen zwischen dedizierten und rotierenden Proxys. Dedizierte Proxys sind stabil und eignen sich ideal für gezieltes Scraping, während rotierende Proxys die IP-Adresse bei jeder Anfrage wechseln – perfekt für groß angelegte Vorgänge und zur Vermeidung von Erkennung.

- Anmeldung:Registrieren Sie sich bei IPBurger und wählen Sie das Proxy-Paket aus, das zu Ihrem Projekt passt.
- Konfigurationsdetails: Nachdem Kauf erhalten Sie Informationen wie IP-Adressen, Ports und Anmeldedaten.
- Implementierung: Verwenden Siediese Angaben, um Ihr Web-Scraping-Tool oder -Skript so zu konfigurieren, dass Anfragen über die IPBurger-Proxys weitergeleitet werden.
Erfahren Sie hier, welche Art von Proxys Sie benötigen.
Konfiguration von Web-Scraping-Tools und Skripten
Die meisten Web-Scraping-Tools und -Bibliotheken (wie Scrapy, BeautifulSoup oder Selenium) unterstützen die Proxy-Integration. Hier finden Sie eine allgemeine Anleitung zu deren Konfiguration:
- Für skriptbasierte Tools:Fügen Sie in Ihrem Code eine Proxy-Einstellung hinzu, die die Proxy-Daten von IPBurger verwendet. Bei Python-Bibliotheken bedeutet dies häufig, dass Sie in Ihrer HTTP-Anfragefunktion ein Proxy-Wörterbuch festlegen müssen.
- Für GUI-basierte Tools: Suchen Siein den Einstellungen oder Optionen nach einer Proxy-Option. Geben Sie dort die Proxy-Daten von IPBurger ein.
Tipps zur Optimierung der Proxy-Leistung
- Lastenausgleich: Verteilen SieIhre Anfragen auf mehrere Proxys. Dies verringert das Risiko einer Überlastung eines einzelnen Proxys und trägt dazu bei, eine Erkennung zu vermeiden.
- Anfrageraten verwalten: Selbstbei Verwendung von Proxys kann das Überfluten einer Website mit zu vielen Anfragen in zu kurzer Zeit zu Sperrungen führen. Nutzen Sie die Ratenbegrenzung in Ihrem Scraping-Tool, um die Anfragen zeitlich zu staffeln.
- Proxys wechseln:Wenn Sie die rotierenden Proxys von IPBurger nutzen, sollten Sie die Rotationsfunktion voll ausschöpfen, um natürliche Surfgewohnheiten nachzuahmen. Bei dedizierten Proxys sollten Sie in Betracht ziehen, diese manuell zu wechseln, wenn Sie über einen längeren Zeitraum hinweg dieselbe Website aufrufen.
- Geo-Targeting: Nutzen Siedie Geo-Targeting-Funktionen von IPBurger, um auf Inhalte so zuzugreifen, als befänden Sie sich an einem bestimmten Standort – dies ist entscheidend für regional gesperrte Daten.
Die Integration von IPBurger-Proxys in Ihr Web-Scraping-Toolkit verbessert nicht nur Ihre Möglichkeiten, auf Daten aus einer Vielzahl von Quellen zuzugreifen und diese abzurufen, sondern minimiert auch das Risiko, blockiert oder gesperrt zu werden, erheblich. Mit der richtigen Konfiguration und Optimierung können Ihre Web-Scraping-Vorgänge reibungslos und effizient ablaufen, sodass Sie Zugang zu wertvollen Daten erhalten und Ihre Aktivitäten gleichzeitig diskret und sicher bleiben.
Bewährte Verfahren für ethisches Web-Scraping
Web-Scraping befindet sich in einer Grauzone – es ist legal, aber es gibt Regeln. Der Schlüssel liegt im Respekt: gegenüber den Daten, den Websites und den Nutzern, die hinter diesen Daten stehen. Ethisches Scraping bedeutet, Daten zu erheben, ohne Schaden anzurichten oder den normalen Betrieb der Website zu stören.
Rechtliche Rahmenbedingungen und Richtlinien für die Website
- Überprüfen Siedie Datei „robots.txt“: Websitesnutzen diese Datei, um anzugeben, welche Teile ihrer Seite gescrapt werden dürfen. Die Einhaltung dieser Regeln ist der erste Schritt zu einem ethischen Scraping.
- Bleiben Sie über die gesetzlichen Bestimmungen auf dem Laufenden:In verschiedenenLändern gelten unterschiedliche Gesetze zum Thema Web-Scraping. In den USA beispielsweise regelt der „Computer Fraud and Abuse Act“, was als unbefugter Zugriff gilt. Stellen Sie sicher, dass Sie beim Web-Scraping die gesetzlichen Grenzen einhalten.
- Nutzungsbedingungen (ToS): VieleWebsites enthalten in ihren Nutzungsbedingungen Bestimmungen zum Daten-Scraping. Die Nichtbeachtung dieser Bestimmungen kann rechtliche Konsequenzen nach sich ziehen; daher ist es ratsam, diese zu prüfen und einzuhalten.
Der ethische Umgang mit IPBurger-Proxys und ChatGPT
- IPBurger:Bei der Nutzung von Proxys besteht das Ziel darin, auf Daten zuzugreifen, ohne dabei Täuschungsmanöver anzuwenden oder Schaden anzurichten. Nutzen Sie die Proxys von IPBurger, um geografische Beschränkungen zu umgehen oder Ratenbegrenzungen zu verwalten, jedoch nicht, um Sperren aufgrund unethischer Scraping-Praktiken zu umgehen.
- ChatGPT:ChatGPT kann zwar gesammelte Daten verarbeiten und analysieren; stellen Sie jedoch sicher, dass die von Ihnen bereitgestellten Daten auf ethische Weise erhoben wurden. Achten Sie zudem auf Datenschutzbelange, insbesondere im Hinblick auf personenbezogene Daten.
Datenschutz und Sicherheit
- Anonymität von Daten:Gehen Sie beim Umgang mit und bei der Speicherung von Daten, insbesondere von personenbezogenen Daten (PII), mit Bedacht vor. Die Anonymisierung von Daten kann zum Schutz der Privatsphäre einzelner Personen beitragen.
- Sichere Speicherung:Stellen Sie sicher, dass die von Ihnen gesammelten Daten und die aus ChatGPT gewonnenen Erkenntnisse sicher gespeichert werden, um sie vor unbefugtem Zugriff zu schützen.
- Ethischer Umgang: Gehen Sieverantwortungsbewusst mitgesammelten Daten um. Ob für Marktforschung, Wettbewerbsanalysen oder wissenschaftliche Zwecke – die Endnutzung darf weder Einzelpersonen noch Organisationen schaden.
Einen respektvollen Fußabdruck hinterlassen
- Ratenbegrenzung:Wenn Websites mit zu vielen Anfragen überflutet werden, kann dies zum Absturz von Servern oder zu Störungen der Dienste führen. Implementieren Sie in Ihren Scraping-Skripten eine Ratenbegrenzung, um die Surfgeschwindigkeit eines Menschen nachzuahmen.
- Störungen vermeiden:Stellen Sie sicher, dass sich Ihre Scraping-Aktivitäten nicht negativ auf die Leistung der Website für normale Nutzer auswirken.
Beim ethischen Web-Scraping geht es darum, Ihre Datenbedürfnisse mit dem Schutz der Privatsphäre, rechtlichen Grenzen und den Richtlinien von Websites in Einklang zu bringen. Durch die Einhaltung dieser bewährten Vorgehensweisen wird die Nutzung von Tools wie IPBurger-Proxys und ChatGPT zu einer leistungsstarken und verantwortungsvollen Methode, um auf Webdaten zuzugreifen und diese zu analysieren. Es kommt nicht nur darauf an, welche Daten Sie scrapen, sondern auch darauf, wie Sie dabei vorgehen – genau das macht ethisches Scraping aus.
Bewältigung häufiger Herausforderungen beim Web-Scraping
Web-Scraping verläuft nicht immer reibungslos. Sie werden mit CAPTCHAs, IP-Sperren und Ratenbeschränkungen konfrontiert. So können IPBurger und ChatGPT Ihnen helfen, diese Herausforderungen zu meistern:
- CAPTCHAs: Hierbeihandelt es sich um Tests, mit denen Websites Menschen und Bots voneinander unterscheiden. IPBurger kann CAPTCHAs zwar nicht direkt lösen, doch durch die Verwendung wechselnder Proxys lässt sich die Wahrscheinlichkeit verringern, dass Sie auf solche Tests stoßen. Indem die Anfragen auf zahlreiche IP-Adressen verteilt werden, ist es weniger wahrscheinlich, dass Sie die CAPTCHA-Abwehr der Website auslösen.
- IP-Sperren:Wenn eine Website ungewöhnliche Aktivitäten von einer IP-Adresse aus feststellt, kann sie diese sperren. Hier kommen die rotierenden Proxys von IPBurger zum Einsatz, die die IP-Adressen wechseln, um Sperren zu umgehen. Dedizierte Proxys bieten eine stabile Alternative; wechseln Sie diese jedoch manuell aus, falls Sie auf Probleme stoßen sollten.
- Zugriffsbeschränkungen:Websites begrenzen die Häufigkeit Ihrer Zugriffe, um eine Überlastung zu verhindern. Mit IPBurger können Sie Ihre Scraping-Geschwindigkeit anpassen und Anfragen auf mehrere Proxys verteilen, sodass Sie unerkannt bleiben und die zulässigen Grenzen einhalten.
Navigieren auf dynamischen und JavaScript-lastigen Websites
Viele moderne Websites laden ihre Inhalte dynamisch mithilfe von JavaScript, was für herkömmliche Web-Scraper eine Hürde darstellen kann. An dieser Stelle kommt eine Kombination aus Technologie und Strategie ins Spiel:
- Headless-Browser:Tools wie Selenium oder Puppeteer können den Browser eines echten Benutzers simulieren, JavaScript ausführen und es Ihnen ermöglichen, dynamisch geladene Inhalte zu scrapen. Sie beanspruchen zwar mehr Ressourcen, erfüllen aber ihren Zweck.
- Einblick von ChatGPT:Bei komplexen Websites kann die Beschreibung der Struktur und der gewünschten Daten gegenüber ChatGPT zu Scraping-Strategien oder sogar zu Code-Schnipseln führen, mit denen sich schwierige Szenarien bewältigen lassen.
Fortgeschrittene Techniken
- API-Aufrufe: Einigedynamische Inhalte werden über API-Aufrufe geladen. Wenn Sie diese Anfragen mithilfe der Entwicklertools Ihres Browsers untersuchen, können Sie direkte Verweise auf die erforderlichen JSON- oder XML-Daten finden. ChatGPT kann Sie bei der Analyse dieser API-Antworten oder bei der Erstellung von Code zur Automatisierung des Vorgangs unterstützen.
- Datenauswertung: DieAuswertung dynamisch geladener Daten kann eine Herausforderung darstellen, sobald Sie den Inhalt erhalten haben. ChatGPT kann dabei helfen, unstrukturierte Daten zu strukturieren, wodurch sich wertvolle Informationen leichter extrahieren lassen.
Der effektive Einsatz von IPBurger-Proxys verringert das Risiko häufiger Hindernisse beim Web-Scraping, während ChatGPT eine intelligente Lösung für die Komplexität moderner Webtechnologien bietet. Gemeinsam ermöglichen sie Ihnen einen effizienteren Zugriff auf und eine effizientere Extraktion von Webdaten – selbst in den anspruchsvollsten Umgebungen.
Zukünftige Trends beim KI-gestützten Web-Scraping
Die Landschaft des Web-Scrapings entwickelt sich rasant weiter, angetrieben durch Fortschritte bei KI-Technologien und Proxy-Lösungen. Mit Blick auf die Zukunft wird die Integration von Tools wie ChatGPT und Diensten wie IPBurger die Grenzen der Datenerfassung und -analyse neu definieren. Hier erhalten Sie einen Einblick in die zukünftigen Trends und Prognosen in diesem dynamischen Bereich:
Verbessertes Verständnis und verbesserte Interaktion der KI mit Webdaten
- KI-Modelle werden beim Verständnis von Webinhalten immer ausgefeilter werden und sich nicht mehr nur auf deren Extraktion beschränken. So wird beispielsweise erwartet, dass sich ChatGPT weiterentwickelt und Fähigkeiten erlangt, die es ihm ermöglichen, den Kontext von Daten genauer zu interpretieren, den Wert unstrukturierter Daten vorherzusagen und mit minimalem menschlichem Eingriff Erkenntnisse zu liefern.
- Zukünftige KI-Tools werden sich wahrscheinlich wie ein Mensch auf Websites bewegen, dynamische Inhalte verstehen und Interaktionen durchführen, die eine Reaktion erfordern, wie beispielsweise das Ausfüllen von Formularen oder das Durchlaufen mehrstufiger Prozesse.
Fortschrittliche Proxy-Lösungen für beispiellosen Zugriff
- IPBurger und ähnliche Dienste werden weiterhin innovativ sein und differenziertere Proxy-Optionen anbieten, die auf spezifische Scraping-Anforderungen zugeschnitten sind. Es sind Entwicklungen im Bereich der Proxy-Technologien zu erwarten, die noch widerstandsfähigere Lösungen gegen IP-Sperren und geografische Beschränkungen bieten und einen nahtlosen Zugriff auf Daten weltweit ermöglichen.
- Die Einführung von KI-gesteuerten Proxys, die auf der Grundlage einer Echtzeitanalyse des Netzwerkverkehrs und der Sperren automatisch die beste Routenführung für Ihre Scraping-Aufgaben auswählen, könnte die Effizienz und die Erfolgsquote erheblich steigern.
Nahtlose Integration zwischen KI und Proxys
- In Zukunft wird es zu einer engeren Verzahnung zwischen KI-Tools und Proxy-Diensten kommen, wodurch Web-Scraping-Projekte optimiert werden. Diese Integration ermöglicht es den Nutzern, ihre Scraping-Vorgänge über eine einzige Schnittstelle einzurichten und zu verwalten, wobei die Intelligenz der KI mit der Anonymität und den Zugriffsmöglichkeiten von Proxys kombiniert wird.
- Eine durch KI gestützte automatisierte Entscheidungsfindung wird dabei helfen, die richtige Art von Proxy (Privat-Proxy vs. Rechenzentrums-Proxy) für eine Aufgabe auszuwählen und die Scraping-Vorgänge in Echtzeit auf der Grundlage der Datenqualität und der Zugänglichkeit zu optimieren.
Ethische und rechtliche Entwicklungen
- Mit dem Fortschritt der KI- und Proxy-Technologien werden sich auch die ethischen und rechtlichen Rahmenbedingungen für deren Nutzung weiterentwickeln. Es werden klarere Richtlinien und Vorschriften entstehen, die einen Ausgleich zwischen den Vorteilen des Web-Scrapings einerseits und dem Schutz der Privatsphäre sowie der Datensicherheit andererseits schaffen.
- Tools und Dienste werden um weitere Funktionen erweitert, um die Einhaltung dieser sich weiterentwickelnden Standards zu gewährleisten, wodurch ethisches Web-Scraping einfacher und transparenter wird.
Prädiktive Analytik und Echtzeit-Datenverarbeitung
- Die Kombination aus KI und fortschrittlichem Web-Scraping wird neue Möglichkeiten im Bereich der prädiktiven Analytik eröffnen und Unternehmen sowie Forschern die Möglichkeit bieten, Trends und Muster mit beispielloser Genauigkeit vorherzusagen.
- Dank der Echtzeit-Datenverarbeitungsfunktionen können Webdaten unmittelbar nach ihrer Erfassung analysiert werden, was sofortige Erkenntnisse liefert und es Unternehmen ermöglicht, datengestützte Entscheidungen schneller denn je zu treffen.
Im weiteren Verlauf werden die Synergien zwischen KI-Technologien wie ChatGPT und Proxy-Diensten wie IPBurger das Web-Scraping nicht nur effizienter gestalten, sondern es auch zu einem Werkzeug für tiefgreifendere Analysen und Erkenntnisse machen. Diese Fortschritte versprechen, neue Horizonte in der Datenerfassung zu eröffnen und bieten einen Einblick in eine Zukunft, in der die Möglichkeiten so weitreichend sind wie das Internet selbst.
Schlussfolgerung
Wir haben uns durch die komplexe Welt des Web-Scrapings bewegt und dabei die leistungsstarke Kombination aus den KI-Fähigkeiten von ChatGPT und den fortschrittlichen Proxy-Lösungen von IPBurger entdeckt. Zusammen bilden sie ein dynamisches Duo, das gängige Herausforderungen beim Scraping meistert – von CAPTCHAs und IP-Sperren bis hin zu Ratenbeschränkungen und der Navigation durch komplexe Webseiten.
Die Vorteile der Kombination von ChatGPT und IPBurger

- Effizienz und Intelligenz:ChatGPT verleiht dem Web-Scraping eine neue Dimension der Intelligenz und ermöglicht die Extraktion, Interpretation und Analyse von Daten. In Kombination mit den Proxys von IPBurger, die Anonymität und Zugriff auf das gesamte Internet bieten, wird das Scraping nicht nur möglich, sondern äußerst leistungsstark.
- Hindernisse überwinden:Durch die Synergie dieser Technologien lassen sich die Herausforderungen beim Web-Scraping mühelos bewältigen. CAPTCHAs, IP-Sperren und andere häufige Hindernisse werden damit beherrschbar, was eine reibungslosere und effizientere Datenerfassung ermöglicht.
- Anpassung an dynamische Inhalte: Dankder Fähigkeit, dynamische und JavaScript-intensive Websites zu verarbeiten und zu verstehen, gewährleistet diese Kombination, dass selbst die komplexesten Daten zugänglich sind.
Ethisch und effektiv voranschreiten
Mit Blick auf die Zukunft wird sich die Landschaft des Web-Scrapings weiterentwickeln, wobei KI- und Proxy-Technologien dabei eine Vorreiterrolle einnehmen werden. Das Potenzial ist enorm – von prädiktiver Analytik bis hin zur Echtzeit-Datenverarbeitung – und eröffnet sowohl Unternehmen als auch Forschern und Interessierten neue Möglichkeiten.
Mit großer Macht geht jedoch auch große Verantwortung einher. Die Bedeutung ethischer Vorgehensweisen beim Web-Scraping kann gar nicht hoch genug eingeschätzt werden. Wenn wir diese fortschrittlichen Technologien nutzen, ist es von entscheidender Bedeutung, sich im Internet unter Wahrung der Privatsphäre, der rechtlichen Grenzen und der Integrität der von uns erfassten Daten zu bewegen.
Wir möchten Sie dazu ermutigen, die Möglichkeiten von ChatGPT und den Web-Scraping-Proxys von IPBurger nicht nur als Werkzeuge zur Datenerfassung, sondern auch als Instrumente zur Gewinnung tieferer Einblicke und zur Förderung von Innovationen zu erkunden. Indem wir diese Technologien verantwortungsbewusst einsetzen, können wir das volle Potenzial des Internets erschließen und Daten in Wissen sowie Wissen in Handeln umwandeln.
Während wir uns auf diese spannende Zukunft zubewegen, sollten Sie bedenken, dass der Schlüssel zum erfolgreichen Web-Scraping in der Synergie aus leistungsstarken Tools, ethischen Vorgehensweisen und dem unermüdlichen Streben nach Wissen liegt. Lassen Sie uns intelligenter statt härter scrapen und den Weg für eine datengesteuerte Zukunft ebnen.