最近,无代码网络刮擦成为数据智能领域的热门话题。这是有道理的--它有可能彻底改变企业收集和分析数据的方式。
但它真的是数据智能的未来吗?
在这篇博文中,我们将深入了解无代码网络搜刮的世界,并一劳永逸地回答这个问题。我们将了解无代码网络刮擦的优势,并分析它与传统网络刮擦方法的比较。我们还将探讨这项技术对企业和研究人员的潜在应用。
因此,如果你有兴趣了解更多关于无代码网络刮擦的信息,以及它如何塑造数据智能的未来,那你就来对地方了!让我们开始吧
网络抓取的定义
Web scraping 是一种用于从网站中提取数据的技术。它是指使用程序或脚本从网站的 HTML 代码中获取特定数据,并以结构化的方式进行存储。它可用于多种目的,如收集市场调研数据、为邮件列表收集联系信息或监控产品价格。
网络搜索的历史
从互联网诞生之初,网络搜索就已经出现。它最初是一种从网站获取数据的方式,如股票价格、天气数据和其他信息。网络抓取是通过手工完成的,用户将信息从网站复制并粘贴到电子表格中。随着万维网的兴起,开始出现自动网络搜索工具,允许用户以自动化方式从多个网站收集数据。
如今,网络刮擦被用于许多方面,如收集数据用于市场研究、比较价格和编制网络索引。它还用于为机器学习应用创建大型数据集。网络搜索现在已成为互联网的重要组成部分,因为它能让企业从许多地方快速获取信息,并将其用于自己的优势领域。
什么是无代码网络抓取?
无代码网络搜刮是一种不需要编码技能或知识的网络搜刮。它使用户无需编写任何代码就能从网页中收集数据。在这种网络搜刮中,使用带有图形用户界面(GUI)的特殊工具来帮助从网站中查找和获取所需的数据。
无代码网络抓取实例
无代码网页抓取是一种快速、轻松地从网页中提取数据的方法。可以使用 Chrome 或 Firefox 等简单的网页浏览器,或使用 browse.ai 等工具来完成。
Browse.ai 是一款网络爬虫工具,可帮助用户快速、轻松地从网站中提取数据。它利用人工智能技术自动识别网页的数据结构,因此用户无需手动指定要提取的数据元素。Browse.ai 还提供高级功能来优化数据提取过程。例如,用户可以在数据提取过程中应用过滤器,以锁定特定的信息。
提取数据后,browse.ai 可以将数据导出为 CSV、JSON 和 HTML 等多种格式。将提取的数据整合到其他应用程序或服务中变得非常容易。
免费试用 browse.ai!
无代码网络抓取的优势
显而易见,事半功倍的网络扫描有其优势--让我们一起来看看吧。
节约成本
无代码网络搜索可以为公司节省时间和金钱。它消除了手动编码的需要,也减少了编码和调试所花费的时间,而这可能是昂贵的。它还减少了对专业编程技能的需求,使网络搜索过程更加高效。此外,无代码网络搜索可以自动收集和分析来自多个来源的数据,让公司节省人工成本。
提高生产力
无代码网络刮擦可以显著提高生产率,因为它消除了手动编码的需要。这样,企业就可以将精力集中在更重要的任务上,如设计和优化用户体验或开发新产品和服务。它还能让企业快速收集和分析来自许多不同来源的数据,从而帮助企业做出更好的决策并改进运行方式。
数据的准确性和质量
无代码网络刮擦可以提高数据的准确性和质量。它消除了可能导致错误和不一致的手动编码需求,使数据收集更加精确。此外,它还能提高所收集数据的质量,使企业能够根据自身需要定制网络搜刮流程。
无代码网络抓取的挑战
网络搜刮并非没有困难。以下是一些可能遇到的挑战。
潜在的安全风险
无代码网络搜刮会带来潜在的安全风险,例如可能无意中将敏感数据暴露给恶意攻击者。此外,无代码网络搜刮有可能违反网络搜刮法律法规,具体取决于司法管辖区和被搜刮的网站。
数据完整性
无代码网络搜刮容易出现数据完整性问题,如提取的数据不正确或数据丢失。此外,无代码网络搜刮可能会因搜刮过程中的错误或网页结构的变化而导致数据丢失。
数据质量
无代码网络搜刮容易造成数据质量低下,因为过程中的错误会导致数据不准确或不完整。此外,无代码网络搜刮从网页中提取复杂数据(如具有多层嵌套的数据)的能力有限。
网站未针对抓取进行优化
许多网站的设置不支持网络搜索,因此很难获得所需的数据。许多网站的设置不适合网络搜刮,因此很难获得所需的数据。尤其是具有动态内容的网站,如使用 AJAX 或 JavaScript 的网站。这些网站通常需要自定义脚本或其他工具来搜索数据。
验证码保护
现在,许多网站都使用验证码来防止网络自动搜索。验证码使用户在输入文字或解决数学问题之前无法获取数据。这很难被绕过,尤其是使用无代码网络搜刮工具。
费率限制
许多网站都对网络搜刮设置了速度限制,以防止服务器超载。使用无代码工具很难解决这个问题,因为它们通常缺乏调整搜索速度的灵活性。
无代码网络搜索代理
无代码网络搜索是一项耗时而乏味的任务。它需要专门的软件和脚本才能从网站上获取数据。因此,跟踪所有需要发送到目标网站以获取数据的请求可能会很困难。
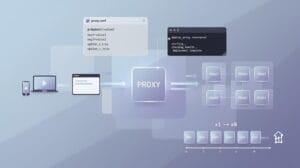
使用代理服务器有助于提高无代码网络搜索的效率。代理有助于隐藏用户的 IP 地址,使他们能够更快、更安全地发送多个请求。这意味着网站服务器对用户没有任何限制。这使得提取数据的过程更快。
此外,代理还有助于绕过目标网站设置的任何限制或速率限制。因此,用户可以根据需要提出尽可能多的请求,而不必担心网站会阻止或限制这些请求。
最后,代理服务器还能为用户提供额外的安全保护。通过隐藏 IP 地址,用户的身份可以保密,他们的数据收集活动也可以保密。这样,用户就可以从网站上获取数据,而不必担心被跟踪或监视。
快来看看 IPBurger 的网络爬虫代理服务吧。
无代码网络抓取是数据智能的未来吗?
一直以来,我们的未来都建立在解决问题、让生活更轻松的基础之上。数据智能也不例外。
采用无代码网络抓取技术
无代码网络搜刮是一项相对较新的技术,虽然许多公司已经迅速采用了这项技术,但无代码网络搜刮的前景并不明朗。与任何技术一样,它的成功与否将取决于其满足用户需求的能力。企业必须评估成本效益和从收集的数据中产生有价值见解的能力,以确定无代码网络刮擦是否是一个可行的解决方案。此外,开发新的工具和技术,使无代码网络搜刮变得更简单、更高效,将对其未来的成功发挥重要作用。
对数据科学的影响
无代码网络搜索并不一定是数据智能的未来,但它确实有可能成为数据科学家的宝贵工具。通过自动化网络搜索过程,数据科学家可以节省时间和金钱,专注于更复杂的任务。此外,无代码网络搜刮可以为数据科学家提供更准确、更及时的数据,使他们能够做出更好的决策,获得更好的洞察力。归根结底,无代码网络搜刮可以成为数据科学家的宝贵工具,但它并不是数据智能工具包中的唯一工具。
未来发展潜力
网络刮擦技术自诞生以来已经走过了漫长的道路,并且每天都在发展。它们变得比以往任何时候都更容易使用、更准确,并能提取更多的数据。随着这些工具越来越普及和强大,它们将彻底改变数据收集和分析的方式。
未来的无代码网络搜刮将可能涉及更多的自动化流程、更高的准确性以及从网页中解析非结构化数据的能力。人工智能和机器学习将用于发现数据模式,并将其归入正确的类别。此外,无代码网页搜刮框架将更擅长从社交媒体、网站 API 等多个来源提取数据。
无代码网络刮擦也可能变得更有效率和更具成本效益。这将使企业能够实时收集和分析数据,并根据获得的见解做出决策。此外,数据安全和隐私将变得越来越重要,无代码网络搜刮工具的开发将确保敏感数据的安全。
摘要
无代码网络搜刮是一种功能强大的工具,对于企业建立数据驱动型运营具有巨大潜力。通过利用无代码网络搜刮的强大功能,企业可以快速、经济高效地获取所需的数据。
尽管无代码网络爬虫技术面临诸多挑战,但其带来的好处远大于风险。IPBurger的住宅代理是企业提升网络爬虫效率和成功率的最佳途径。我们的住宅代理可为您提供可靠、安全的数据访问通道,助您轻松领先于竞争对手。
立即联系我们,了解更多关于我们的住宅代理服务,以及它们如何帮助您最大限度地提升网络爬虫工作的效率。