您是否担心数据质量?如果是的话,您应该考虑使用数据质量指标来确保数据的准确性和可靠性。
数据质量指标是帮助您衡量数据质量的工具。它们有助于您识别错误和不一致之处,并跟踪随时间推移而发生的变化。通过使用数据质量指标,您可以提高数据质量,并基于数据做出更明智的决策。
但在数据采集和情报分析中,哪些数据质量指标最具决定性作用?本文将为您揭晓答案,此外,我们还将向您展示如何通过网络爬虫获取这些指标的秘诀。
哪些数据质量指标最值得关注?
根据您处理的数据类型不同,有几种不同的数据质量指标需要重点衡量。例如,假设您正在处理客户数据。在这种情况下,需要重点衡量准确性(客户记录是否准确?)、完整性(所有必填字段是否都已填写?)以及及时性(数据是否得到及时更新?)等指标。
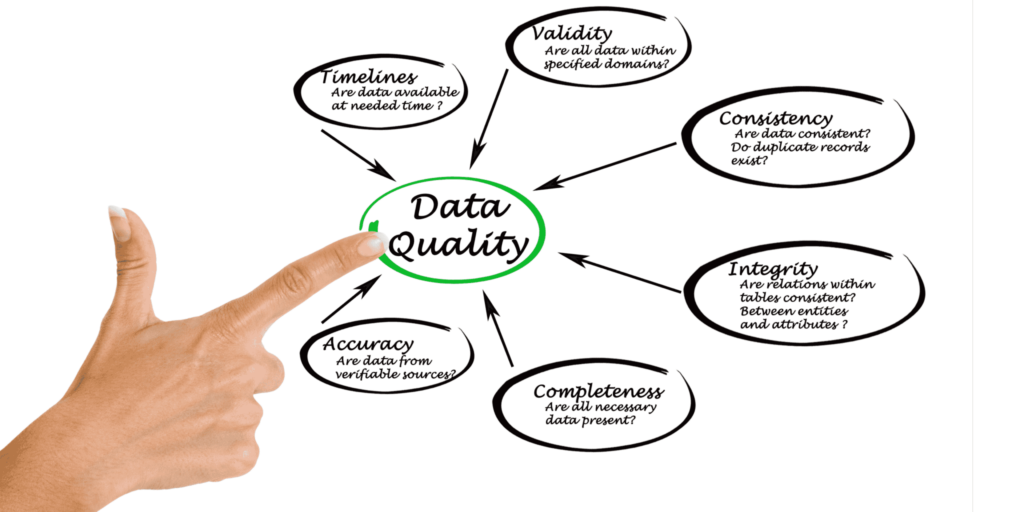
其他重要的数据质量指标包括一致性(不同数据源之间的数据是否一致?)、唯一性(是否存在重复记录?)和有效性(数据是否在正确范围内?)等。此外,跟踪数据质量问题出现的频率(数据血统和完整性)并建立一套流程以快速解决任何出现的问题也至关重要。
让我们来仔细看看它们。
准确性。
准确率是一项数据质量指标,指被正确分类或标注的数据所占的百分比。例如,如果一个数据集包含100条记录,其中90条被正确标注,那么准确率就是90%。
计算准确率的方法有几种,但最常见的是使用以下公式:
准确率 = (真阳性 + 真阴性) / 记录总数
真阳性是指被正确标记为阳性的记录,真阴性是指被正确标记为阴性的记录。
关于准确率,需要记住的是,它并不总是最重要的指标。例如,假设你要预测一名患者是否患有某种疾病。在这种情况下,你可能更关注假阳性率(即被错误判定为患病的健康患者的百分比),而不是准确率。
完备性。
另一方面,完整性指的是数据集中包含所有相关数据的程度。完整性是衡量数据质量的一项指标,用于评估本应存在的数据中有多少实际存在。数据不完整的原因多种多样,包括缺失值、错误值以及过时的值。完整性之所以重要,是因为它会影响数据的准确性和实用性。
及时性。
数据质量的一个重要方面是及时性,即数据的新鲜程度。及时性之所以重要,是因为过时的数据可能已不再具有相关性或准确性。例如,如果关于某疾病死亡人数的数据是10年前的,那么该数据可能就不准确了。
衡量及时性主要有两种方式:实时和近实时。实时数据是指在数据生成时即刻进行采集和处理的数据。近实时数据则是在数据生成后不久进行采集和处理的数据。
具体采用这两种方法中的哪一种,取决于具体应用场景。例如,如果数据用于监测疾病暴发,那么实时数据就显得尤为重要,因为这有助于根据最新信息做出决策。
一致性。
在测量数据质量时,一致性至关重要,因为它能确保不同测量结果之间的数据具有可比性。如果数据不一致,就难以进行比较和理解。许多因素都会影响数据的一致性,例如测量方法、时间以及测量所处的环境。为了确保一致性,必须采用相同的测量方法,同时进行测量,并控制其他可能影响数据的变量。
独特性。
衡量数据质量的另一种思路是从唯一性角度出发。也就是说,每条数据的唯一性如何?例如,如果你有一组包含客户姓名和地址的数据集,你可能想知道其中有多少个唯一的姓名和地址。这是一种衡量数据质量的好方法,因为如果重复项很多,可能意味着数据不够准确。
有效性。
效度是指一种测量工具在多大程度上能够准确反映其旨在测量的构念。要使一种测量工具具有效度,它首先必须具有信度。这意味着该测量工具在不同情境和不同测量中必须能产生一致的结果。如果一种测量工具不具有信度,就不可能具有效度。
有效性分为两种类型:内容有效性和构念有效性。
- 内容效度是指量表在多大程度上涵盖了其旨在测量的整个构念。例如,如果一项焦虑量表仅评估对飞行的恐惧,那么它的内容效度就不高,因为它没有涵盖焦虑的所有方面。
- 构念效度是指量表在多大程度上能够准确反映其旨在测量的理论构念。例如,一个包含对飞行、公开演讲和高度恐惧等项目的焦虑量表,其构念效度较高,因为它所测量的正是“焦虑”这一构念。
建立效度有几种方法,包括专家共识、表面效度、收敛效度、辨别效度和预测效度。
- 专家共识是指该领域的专家一致认为,某项测量工具能够很好地衡量其旨在测量的构念。
- 表面效度是指某项测量工具看起来确实测量了它本应测量的内容。
- 收敛效度是指某项测量工具与同一构念的其他测量工具之间存在相关性。
- 判别效度是指某项测量工具与其他构念的测量工具之间不存在相关性。预测效度是指某项测量工具能够预测未来结果。
世系。
数据血统是指追踪数据项在组织内部流转过程中的来源和变动情况。它是数据质量管理的重要组成部分,因为它使组织能够追溯数据项的历史,并识别其处理过程中可能出现的任何错误。数据血统可用于评估数据项的质量、识别数据处理中的潜在问题,以及确定数据质量问题的根本原因。
诚信。
在衡量数据质量时,完整性指的是数据的准确性和完整性。换言之,它衡量的是数据在多大程度上能够真实反映其本应衡量的现实世界现象。完整性高的数据既准确又完整,而完整性低的数据则不准确和/或不完整。
衡量数据完整性有多种方法,其中最常见的一种是缺失值的百分比。缺失值百分比越高,表明数据完整性越低,因为有很大一部分数据无法用于分析。 另一种常见的衡量指标是无效值的百分比。无效值是指不符合数据集要求的值(例如,如果数据集要求所有值均为正数,那么负值就会被视为无效)。无效值百分比过高同样表明数据完整性较低。
数据完整性之所以重要,是因为它会影响基于该数据进行的任何分析的准确性。不准确或不完整的数据可能会导致错误的结论。例如,如果一个数据集包含许多缺失值,那么从该数据集得出的任何结论都可能不准确。同样,如果一个数据集包含大量无效值,那么从该数据集得出的任何结论也可能不准确。
需要注意的是,数据完整性与数据质量并不相同。数据质量指的是数据的整体实用性,而数据完整性则特指数据的准确性和完整性。数据可能质量很高但完整性较低(例如,数据过时且不再准确),也可能质量较低但完整性较高(例如,数据质量虽差但仍然完整且准确)。
网页抓取与住宅代理。
企业需要跟踪许多数据质量指标,以确保其数据干净且准确。然而,手动跟踪这些指标既费时又昂贵。为了跟上节奏,使用合适的网页抓取工具来帮助采集和分析数据至关重要。
如需深入了解,请参阅《免费网页抓取工具》。
使用 IPBurger的住宅代理进行网页抓取,是获取准确数据质量指标的最佳方式。代理可让您快速、轻松地从多个来源抓取数据,提供准确、及时且值得信赖的数据。