如果你正在抓取评论、社交媒体帖子和论坛帖子来衡量客户情绪,这里有一个令人不适的事实:你收集到的数据几乎肯定存在偏差——这并非因为客户不诚实,而是因为你的抓取工具无法看到普通用户所看到的内容。
反机器人系统会屏蔽、限流并悄悄重定向那些无法信任的请求。地域限制会将整个地区的评论隐藏起来。速率限制则会切断那些包含最坦率反馈的长尾内容。等到你的情感分析模型开始运行时,它分析的已是一小部分经过筛选的数据——通常是那些在政策最宽松的平台上最引人注目、最易获取的评论。
本文旨在弥合这一差距。具体来说,就是如何设计一个数据抓取工作流,使其生成的情感分析数据具有足够的代表性,从而能够据此做出实际决策。
代表性问题
大多数情感分析流程大致如下:从Yelp或G2抓取几百条评论,通过情感分析API进行处理,然后绘制一条趋势线。这看起来很严谨,其实并非如此。
在您看到数据之前,数据就已经在悄无声息地产生了偏颇,具体表现为以下几种方式:
基于区块的采样。当某个网站将你的IP地址列入黑名单时,你收到的并非纯粹的错误信息——通常只会得到部分数据、缓存页面,或是功能受限的评论列表(页面较少、无法筛选)。最终,你的数据集往往充斥着那些容易获取的内容。
地理过滤。点评网站会积极进行本地化处理。位于弗吉尼亚州的数据中心IP所看到的Trustpilot页面,与位于柏林的家庭IP所看到的页面不同。如果对某个全球品牌的看法仅基于某个特定地区形成,那不过是披着全球外衣的区域性观点罢了。
速率限制导致的近期偏见。如果在分页过程中触发了速率限制,你的样本中近期评论的比例会过高,而用于检测实际变化的历史基准数据则会不足。
平台单一化。如果只抓取那些容易抓取的网站(面向公众的评论聚合网站),就会忽略论坛、Reddit讨论帖以及小众社区——而这些地方往往才是更真实情感的所在。
在将情感分析作为自然语言处理(NLP)问题来解决之前,先将其视为一个数据问题来解决,这正是能够推动决策的仪表盘与仅用于装饰幻灯片的仪表盘之间的区别所在。
一个能生成可用数据的工作流
对于一个由中级团队在内部开发此项目的团队,我建议按照以下步骤进行。
1. 在编写代码之前,先绘制情感分布图
列出客户实际谈论你的所有场所,然后按信号密度排序,而不是按访问便利程度排序。一张典型的地图如下:
- 评论聚合平台(G2、Trustpilot、Capterra、Yelp、Google)
- 相关应用商店(亚马逊、App Store、Play Store)
- 社交平台(X、Reddit、LinkedIn、TikTok评论区)
- 小众论坛和 Discord/Slack 社区(通常被搜索引擎收录)
- 支持工单和聊天记录(内部——别忘了这些)
如果你只处理第1项和第3项,那就意味着你只在优化问题中比较简单的那一半。
2. 选择与您的来源相匹配的工具集
每个目标都有不同的“指纹”,因此单个工具很少能将所有情况都处理得干净利落:
- 轻量级、结构化的页面 (大多数HTML代码规范的评论聚合网站):
requests+BeautifulSoup,或者如果您不想费心打理基础设施,也可以选择 ScraperAPI 或 Bright Data Web Unlocker 这样的托管 API。 - JavaScript 占比较高的页面(大多数现代评论小工具、无限滚动信息流):建议使用 Playwright 或 Puppeteer配合无头浏览器。Selenium 虽然仍然可用,但在 2026 年已显得过于臃肿。
- 提供官方 API 的平台(Reddit、具备相应访问权限的 X、YouTube):优先使用 API。这样速度更快、成本更低,也不会被封禁。只有当 API 无法返回所需数据时,才作为备选方案使用爬取。
- 高吞吐量、周期性任务:基于队列的架构(例如,一个从 Redis 读取数据的小型工作进程池)在任何情况下都比单个长期运行的脚本更胜一筹。
像 Octoparse 这样的无代码工具虽然适用于一次性数据提取,但对于需要每周重复执行的任务,脚本化流程很快就能体现出其价值。
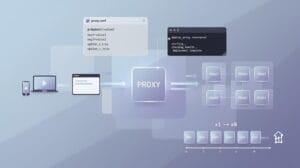
3. 确保 IP 层配置正确——大多数管道正是在这一环节悄无声息地失败的
这里有两点很重要:你使用的IP类型,以及如何轮换这些IP。
类型。数据中心IP价格低廉且速度快,但在大多数评论网站和社交平台上都被标记——它们是反机器人服务商最先屏蔽的对象。住宅IP(真正的ISP分配地址)会被当作普通用户对待,如果您的目标是获取能反映普通用户所见内容的数据,这正是关键所在。在机器人防御措施严密的平台(如Instagram、TikTok)上,移动IP的表现更为出色,但成本也更高。
轮换。“每次请求都轮换”是常见的建议,但往往是错误的选择。对于分页的评论列表,通常需要使用“固定会话”——即在整个逻辑浏览会话中保持相同的 IP 地址——因为在分页过程中频繁更换 IP 地址,看起来比固定 IP 的访客更可疑。应在会话之间进行轮换,而非在请求之间轮换。对于地理分布式抽样,应有意识地在不同国家之间进行轮换,以免数据集仅反映单一地区的状况。
这正是IPBurger住宅网络大显身手的地方——在需要时提供“粘性会话”,在地理位置至关重要时实现国家级定向——但这一原则适用于任何服务提供商:将IP行为与真实用户的浏览模式相匹配。
4. 分析前先进行标准化处理
不同来源生成的文本差异极大。Trustpilot上的评论平均为80个单词;一条推文为30个单词;而Reddit上的评论可能多达500个单词。如果将未经标准化处理的原始文本直接输入到情感分析模型中,较长的评论会从技术上而非实质上主导信号。
一个简单的归一化步骤:
- 删除固定内容(“已验证购买”、“通过手机发布”)
- 将长文本分割成句子,对每个句子进行评分,然后进行汇总
- 为数据集添加来源、地理位置和日期标签,以便对最终数据集进行切片分析
- 积极进行去重处理——重复发布的评论随处可见
5. 审慎选择情感分析模型
现成的API(如Google Cloud Natural Language、AWS Comprehend、Azure Text Analytics)对于英语和通用领域的文本来说已经足够,也可以作为入门起点。但在处理讽刺、领域专有术语和非英语文本时,它们在质量上存在不足。
如果需要进行初步分析之外的工作,您可能需要使用基于自有标注数据微调的模型,或者使用基于产品背景进行提示的开放权重大型语言模型(LLM)之一。后者如今成本已足够低廉,只需几美元即可处理数万条评论。
无论你选择哪一种,先自己挑选一小批手动标注的样本进行对比。如果该工具在100条评论中无法与人工标注结果相匹配,那么在100,000条评论中也同样无法匹配。
6. 注意偏移
情绪分析并非一次性指标。请设置流程,使其按计划定期重新运行,并追踪变化幅度,而非绝对数值。4.2分的平均评分若孤立来看毫无意义;但若该分数在六周内从4.6分呈下降趋势,则表明存在具体问题,你应立即找出原因。
最简版本
如果只能记住一点的话:有价值的情绪数据瓶颈不在于模型,而在于数据采集层。构建数据处理流程时,要确保样本具有代表性——选择正确的来源、正确的知识产权,并采用正确的轮换策略——这样即使是最基础的情绪模型,也能为你提供值得付诸行动的决策依据。如果跳过这一步,你的仪表盘就会自信满满地向你提供错误的信息。