Trong một thế giới được dẫn dắt bởi dữ liệu, tính chính xác là yếu tố quan trọng nhất. Tuy nhiên, dữ liệu kém chất lượng — bao gồm thông tin lỗi thời, sai lệch và trùng lặp — vẫn tiếp tục gây hiểu lầm cho các doanh nghiệp, dẫn đến những sai lầm tốn kém và cơ hội bị bỏ lỡ. Tại IPBurger, chúng tôi thấu hiểu tầm quan trọng của vấn đề này. Sứ mệnh của chúng tôi là đảm bảo rằng dữ liệu mà quý vị tin cậy phải dễ tiếp cận, chính xác và an toàn.
Bài viết trên blog này sẽ giúp bạn hiểu rõ thực trạng của dữ liệu kém chất lượng, chỉ ra cách nó có thể ảnh hưởng đến hoạt động của bạn, đồng thời đưa ra các giải pháp thiết thực để bảo vệ thông tin của bạn. Từ người dùng cá nhân đến các tập đoàn lớn, ai cũng sẽ được hưởng lợi từ việc áp dụng các phương pháp quản lý dữ liệu tốt hơn. Hãy cùng tìm hiểu cách bạn có thể nâng cao độ tin cậy của dữ liệu và đưa ra các quyết định sáng suốt hơn nhờ các công cụ mạnh mẽ của IPBurger.
Các loại dữ liệu sai lệch và tác động của chúng đối với hoạt động kinh doanh
Trong quá trình ra quyết định dựa trên dữ liệu, chất lượng dữ liệu có thể là yếu tố quyết định thành công hay thất bại. Hiểu rõ các loại dữ liệu kém chất lượng có thể xâm nhập vào hệ thống của bạn là bước đầu tiên để bảo vệ hoạt động kinh doanh. Dưới đây là phân tích chi tiết về các loại dữ liệu kém chất lượng phổ biến và tác động của chúng đối với doanh nghiệp của bạn:
Dữ liệu chưa đầy đủ
Dữ liệu không đầy đủ xảy ra khi một số thông tin bị thiếu trong tập dữ liệu. Điều này thường xảy ra trong quá trình thu thập dữ liệu, chẳng hạn như trích xuất dữ liệu từ web, khi không phải tất cả các chi tiết cần thiết đều được thu thập.
Tại sao dữ liệu không đầy đủ lại là một vấn đề?
- Những quyết định sai lầm: Việc đưa ra lựa chọn khi thông tin chưa đầy đủ có thể dẫn đến những quyết định sai lầm. Ví dụ, nếu thiếu những thông tin quan trọng, bạn có thể chọn một chiến lược không mang lại hiệu quả như mong đợi.
- Rủi ro tuân thủ: Trong các ngành như tài chính hay y tế, việc thiếu dữ liệu có thể dẫn đến vi phạm quy định và bị phạt tiền.
- Lãng phí nguồn lực: Việc thiếu cái nhìn toàn diện có thể khiến các doanh nghiệp sử dụng nguồn lực của mình một cách sai lầm. Bạn có thể tiêu tốn tiền bạc và thời gian vào những việc không phù hợp với nhu cầu thực tế của mình.
- Các vấn đề liên quan đến khách hàng: Dữ liệu khách hàng không đầy đủ có thể ảnh hưởng đến chất lượng dịch vụ, dẫn đến việc khách hàng không hài lòng và có thể chuyển sang sử dụng các dịch vụ khác.
Ví dụ thực tế
- Thương mại điện tử: Một cửa hàng trực tuyến có thể sử dụng kỹ thuật thu thập dữ liệu để xác định nên nhập những sản phẩm nào. Nếu dữ liệu thiếu thông tin về các xu hướng quan trọng, cửa hàng có thể sẽ nhập phải những sản phẩm mà không ai muốn mua.
- Ngành ngân hàng: Nếu một ngân hàng không có dữ liệu đầy đủ về lịch sử tín dụng của khách hàng, họ có thể cho vay đối với những người không có khả năng trả nợ, dẫn đến tổn thất tài chính.
IPBurger có thể giúp ích như thế nào
Các công cụ đại diện của IPBurger đảm bảo việc thu thập dữ liệu được thực hiện một cách kỹ lưỡng và đầy đủ:
- Proxy dành cho người dùng cá nhân: Các proxy này giúp thu thập dữ liệu đầy đủ bằng cách truy cập internet giống như một người dùng thông thường, từ đó giảm thiểu nguy cơ bỏ sót thông tin do các hạn chế của trang web.
- Proxy luân phiên: Chúng thay đổi địa chỉ IP được sử dụng trong quá trình thu thập dữ liệu, giúp tránh bị chặn hoặc thu thập dữ liệu không đầy đủ – những tình huống có thể xảy ra nếu một trang web nhận diện và hạn chế các hoạt động thu thập dữ liệu.
Dữ liệu trùng lặp
Dữ liệu trùng lặp là tình trạng cùng một thông tin xuất hiện nhiều hơn một lần trong một tập dữ liệu. Điều này thường xảy ra trong các hoạt động thu thập dữ liệu quy mô lớn như thu thập dữ liệu từ web, nơi cùng một thông tin được trích xuất lặp đi lặp lại.
Tại sao dữ liệu trùng lặp lại là một vấn đề?
- Chi phí cao hơn: Việc lưu trữ và xử lý thông tin trùng lặp tiêu tốn nhiều nguồn lực hơn, chẳng hạn như dung lượng lưu trữ và thời gian, điều này có thể dẫn đến chi phí cao hơn.
- Những nhận định sai lầm: Việc có các bản sao có thể làm sai lệch kết quả phân tích dữ liệu. Chẳng hạn, nếu một khách hàng xuất hiện hai lần, có thể sẽ tạo ra ấn tượng rằng số lượng khách hàng nhiều hơn thực tế.
- Năng suất giảm: Việc tìm kiếm và loại bỏ các bản trùng lặp đòi hỏi rất nhiều công sức, điều này có thể khiến các nhóm không thể tập trung vào các nhiệm vụ quan trọng khác.
- Khách hàng khó chịu: Nếu một doanh nghiệp có nhiều hồ sơ cho cùng một khách hàng, họ có thể gửi cùng một tin nhắn nhiều lần, điều này có thể khiến khách hàng khó chịu và làm tổn hại đến hình ảnh của doanh nghiệp.
Ví dụ thực tế
- Tiếp thị: Hãy tưởng tượng một công ty gửi cùng một quảng cáo nhiều lần cho một khách hàng chỉ vì tên của khách hàng đó đã được nhập hai lần vào cơ sở dữ liệu. Điều này có thể khiến khách hàng không hài lòng và gây lãng phí tiền bạc.
- Chăm sóc sức khỏe: Nếu hồ sơ bệnh nhân vô tình được nhập nhiều lần, các bác sĩ có thể chỉ định cùng một xét nghiệm nhiều lần, điều này không chỉ gây lãng phí mà còn có thể gây nhầm lẫn cho kế hoạch điều trị.
IPBurger hỗ trợ như thế nào
IPBurger sử dụng các công cụ đặc biệt gọi là proxy để giúp tránh những vấn đề này trong quá trình thu thập dữ liệu:
- Proxy xoay thông minh: Các proxy này thay đổi “danh tính” được sử dụng để thu thập dữ liệu mỗi lần, giúp tránh việc thu thập đi thu thập lại cùng một thông tin. Điều này rất hữu ích khi dữ liệu liên tục thay đổi.
- Tùy chọn lọc dữ liệu: IPBurger có thể thiết lập các bộ lọc để loại bỏ dữ liệu trùng lặp, đảm bảo chỉ thu thập thông tin mới và duy nhất.
Dữ liệu không chính xác
Dữ liệu không chính xác bao gồm bất kỳ thông tin nào trong tập dữ liệu mà sai, gây hiểu lầm hoặc được nhập không chính xác. Điều này có thể xảy ra do lỗi của con người, việc sử dụng thông tin cũ hoặc các sai sót trong quá trình trích xuất dữ liệu như thu thập dữ liệu từ web.
Tại sao dữ liệu không chính xác lại gây ra vấn đề?
- Quyết định sai lầm: Dữ liệu không chính xác có thể khiến các doanh nghiệp đưa ra những quyết định sai lầm. Những sai lầm này có thể gây tổn thất lớn, ảnh hưởng đến tài chính và hoạt động kinh doanh.
- Mất lòng tin của khách hàng: Nếu dữ liệu khách hàng không chính xác, các tương tác có thể bị xử lý sai, dẫn đến sự không hài lòng và mất lòng tin.
- Các vấn đề liên quan đến tuân thủ: Dữ liệu không chính xác có thể vi phạm pháp luật, đặc biệt là trong các lĩnh vực như tài chính và y tế, dẫn đến các khoản phạt rất nặng.
- Lãng phí nguồn lực: Việc khắc phục dữ liệu không chính xác có thể tốn rất nhiều thời gian và công sức, khiến nguồn lực bị chuyển hướng khỏi các hoạt động quan trọng khác.
Ví dụ trong thực tế
- Thương mại điện tử: Một cửa hàng trực tuyến có thể sử dụng dữ liệu giá cả đã lỗi thời hoặc không chính xác, dẫn đến việc hiển thị giá sai. Điều này có thể khiến khách hàng không hài lòng và làm tổn hại đến uy tín của cửa hàng.
- Ngành ngân hàng: Một ngân hàng có thể xử lý các khoản vay dựa trên thông tin tài chính không chính xác, dẫn đến việc phê duyệt cho những khách hàng thực tế không đủ điều kiện tín dụng, từ đó làm tăng nguy cơ vỡ nợ.
IPBurger giúp tránh dữ liệu không chính xác như thế nào
Các giải pháp proxy của IPBurger có thể giảm đáng kể nguy cơ thu thập dữ liệu không chính xác, đặc biệt là trong quá trình thu thập dữ liệu từ web:
- Proxy chất lượng cao: IPBurger cung cấp các proxy đáng tin cậy, đảm bảo việc thu thập dữ liệu chính xác từ các trang web. Các proxy này giúp tránh bị chặn hoặc bị dẫn dắt sai lầm bởi dữ liệu lỗi thời hoặc không chính xác.
- Truy cập dữ liệu thời gian thực: Nhờ cơ chế proxy luân phiên, IPBurger đảm bảo các doanh nghiệp có thể truy cập vào dữ liệu mới nhất và chính xác nhất hiện có, từ đó giảm thiểu rủi ro khi sử dụng thông tin lỗi thời hoặc không chính xác.
Dữ liệu không nhất quán
Dữ liệu không nhất quán xảy ra khi thông tin từ các nguồn hoặc hệ thống khác nhau trong một tổ chức không khớp nhau do sự khác biệt về cách định dạng, cấu trúc hoặc cập nhật. Sự thiếu chuẩn hóa này có thể gây khó khăn cho việc tổng hợp hoặc phân tích dữ liệu một cách chính xác.
Tại sao dữ liệu không nhất quán lại gây ra vấn đề?
- Phân tích sai lệch: Khi dữ liệu không khớp nhau, điều này có thể dẫn đến các phân tích và nhận định sai lệch, từ đó ảnh hưởng đến các quyết định chiến lược trong toàn tổ chức.
- Lãng phí nguồn lực: Việc khắc phục sự không nhất quán trong dữ liệu tốn rất nhiều thời gian và công sức, điều này có thể làm phân tán sự chú ý khỏi những nhiệm vụ quan trọng hơn.
- Các vấn đề về dịch vụ khách hàng: Nếu dữ liệu khách hàng không nhất quán, điều này có thể dẫn đến các vấn đề như gửi thông điệp mâu thuẫn hoặc các ưu đãi không chính xác, từ đó khiến khách hàng cảm thấy bực bội và làm suy giảm lòng trung thành của họ.
- Nhu cầu CNTT ngày càng tăng: Việc xử lý dữ liệu ở các định dạng khác nhau hoặc từ các nguồn khác nhau có thể gây quá tải cho các hệ thống CNTT, từ đó làm tăng chi phí và độ phức tạp.
Ví dụ về dữ liệu không nhất quán
- Bán lẻ: Hãy tưởng tượng một nhà bán lẻ sử dụng một hệ thống cho bán hàng trực tuyến và một hệ thống khác cho mua hàng tại cửa hàng. Nếu hệ thống bán hàng trực tuyến ghi ngày theo định dạng MM/DD/YYYY còn hệ thống tại cửa hàng sử dụng định dạng DD/MM/YYYY, việc phân tích hành vi khách hàng trên cả hai nền tảng sẽ trở nên phức tạp.
- Chăm sóc sức khỏe: Một bệnh viện có thể sử dụng nhiều hệ thống khác nhau để quản lý hồ sơ bệnh nhân. Nếu một hệ thống cập nhật thông tin liên lạc hoặc hồ sơ sức khỏe của bệnh nhân trong khi hệ thống kia lại không cập nhật, điều này có thể dẫn đến những vấn đề nghiêm trọng trong việc cung cấp dịch vụ chăm sóc sức khỏe.
IPBurger hỗ trợ như thế nào
Các giải pháp proxy của IPBurger có thể giải quyết những thách thức liên quan đến dữ liệu không nhất quán, đặc biệt là trong các tình huống như thu thập dữ liệu từ web (web scraping), nơi dữ liệu đến từ nhiều nguồn khác nhau:
- Thu thập dữ liệu theo tiêu chuẩn: Các máy chủ proxy của IPBurger cung cấp quyền truy cập nhất quán và đáng tin cậy vào các nguồn dữ liệu, giúp tiêu chuẩn hóa quy trình thu thập dữ liệu. Điều này giúp giảm thiểu sự biến động phát sinh do dữ liệu bị chặn hoặc lọc vì nguồn gốc địa chỉ IP của nó.
- Các tính năng tích hợp dữ liệu: Bằng cách đảm bảo việc truy cập dữ liệu được thực hiện một cách thống nhất, các máy chủ proxy của IPBurger có thể giúp tích hợp và tổng hợp dữ liệu từ nhiều nguồn khác nhau một cách liền mạch, đảm bảo tất cả dữ liệu thu thập được đều tuân thủ cùng một định dạng và tiêu chuẩn.
Hãy thử ngay các proxy thu thập dữ liệu web của IPBurger.
Dữ liệu đã lỗi thời
Dữ liệu lỗi thời bao gồm những thông tin từng chính xác nhưng đã trở nên lỗi thời do những thay đổi theo thời gian, sự biến động của điều kiện thị trường hoặc bối cảnh ngày càng phát triển. Loại dữ liệu này thường gặp trong các ngành công nghiệp có nhịp độ phát triển nhanh, nơi việc luôn cập nhật thông tin là điều tối quan trọng.
Tại sao dữ liệu lỗi thời lại gây ra vấn đề
- Các quyết định sai lầm: Việc sử dụng dữ liệu lỗi thời có thể dẫn đến những quyết định sai lầm, chẳng hạn như đầu tư vào các thị trường đang suy giảm hoặc bỏ lỡ các cơ hội mới.
- Mức độ tương tác của khách hàng giảm: Các chiến dịch tiếp thị dựa trên sở thích đã lỗi thời của người tiêu dùng có thể không phù hợp với xu hướng hiện tại, dẫn đến hiệu quả chiến dịch giảm sút và tỷ lệ chuyển đổi thấp hơn.
- Lãng phí nguồn lực: Việc vận hành dựa trên thông tin lỗi thời có thể dẫn đến việc phân bổ nguồn lực không hợp lý, làm tăng chi phí và giảm hiệu quả.
- Các vấn đề về tuân thủ: Trong các lĩnh vực chịu sự quản lý, việc sử dụng dữ liệu lỗi thời có thể vi phạm các quy định hiện hành, từ đó có thể dẫn đến các khoản phạt và các tranh chấp pháp lý.
Ví dụ trong thực tế
- Bất động sản: Một công ty môi giới sử dụng dữ liệu thị trường đã lỗi thời có thể định giá quá cao, khiến bất động sản không bán được, hoặc định giá quá thấp, dẫn đến việc mất đi nguồn doanh thu tiềm năng.
- Bán lẻ: Một nhà bán lẻ nếu chỉ dựa vào dữ liệu khách hàng cũ có thể sẽ nhập những mặt hàng không còn được ưa chuộng, dẫn đến tồn kho và phải giảm giá không cần thiết.
IPBurger hỗ trợ chống lại dữ liệu lỗi thời như thế nào
IPBurger cung cấp các công cụ giúp tránh được những rủi ro do dữ liệu lỗi thời gây ra, đặc biệt là trong các hoạt động thu thập dữ liệu từ web:
- Truy cập dữ liệu theo thời gian thực: Các proxy luân phiên của IPBurger giúp truy cập vào dữ liệu mới nhất bằng cách vượt qua các hạn chế về vị trí địa lý và tránh bị chặn địa chỉ IP. Điều này đảm bảo rằng dữ liệu thu thập được luôn cập nhật.
- Cập nhật dữ liệu thường xuyên: Việc sử dụng các công cụ của IPBurger để thường xuyên làm mới các quy trình thu thập dữ liệu giúp duy trì độ chính xác và tính kịp thời của dữ liệu theo thời gian.
Dữ liệu chưa được xác minh hoặc chưa được xác thực
Dữ liệu chưa được xác minh hoặc chưa được xác thực bao gồm những thông tin chưa được kiểm tra tính chính xác hoặc chưa được xác nhận bởi các nguồn đáng tin cậy. Loại dữ liệu này đặc biệt tiềm ẩn rủi ro vì có thể gây ra sai sót trong các quy trình phân tích và ra quyết định.
Tác động của việc sử dụng dữ liệu chưa được xác minh
- Các quyết định thiếu thận trọng: Việc dựa vào dữ liệu chưa được xác minh có thể dẫn đến những quyết định sai lầm, từ đó có thể gây ra tổn thất tài chính và những thất bại về mặt chiến lược.
- Uy tín bị tổn hại: Nếu những sai sót trong dữ liệu bị phơi bày, điều này có thể làm tổn hại đến danh tiếng của doanh nghiệp, làm suy giảm lòng tin của khách hàng và ảnh hưởng tiêu cực đến uy tín của doanh nghiệp.
- Rủi ro pháp lý và tuân thủ: Trong các lĩnh vực mà việc tuân thủ đòi hỏi dữ liệu chính xác, việc sử dụng thông tin chưa được xác minh có thể dẫn đến các hình phạt pháp lý và các vấn đề liên quan đến tuân thủ.
- Lãng phí tài nguyên: Những nỗ lực dành cho dữ liệu không chính xác có thể dẫn đến tình trạng kém hiệu quả và buộc phải chi thêm chi phí để khắc phục sai sót.
Ví dụ về dữ liệu chưa được xác minh
- Lĩnh vực tài chính: Một nhà phân tích có thể sử dụng dữ liệu từ một nguồn không đáng tin cậy để phân tích thị trường, điều này có thể dẫn đến những lời khuyên đầu tư sai lầm và gây ra tổn thất tài chính đáng kể.
- Chăm sóc sức khỏe: Các nhà nghiên cứu sử dụng dữ liệu bệnh nhân chưa được xác thực có thể đưa ra những kết luận sai lầm, từ đó có thể ảnh hưởng đến kế hoạch điều trị và kết quả điều trị của bệnh nhân.
IPBurger hỗ trợ như thế nào
Các giải pháp proxy tiên tiến của IPBurger được thiết kế nhằm nâng cao tính toàn vẹn của dữ liệu và giảm thiểu các rủi ro liên quan đến dữ liệu chưa được xác minh hoặc chưa được xác thực:
- Truy cập dữ liệu an toàn: Các máy chủ proxy của IPBurger đảm bảo việc truy cập các nguồn dữ liệu một cách an toàn và đáng tin cậy, giúp giảm thiểu rủi ro khi truy cập vào dữ liệu bị thao túng hoặc không chính xác.
- Xác minh nguồn dữ liệu: IPBurger giúp các doanh nghiệp tiếp cận một loạt các nguồn dữ liệu toàn cầu, từ đó cho phép thực hiện việc đối chiếu chéo dữ liệu để xác nhận tính chính xác và độ tin cậy của dữ liệu.
Dữ liệu không tuân thủ
Dữ liệu không tuân thủ là thông tin không tuân thủ các tiêu chuẩn pháp lý, quy định hoặc đạo đức. Điều này có thể bao gồm dữ liệu vi phạm luật bảo vệ quyền riêng tư, không đáp ứng các quy định của ngành, hoặc được thu thập hoặc sử dụng một cách không phù hợp.
Hậu quả của việc sử dụng dữ liệu không tuân thủ có thể rất nghiêm trọng và đa dạng, ảnh hưởng đến nhiều khía cạnh của hoạt động kinh doanh:
- Các hình thức xử phạt pháp lý: Việc không tuân thủ có thể dẫn đến các khoản tiền phạt đáng kể và các biện pháp pháp lý, đặc biệt là trong các ngành được quản lý chặt chẽ như tài chính và y tế, nơi các quy trình xử lý dữ liệu được quản lý nghiêm ngặt.
- Mất lòng tin của người tiêu dùng: Việc sử dụng dữ liệu vi phạm các kỳ vọng về quyền riêng tư của người tiêu dùng có thể làm tổn hại đến danh tiếng của doanh nghiệp và làm suy giảm lòng tin, dẫn đến việc mất khách hàng và cơ hội kinh doanh.
- Sự gián đoạn hoạt động: Việc giải quyết các vấn đề liên quan đến dữ liệu không tuân thủ thường đòi hỏi phải thực hiện những thay đổi đáng kể đối với các quy trình và hệ thống kinh doanh, điều này có thể gây gián đoạn hoạt động và dẫn đến chi phí phát sinh.
- Các hạn chế về tiếp cận thị trường: Trong một số trường hợp, việc không tuân thủ có thể dẫn đến các hạn chế làm giảm khả năng hoạt động của doanh nghiệp tại một số thị trường nhất định hoặc với một số khách hàng nhất định, từ đó tác động đáng kể đến tăng trưởng và lợi nhuận.
Ví dụ về dữ liệu không tuân thủ
- Tiếp thị: Một công ty sử dụng dữ liệu khách hàng cho mục đích tiếp thị mà không có sự đồng ý thích hợp, vi phạm các quy định như GDPR của Liên minh Châu Âu hoặc CCPA của California, vốn yêu cầu phải có sự đồng ý rõ ràng đối với việc sử dụng dữ liệu.
- Chăm sóc sức khỏe: Một bệnh viện chia sẻ hồ sơ y tế của bệnh nhân mà không tuân thủ các hướng dẫn của HIPAA tại Hoa Kỳ, gây rủi ro cho quyền riêng tư của bệnh nhân và khiến cơ sở y tế này có nguy cơ phải đối mặt với các vụ kiện tụng.
Để giải quyết những thách thức phức tạp liên quan đến tuân thủ quy định về dữ liệu, IPBurger cung cấp các giải pháp giúp tăng cường tính bảo mật và tính toàn vẹn trong quá trình thu thập và quản lý dữ liệu:
- Tăng cường bảo vệ dữ liệu: Các máy chủ proxy của IPBurger mã hóa lưu lượng dữ liệu, mang lại một lớp bảo mật bổ sung nhằm đảm bảo dữ liệu được xử lý tuân thủ các tiêu chuẩn quy định.
- Kiểm soát truy cập: Thông qua việc quản lý đối tượng được phép truy cập dữ liệu và vị trí truy cập, các công cụ của IPBurger giúp đảm bảo rằng chỉ nhân viên được ủy quyền mới có thể truy cập dữ liệu, từ đó giảm thiểu rủi ro liên quan đến việc xử lý dữ liệu không tuân thủ quy định.
Nguyên nhân dẫn đến dữ liệu sai lệch
Khi thu thập dữ liệu, đặc biệt là thông qua các phương pháp trích xuất dữ liệu từ web (web scraping) hoặc thu thập dữ liệu tự động, một số vấn đề có thể dẫn đến việc tích lũy dữ liệu sai lệch. Việc không sử dụng máy chủ proxy trong các quy trình này có thể làm trầm trọng thêm những vấn đề này, khiến dữ liệu trở nên kém tin cậy hơn và dễ gặp phải các vấn đề khác nhau:
Chặn địa chỉ IP và giới hạn tốc độ
Nhiều trang web có các cơ chế để phát hiện và chặn các hoạt động thu thập dữ liệu tự động, thường xác định người dùng dựa trên địa chỉ IP của họ. Nếu không sử dụng máy chủ proxy, các yêu cầu lặp đi lặp lại từ cùng một địa chỉ IP có thể nhanh chóng dẫn đến việc bị chặn, khiến việc thu thập dữ liệu không hoàn chỉnh.
Việc chặn địa chỉ IP có thể làm gián đoạn quá trình thu thập dữ liệu ngay giữa chừng, dẫn đến các bộ dữ liệu không đầy đủ và không phản ánh được toàn bộ phạm vi thông tin dự kiến thu thập.
Các hạn chế về quyền truy cập dữ liệu
Các trang web thường áp dụng các hạn chế về vị trí địa lý, theo đó việc xem hoặc truy cập dữ liệu sẽ bị giới hạn tùy theo vị trí địa lý của người dùng. Nếu không có khả năng luân phiên hoặc thay đổi địa chỉ IP thông qua các máy chủ proxy, những người thu thập dữ liệu sẽ chỉ có thể tiếp cận những thông tin có sẵn tại vị trí thực tế của họ.
Điều này có thể dẫn đến một tập dữ liệu bị lệch, không phản ánh chính xác các quan điểm toàn cầu hoặc đa dạng, đặc biệt là khi dữ liệu đó được sử dụng cho các phân tích đòi hỏi một cái nhìn toàn diện trên phạm vi toàn cầu.
Truy cập tài nguyên thống nhất
Việc truy cập tài nguyên từ cùng một địa chỉ IP có thể dẫn đến việc thu thập dữ liệu không ngẫu nhiên, có thiên vị và kém chất lượng, bởi vì máy chủ có thể cung cấp nội dung được cá nhân hóa dựa trên những sở thích được nhận định của người dùng hoặc các tương tác trước đó.
Dữ liệu được thu thập mà không qua các đại diện có thể không phản ánh thông tin một cách chính xác hoặc khách quan, dẫn đến việc phân tích dựa trên các tập dữ liệu bị sai lệch hoặc mang tính cá nhân hóa thay vì dựa trên dữ liệu khách quan.
Kiểm soát tốc độ
Một số trang web có thể giảm tốc độ truyền dữ liệu nếu phát hiện các hoạt động có dấu hiệu tự động hóa hoặc không phải do con người thực hiện, chẳng hạn như việc thu thập dữ liệu với tốc độ cao. Nếu không có các máy chủ proxy để đa dạng hóa nguồn xuất phát của các yêu cầu dữ liệu, các biện pháp kiểm soát này sẽ dễ dàng hạn chế các hoạt động thu thập dữ liệu.
Việc thu thập dữ liệu chậm chạp có thể dẫn đến dữ liệu thu thập được trở nên lỗi thời và làm tăng chi phí về thời gian và nguồn lực để thu thập thông tin cần thiết.
Rủi ro pháp lý và tuân thủ
Việc thu thập dữ liệu mà không sử dụng máy chủ proxy sẽ làm tăng nguy cơ vi phạm các quy định pháp luật về quyền riêng tư dữ liệu và thu thập dữ liệu tự động, đặc biệt là tại các khu vực pháp lý có luật bảo vệ dữ liệu nghiêm ngặt.
Việc vi phạm các quy định này có thể dẫn đến các hình thức xử phạt theo pháp luật, bao gồm tiền phạt, các biện pháp hạn chế và ảnh hưởng tiêu cực đến uy tín của công ty.
Sử dụng máy chủ proxy một cách chiến lược để giảm thiểu rủi ro
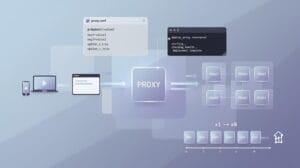
Để giảm thiểu những rủi ro này, việc sử dụng máy chủ proxy là một phương pháp chiến lược trong bất kỳ nỗ lực thu thập dữ liệu nghiêm túc nào:
- Các máy chủ proxy (chẳng hạn như máy chủ proxy dân dụng, máy chủ proxy luân phiên hoặc máy chủ proxy ẩn danh) có thể che giấu địa chỉ IP thực của người thu thập dữ liệu, từ đó giảm thiểu rủi ro bị chặn IP và giới hạn tốc độ.
- Các proxy phân bố rộng khắp về mặt địa lý giúp vượt qua các hạn chế về vị trí địa lý, đảm bảo bộ dữ liệu toàn diện và đại diện hơn.
- Việc luân phiên sử dụng các máy chủ proxy đảm bảo rằng mỗi yêu cầu đều đến từ một địa chỉ IP khác nhau, khiến các trang web khó phát hiện và hạn chế các hoạt động thu thập dữ liệu.
Bằng cách tích hợp các máy chủ proxy vào chiến lược thu thập dữ liệu, các doanh nghiệp có thể nâng cao chất lượng, tốc độ và tính hợp pháp của quy trình thu thập dữ liệu, từ đó tránh được dữ liệu sai lệch và tạo ra các bộ dữ liệu chất lượng hơn, đáng tin cậy hơn để phục vụ cho việc phân tích và ra quyết định.
Nâng cao tính toàn vẹn dữ liệu với IPBurger
Trong cuộc thảo luận này, chúng ta đã đề cập đến các loại dữ liệu kém chất lượng mà các doanh nghiệp thường gặp phải, bao gồm dữ liệu không đầy đủ, trùng lặp, không chính xác, không nhất quán, lỗi thời, chưa được xác minh và không tuân thủ quy định. Mỗi loại đều đặt ra những thách thức riêng, nhưng đồng thời cũng mang lại cơ hội để cải thiện các phương pháp quản lý dữ liệu.
Tác động của những vấn đề này có thể rất lớn, ảnh hưởng đến mọi khía cạnh, từ hiệu quả hoạt động đến quá trình ra quyết định chiến lược. Tuy nhiên, IPBurger cung cấp các giải pháp hiệu quả để khắc phục những rủi ro thường gặp này. Bằng cách tận dụng các dịch vụ proxy tiên tiến của IPBurger, các doanh nghiệp có thể đảm bảo rằng quy trình thu thập dữ liệu của họ luôn chính xác, cập nhật và tuân thủ đầy đủ các quy định liên quan.
Hãy hành động ngay: Chúng tôi khuyến khích quý vị đánh giá một cách khách quan các hệ thống quản lý dữ liệu hiện tại của mình. Quý vị có đang gặp khó khăn với những loại dữ liệu kém chất lượng như vậy không? Liệu các quy trình của quý vị có thể được cải thiện nhờ các công cụ chuyên nghiệp giúp bảo vệ và nâng cao tính toàn vẹn của dữ liệu hay không?
Hãy truy cập IPBurger để tìm hiểu cách các dịch vụ của chúng tôi có thể giúp bạn khắc phục vấn đề dữ liệu kém chất lượng. Hãy hành động ngay hôm nay để biến dữ liệu của bạn thành một tài sản chiến lược đáng tin cậy, góp phần mang lại kết quả kinh doanh tốt hơn.