Was ist Screen Scraping? Hier finden Sie Antworten auf alle Ihre Fragen.
In der heutigen Welt sind wir zunehmend auf Bildschirme angewiesen, um die Informationen zu erhalten, die wir benötigen.
Ob Smartphone, Computer oder Fernseher – wir sind es gewohnt, unsere Nachrichten, unsere Unterhaltung und sogar unsere Arbeit über einen Bildschirm zu beziehen.
Doch was geschieht, wenn die Informationen auf diesen Bildschirmen veraltet oder – schlimmer noch – falsch sind? Hier kommt das Screen-Scraping ins Spiel.
Unter „Screen Scraping“ versteht man das Extrahieren von Daten von einem Bildschirm, sei es von einer Website, einem Softwareprogramm oder sogar einer PDF-Datei. Und auch wenn es kompliziert klingen mag, ist es eigentlich ganz einfach.
Ganz gleich, ob Sie Informationen von einer Website abrufen möchten, die über keine API verfügt, oder ob Sie versuchen, Daten aus einem Softwareprogramm zu extrahieren, dessen Quellcode Ihnen nicht vorliegt – Screen Scraping kann dabei ein hilfreiches Werkzeug sein.
Was versteht man unter „Screen Scraping“?
Unter „Screen Scraping“ versteht man den Vorgang der Datenextraktion aus einer Webseite. Dies kann manuell erfolgen, wird jedoch häufig mithilfe eines Skripts oder Programms durchgeführt.
In der Informatik bezeichnet „Screen Scraping“ das Extrahieren von Daten aus einer Quelle, die nicht dafür vorgesehen ist, von einem Computer abgerufen oder gelesen zu werden. Es ähnelt dem Data Mining, doch anstatt Daten aus einer Datenbank zu extrahieren, werden sie aus einer Benutzeroberfläche, wie beispielsweise einer Webseite oder einem PDF-Dokument, gewonnen.
Screen-Scraping wird häufig genutzt, um auf Daten zuzugreifen, die über eine API nicht verfügbar sind, beispielsweise Daten von einer Website, die über keine API verfügt. Es kann auch verwendet werden, um auf Daten hinter einer Bezahlschranke oder nach einer Anmeldung zuzugreifen.
Die drei Hauptkomponenten des Screen-Scraping sind Web-Scraping, Daten-Scraping und Text-Scraping.
- Unter „Web Scraping“ versteht man den Vorgang der Extraktion von Informationen aus Websites.
- Unter „Data Scraping“ versteht man das Extrahieren von Daten aus Quellen, die nicht für den Zugriff oder die Nutzung durch Menschen bestimmt sind, wie beispielsweise Datenbanken.
- Unter „Text-Scraping“ versteht man das Extrahieren von Text aus Quellen, die nicht für den Zugriff oder die Nutzung durch Menschen vorgesehen sind, wie beispielsweise E-Mails.
Screen Scraping vs. Data Scraping: drei wesentliche Unterschiede.
1. Beim Screen Scraping werden Daten aus dem HTML-Code einer Website extrahiert. Im Gegensatz dazu bezeichnet der Begriff „Data Scraping“ die Extraktion von Daten aus beliebigen Quellen, darunter Websites, Datenbanken und Dokumente.
2. Das Screen-Scraping erfolgt in der Regel manuell, während das Data-Scraping mithilfe von Tools und Software automatisch durchgeführt werden kann.
3. Beim „Screen Scraping“ können Daten von einer Website extrahiert werden, die nicht für den Zugriff oder die Nutzung durch den Scraper vorgesehen sind, während beim „Data Scraping“ Daten aus jeder öffentlich zugänglichen Quelle extrahiert werden können.
Screen-Scraping vs. Web-Scraping.
Es besteht ein feiner Unterschied zwischen Web-Scraping und Screen-Scraping. Unter Web-Scraping versteht man das Extrahieren von Daten aus Websites, während Screen-Scraping das Extrahieren von Daten vom Bildschirm eines Computers bezeichnet. Web-Scraping ist im Allgemeinen weiter verbreitet und bezieht sich auf das Extrahieren von Daten aus Websites.
Warum ist Screen Scraping nützlich?
Screen-Scraping kann hilfreich sein, wenn es keine andere Möglichkeit gibt, auf die benötigten Daten zuzugreifen. So kann Screen-Scraping beispielsweise eingesetzt werden, um Daten zu erheben, wenn eine Website über keine API oder andere Möglichkeiten zum Zugriff auf ihre Daten verfügt.
Wie funktioniert Screen Scraping?
Unter „Screen Scraping“ versteht man den Vorgang der Datenextraktion aus einer Website. Dies kann manuell erfolgen, indem Daten von einer Website kopiert und in eine Tabellenkalkulation oder Datenbank eingefügt werden, oder automatisch mithilfe eines Screen-Scraping-Tools.
Welche gängigen Tools für das Screen-Scraping gibt es?
Es gibt zahlreiche gängige Screen-Scraping-Tools, darunter Web-Scraping-Dienste wie Scrapy und import.io sowie Browser-Erweiterungen wie Data Miner und Web Scraper.
Wie lässt sich Screen-Scraping auf ethische Weise einsetzen?
Es gibt einige Möglichkeiten, Screen-Scraping auf ethische Weise einzusetzen:
- Nutzen Sie diese Methode, um öffentlich zugängliche Daten zu erfassen, auf die Sie ein Zugriffsrecht haben: Mithilfe von Screen Scraping lassen sich Daten erfassen, die der Öffentlichkeit zugänglich sind, wie beispielsweise Daten von einer öffentlichen Website. Diese Art des Data Scraping ist rechtmäßig und ethisch vertretbar.
- Nutzen Sie diese Methode, um Daten für den persönlichen Gebrauch zu sammeln: Screen Scraping kann auch für den persönlichen Gebrauch genutzt werden. Sie könnten beispielsweise Screen Scraping einsetzen, um Daten über ein Produkt zu sammeln, dessen Kauf Sie in Erwägung ziehen. Diese Art des Data Scraping ist rechtmäßig und ethisch vertretbar.
- Nutzen Sie diese Methode zur Datenerhebung für Forschungszwecke: Screen-Scraping kann zur Erhebung von Daten für Forschungszwecke eingesetzt werden. So könnten Sie beispielsweise mithilfe von Screen-Scraping Daten darüber sammeln, wie eine Website gestaltet ist oder wie Nutzer mit ihr interagieren. Diese Art des Data-Scraping ist rechtmäßig und ethisch vertretbar.
Inwiefern kann Screen Scraping auf unethische Weise eingesetzt werden?
Screen-Scraping kann in unethischer Weise genutzt werden, indem Daten ohne die Zustimmung des Eigentümers extrahiert werden, indem automatisierte Verfahren eingesetzt werden, um Daten zu häufig von einer Website abzufragen – was zu einer Überlastung der Website führen kann – oder indem urheberrechtlich geschützte Daten abgegriffen werden.
Welche gängigen Rechtsvorschriften zum Screen Scraping gibt es?
Zu den gängigen Gesetzen zum Thema „Screen Scraping“ zählen der „Computer Fraud and Abuse Act“, der „Digital Millennium Copyright Act“ und der „Can-Spam Act“.
Das Gesetz gegen Computerbetrug und -missbrauch (Computer Fraud and Abuse Act, CFAA) ist ein Bundesgesetz, das den unbefugten Zugriff auf einen Computer oder ein Computernetzwerk verbietet. Das CFAA verbietet zudem die unbefugte Nutzung von Computern oder Netzwerken zur Begehung von Betrug oder anderen Straftaten. Das CFAA sieht sowohl strafrechtliche als auch zivilrechtliche Sanktionen vor.
Der Digital Millennium Copyright Act ( DMCA) ist ein US-amerikanisches Urheberrechtsgesetz, das einen Rahmen für den Urheberrechtsschutz im digitalen Zeitalter schafft. Es wurde am 28. Oktober 1998 verabschiedet und trat am 28. Oktober 2000 in Kraft.
Der DMCA änderte Titel 17 des United States Code, der das Urheberrecht in den Vereinigten Staaten regelt. Mit dem DMCA wurde eine neue Form des Urheberrechtsschutzes für Online-Diensteanbieter geschaffen, die als „Safe Harbour“ bezeichnet wird.
Die „Safe-Harbour“-Regelung schützt Dienstleister vor einer Haftung wegen Urheberrechtsverletzungen, sofern sie bestimmte Maßnahmen ergreifen, um Verstöße auf ihren Systemen zu verhindern oder deren Auswirkungen zu mindern.
Um Anspruch auf den „Safe-Harbor“-Schutz zu haben, müssen Dienstanbieter einen Beauftragten benennen, der Mitteilungen über behauptete Rechtsverletzungen entgegennimmt, und eine Richtlinie zur Kündigung der Konten von Wiederholungstätern verabschieden und umsetzen.
Mit dem DMCA wurde zudem ein neuer Straftatbestand namens „Umgehung von Urheberrechtsschutzsystemen“ geschaffen, der die Umgehung technischer Maßnahmen verbietet, die den Zugang zu urheberrechtlich geschützten Werken regeln.
Der DMCA hat die Herstellung, den Verkauf oder den Vertrieb von Geräten oder Diensten, die dazu bestimmt sind, Urheberrechtsschutzsysteme zu umgehen, für rechtswidrig erklärt.
Das DMCA ist von verschiedenen Gruppen kritisiert worden, darunter Fachleute aus dem Bereich der Bibliotheks- und Informationswissenschaft, die argumentieren, dass es den Zugang zu Informationen beeinträchtigt habe.
Der CAN-SPAM Act ist ein Gesetz, das die Regeln für kommerzielle E-Mails festlegt, Anforderungen an kommerzielle Nachrichten definiert, Kunden das Recht einräumt, den Erhalt von E-Mails von Ihnen zu unterbinden, und strenge Strafen für Verstöße vorsieht.
So verhindern Sie Screen-Scraping.
Es gibt keine hundertprozentig sichere Methode, um Screen-Scraping zu verhindern, doch es lassen sich einige Maßnahmen ergreifen, um dies zu erschweren:
1. Verwenden Sie CAPTCHAs
CAPTCHAs (Completely Automated Public Turing tests to tell Computers and Humans Apart) sind Frage-Antwort-Tests, mit denen überprüft werden kann, ob ein Nutzer ein Mensch ist. Sie bestehen in der Regel aus einem verzerrten Textbild, das ein Mensch problemlos lesen kann, ein Computer jedoch nicht.
2. Verwenden Sie ein Anmeldesystem
Ein Anmeldesystem kann genutzt werden, um den Zugriff auf Inhalte zu beschränken, die hinter einer Bezahlschranke liegen oder anderweitig ausschließlich für registrierte Nutzer bestimmt sind.
3. Verwenden Sie einen Honeypot
Ein Honeypot ist eine Information, die vor den Nutzern verborgen bleibt, von Bots jedoch leicht aufgespürt wird. Dadurch können Bots dazu verleitet werden, sich zu entlarven, woraufhin sie blockiert werden können.
4. Verwenden Sie eine Ratenbegrenzung
Die Ratenbegrenzung ist eine Maßnahme, mit der die Datenverkehrsmenge von einer einzelnen IP-Adresse begrenzt wird. Dies kann dazu dienen, zu verhindern, dass Bots innerhalb kurzer Zeit zu viele Anfragen stellen.
Was sind einige gängige bewährte Vorgehensweisen beim Screen Scraping?
- Verwenden Sie ein spezielles Screen-Scraping-Tool: Ein Screen-Scraping-Tool dient dazu, Daten aus Webseiten zu extrahieren. Es verfügt über Funktionen, die den Vorgang vereinfachen und präziser gestalten, wie beispielsweise die Verarbeitung von AJAX und JavaScript sowie das automatische Ausfüllen von Formularfeldern.
- Verwenden Sie Quelldaten von höchster Qualität: Die Quelldaten sollten korrekt formatiert und genau sein. Vermeiden Sie die Verwendung von Daten aus Websites, die bekanntermaßen Fehler enthalten, oder aus Websites, die häufig aktualisiert werden (wie beispielsweise Wetter-Websites).
- Testen, testen, testen: Testen Sie Ihren Screen-Scraping-Code stets anhand einer kleinen Datenstichprobe, um sicherzustellen, dass er wie erwartet funktioniert.
- Proxy-Rotation: Der einfachste Weg, IP-Sperren zu vermeiden, ist die Verwendung rotierender Privat-Proxys.
- Gehen Sie beim Datenscraping respektvoll vor: Achten Sie darauf, die Nutzungsbedingungen und die Richtlinien zum Datenscraping der Website einzuhalten.
Was sind einige typische Herausforderungen beim Screen Scraping?
Zu den häufigsten Herausforderungen beim Screen Scraping gehören:
- Erfassung von Daten, die in einem nicht standardmäßigen Format angezeigt werden
- Umgang mit dynamisch generierten Seiten
- Umgang mit Authentifizierung und Cookies
- Vermeiden, von Webservern blockiert zu werden
So umgehen Sie IP-Sperren von Webservern.
Es gibt drei Möglichkeiten, um zu verhindern, dass man beim Screen-Scraping von Webservern blockiert wird: die Nutzung eines VPN, eines Proxy-Servers oder eines TOR-Browsers.
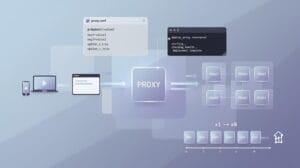
Die Verwendung eines Proxys, um eine Sperrung durch Webserver zu vermeiden, ist eine gängige Methode. Mithilfe eines Proxys können Sie Ihren Datenverkehr über eine andere IP-Adresse leiten, was dazu beitragen kann, eine Sperrung durch Webserver zu vermeiden.
Beim Screen-Scraping ist es wichtig, wechselnde Residential-Proxys zu verwenden, um nicht erkannt und blockiert zu werden. Durch die Verwendung unterschiedlicher Proxys für jede Anfrage wird es für Websites schwieriger, Ihre Aktivitäten nachzuverfolgen und zu blockieren. Darüber hinaus stellt die Verwendung von Residential-Proxys sicher, dass Ihre IP-Adresse nicht auf eine Sperrliste gesetzt wird.